Oh My Opcode przekształca OpenCode w harnes do kodowania wieloagentowego: orchestrator deleguje zadania do specjalistycznych agentów działających równolegle.
Test modelu OpenCode LLM — statystyki kodowania i dokładności
Przetestowałem, jak OpenCode współpracuje z kilkoma lokalnie hostowanymi modelami LLM na Ollama i llama.cpp, a dla porównania dodałem kilka darmowych modeli z OpenCode Zen.
OpenHands to platform open-source, agnostyczna wobec modeli, służąca dla agentów oprogramowania napędzanych przez AI.
Pozwala ona agentowi zachowywać się bardziej jak partner programistyczny, a nie jak proste narzędzie do autouzupełniania.
Uruchom własny serwer z API zgodnym z OpenAI przy użyciu LocalAI w kilka minut.
LocalAI to serwer inferencji typu self-hosted i first-local zaprojektowany tak, aby zachowywał się jak kompatybilny zamiennik API OpenAI do uruchamiania obciążeń AI na Twoim własnym sprzęcie (laptop, stacja robocza lub serwer lokalny).
Inferencja LLM wygląda jak „kolejny API" – dopóki nie pojawią się skoki opóźnień, kolejki nie zaczną się zalegać, a Twoje karty GPU nie będą zużywać 95% pamięci bez wyraźnego wyjaśnienia.
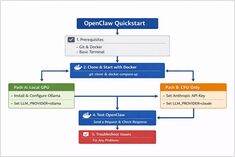
OpenClaw to samodzielnie hostowany asystent AI zaprojektowany do działania z lokalnymi środowiskami uruchomieniowymi LLM, takimi jak Ollama, lub z modelami opartymi na chmurze, takimi jak Claude Sonnet.
AWS S3 pozostaje „domyślną” bazą do przechowywania obiektów: jest w pełni zarządzane, silnie spójne i zaprojektowane z myślą o ekstremalnie wysokiej trwałości i dostępności. Garage i MinIO to alternatywy z samodzielnym hostowaniem, zgodne z S3: Garage jest zaprojektowany dla lekkich, geograficznie rozproszonych małych i średnich klastrów, podczas gdy MinIO kładzie nacisk na szerokie pokrycie funkcji API S3 i wysoką wydajność w większych wdrożeniach.
Garage to open-source, samowystarczalny, S3-zgodny system magazynowania obiektów zaprojektowany do małych i średnich wdrożeń, z silnym naciskiem na odporność i georozproszenie.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Kontroluj dane i modele za pomocą własnych, lokalnie hostowanych LLM
Hositing własny LLM daje kontrolę nad danymi, modelami i wnioskowaniem – jest to praktyczna droga do sukwerenności AI dla zespołów, przedsiębiorstw i krajów.
Uruchamianie dużych modeli językowych lokalnie zapewnia prywatność, możliwość pracy offline i zerowe koszty API.
Ten benchmark dokładnie pokazuje, czego można oczekiwać od 14 popularnych
LLM na Ollama na karcie RTX 4080.
Ekosystem Go nadal rozwija się dzięki innowacyjnym projektom obejmującym narzędzia AI, aplikacje samozhostowane oraz infrastrukturę dla programistów. Niniejszy przegląd analizuje najbardziej popularne repozytoria Go na GitHub w tym miesiącu.
Instalacja, wdrażanie i optymalizacja vLLM w 2026 roku
vLLM to silnik inferencji i serwowania o wysokiej przepustowości i wydajnym zarządzaniu pamięcią dla dużych modeli językowych (LLM), opracowany przez Sky Computing Lab na UC Berkeley.