OpenAI

llama.swap: szybki start z przełącznikiem modeli dla lokalnych LLM zgodnych z OpenAI

llama.swap: szybki start z przełącznikiem modeli dla lokalnych LLM zgodnych z OpenAI

Gorąca wymiana lokalnych LLMów bez zmian w klientach.

Wkrótce będziesz jugglingiem w vLLM, llama.cpp i wielu innych — każdy stack na własnym porcie. Wszystkie komponenty dół wciąż wymagają jednego /v1 bazowego adresu URL; inaczej będziesz w nieskończoność przesuwać porty, profile i jednorazowe skrypty. llama-swap to /v1 proxy umieszczane przed tymi stackami.

Szybki start z llama.cpp: CLI i serwer

Szybki start z llama.cpp: CLI i serwer

Uruchamiaj modele GGUF za pomocą CLI i serwera

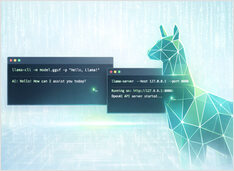
llama.cpp to silnik inferencji w językach C/C++ dla modeli GGUF: llama-cli do interaktywnego czatu, llama-completion do skryptowych promptów oraz llama-server dla kompatybilnego z OpenAI interfejsu API HTTP.