Llamacpp

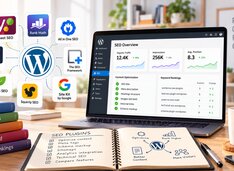
Porównanie wtyczek SEO do WordPressa: od Yoasta po Local AI

Porównanie wtyczek SEO do WordPressa: od Yoasta po Local AI

Wtyczki SEO do WordPressa, Yoast i lokalne AI

Rozszerzenia WordPress do SEO dodają warstwę metadanych, map witryny, schematów i warstwę AI nad rdzeniem WordPressa, a w 2026 roku warstwa ta obejmuje rozszerzenia, które wykonują wnioskowanie (inference) na własnym sprzęcie.
llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

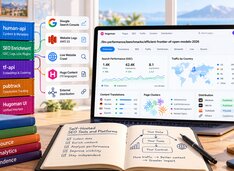
llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

„Gdy llama-server wyprzedza Ollamę”

Ollama i llama.cpp są często porównywane tak, jakby były rywalizującymi silnikami inferencji. Rzeczywisty wybór polega na decyzji między zarządzaną usługą modeli a zestawem narzędzi, który obsługujesz bezpośrednio.

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

Dlaczego kontekst 128K zawodzi na 16 GB

Model może reklamować okno kontekstowe 128K i mimo to zawiedzie przy 40K tokenach na karcie GPU 16 GB. Architektoniczny limit nigdy nie gwarantował, że wagi, cache KV, bufora obliczeniowe i kompozytor pulpitu zmieszczą się jednocześnie na Twojej karcie.