LLM Hosting

llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

„Gdy llama-server wyprzedza Ollamę”

Ollama i llama.cpp są często porównywane tak, jakby były rywalizującymi silnikami inferencji. Rzeczywisty wybór polega na decyzji między zarządzaną usługą modeli a zestawem narzędzi, który obsługujesz bezpośrednio.
Grawitacja danych: prawdziwa koszt strategii API-first w sztucznej inteligencji

Grawitacja danych: prawdziwa koszt strategii API-first w sztucznej inteligencji

Dlaczego Twój stos AI staje się co miesiąc bardziej kleisty.

Każde wywołanie API wydaje się prostą transakcją – dopóki nie gromadzi się ich na tyle dużo, że dane do dostrojenia, zestawy do ewaluacji oraz schematy narzędzi nie zaczynają być ukształtowane wokół jednego dostawcy, a zmiana dostawcy przestaje być jedynie zmianą routingu.

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Kiedy przejść z Ollamy na vLLM

Ollama to jeden z najprostszych sposobów na uruchomienie lokalnego modelu językowego, jednak wygoda może ukrywać moment, w którym lokalny eksperyment staje się współdzieloną usługą inferencyjną wymagającą lepszego planowania zadań i obserwowalności.

Usuń wszystkie modele routera llama.cpp bez restartowania

Usuń wszystkie modele routera llama.cpp bez restartowania

Darmowa pamięć VRAM bez zabijania llama-server.

Tryb routera w llama.cpp to jedna z najbardziej przydatnych zmian wprowadzonych do llama-server w ciągu ostatnich lat. Wreszcie daje lokalnym operatorom modeli LLM coś w rodzaju zarządzania modelami, do którego są przyzwyczajeni z Ollama, jednocześnie zachowując surową wydajność i kontrolę na niskim poziomie, która sprawia, że warto korzystać z llama.cpp w pierwszej kolejności.

Szybki start Vane (Perplexica 2.0) z Ollama i llama.cpp

Szybki start Vane (Perplexica 2.0) z Ollama i llama.cpp

Własna wyszukiwarka AI z lokalnymi modelami LLM

Vane to jeden z bardziej pragmatycznych projektów w przestrzeni „AI-search z cytatami”: samodzielnie hostowany silnik odpowiedzi, który łączy wyszukiwanie na żywej sieci z modelami LLM (lokalnymi lub w chmurze), a jednocześnie pozwala zachować pełną kontrolę nad całym stackiem.

Ollama w Docker Compose z GPU i trwałym magazynowaniem modeli

Ollama w Docker Compose z GPU i trwałym magazynowaniem modeli

Serwer Ollama w stylu Compose-first z obsługą GPU i trwałym zapisem danych.

Ollama świetnie działa na “gołym” metalu (bez warstwy wirtualizacji). Staje się jeszcze ciekawszy, gdy traktujesz go jak usługę: stabilny punkt końcowy, przypięte wersje, trwałe przechowywanie danych oraz GPU, które jest dostępne, lub go nie ma.

llama.swap: szybki start z przełącznikiem modeli dla lokalnych LLM zgodnych z OpenAI

llama.swap: szybki start z przełącznikiem modeli dla lokalnych LLM zgodnych z OpenAI

Gorąca wymiana lokalnych LLMów bez zmian w klientach.

Wkrótce będziesz jugglingiem w vLLM, llama.cpp i wielu innych — każdy stack na własnym porcie. Wszystkie komponenty dół wciąż wymagają jednego /v1 bazowego adresu URL; inaczej będziesz w nieskończoność przesuwać porty, profile i jednorazowe skrypty. llama-swap to /v1 proxy umieszczane przed tymi stackami.

LocalAI QuickStart: Uruchamianie lokalnie modeli LLM zgodnych z OpenAI

LocalAI QuickStart: Uruchamianie lokalnie modeli LLM zgodnych z OpenAI

Uruchom własny serwer z API zgodnym z OpenAI przy użyciu LocalAI w kilka minut.

LocalAI to serwer inferencji typu self-hosted i first-local zaprojektowany tak, aby zachowywał się jak kompatybilny zamiennik API OpenAI do uruchamiania obciążeń AI na Twoim własnym sprzęcie (laptop, stacja robocza lub serwer lokalny).

Szybki start z llama.cpp: CLI i serwer

Szybki start z llama.cpp: CLI i serwer

Uruchamiaj modele GGUF za pomocą CLI i serwera

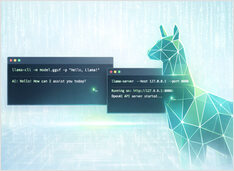
llama.cpp to silnik inferencji w językach C/C++ dla modeli GGUF: llama-cli do interaktywnego czatu, llama-completion do skryptowych promptów oraz llama-server dla kompatybilnego z OpenAI interfejsu API HTTP.