
Open WebUI: interfejs LLM do samodzielnej hostowania
Self-hostowana alternatywa dla ChatGPT dla lokalnych LLM-ów
Open WebUI to potężna, rozszerzalna i bogata w funkcje, samodzielnie hostowana przeglądarkowa aplikacja do interakcji z dużymi modelami językowymi.
Obsługuje Ollama oraz dowolne kompatybilne z OpenAI API, przenosząc znajome doświadczenie ChatGPT na Twoją infrastrukturę z pełną prywatnością, możliwością pracy offline i funkcjami klasy enterprise. W celu szerszego porównania lokalnych i chmurowych backendów LLM — Ollama, vLLM, Docker Model Runner, LocalAI i dostawców chmurowych — zobacz Hosting LLM: Porównanie infrastruktury lokalnej, samodzielnie hostowanej i chmurowej.
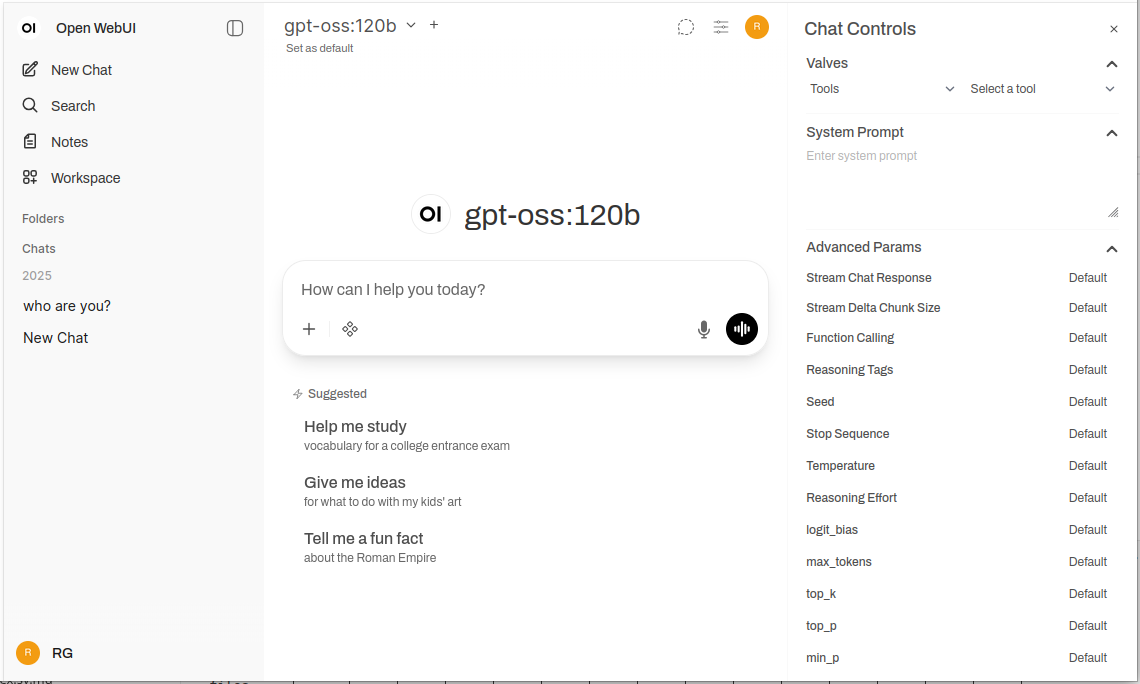
Czym jest Open WebUI?
Open WebUI to otwartoźródłowa, samodzielnie hostowana aplikacja webowa, która zapewnia nowoczesny interfejs czatu do interakcji z dużymi modelami językowymi. W przeciwieństwie do chmurowych usług AI, Open WebUI działa w całości na Twojej infrastrukturze, dając Ci pełną kontrolę nad danymi, rozmowami i wyborem modeli.
Choć Open WebUI jest często używany z Ollama (i bywa nieformalnie nazywany „Ollama WebUI”), jest w rzeczywistości platformą agnostyczną wobec backendu. Może łączyć się z API Ollama do lokalnego uruchamiania modeli, ale obsługuje również dowolny endpoint kompatybilny z OpenAI — w tym vLLM, LocalAI, LM Studio, Text Generation WebUI, a nawet dostawców chmurowych. Ta elastyczność sprawia, że Open WebUI jest kompleksowym rozwiązaniem wspierającym wiele backendów, RAG (Generowanie Wzbogacone Odbiorem) dla czatu z dokumentami, uwierzytelnianie wieloużytkownikowe, możliwości głosowe oraz rozbudowane opcje dostosowywania. Niezależnie od tego, czy uruchamiasz modele na laptopie, domowym serwerze, czy klastrze Kubernetes, Open WebUI skaluje się do spełnienia Twoich potrzeb.
Dlaczego warto wybrać Open WebUI?
Prywatność przede wszystkim: Wszystkie dane pozostają na Twojej infrastrukturze — żadne rozmowy, dokumenty ani zapytania nie opuszczają Twojej sieci, chyba że świadomie skonfigurujesz zewnętrzne API.
Możliwość pracy offline: Idealny dla środowisk odseparowanych (air-gapped), ograniczonych sieci lub sytuacji, w których dostęp do internetu jest niewiarygodny lub zabroniony. W połączeniu z lokalnie działającymi modelami za pośrednictwem Ollama lub vLLM osiągasz pełną niezależność od usług chmurowych.
Bogactwo funkcji: Mimo bycia samodzielnie hostowanym, Open WebUI rywalizuje z komercyjnymi ofertami, oferując upload dokumentów i RAG, historię rozmów z wyszukiwaniem semantycznym, szablony i udostępnianie zapytań, zarządzanie modelami, wejście/wyjście głosowe, responsywny design mobilny oraz motywy ciemny/jasny.
Wsparcie wielu użytkowników: Wbudowany system uwierzytelniania z kontrolą dostępu opartą na rolach (administrator, użytkownik, oczekujący), pulpit zarządzania użytkownikami, izolację rozmów oraz wspólną bibliotekę zapytań i modeli dla zespołów.
Szybki przewodnik po instalacji
Najszybszym sposobem na rozpoczęcie pracy z Open WebUI jest użycie Dockera. Ta sekcja obejmuje najczęstsze scenariusze wdrożenia.
Podstawowa instalacja (Połączenie z istniejącym Ollama)
Jeśli masz już uruchomione Ollama na swoim systemie, użyj tego polecenia:
docker run -d \
  -p 3000:8080 \
  -v open-webui:/app/backend/data \
  --name open-webui \
  --restart always \
  ghcr.io/open-webui/open-webui:main
Uruchamia to Open WebUI na porcie 3000, utrwalając dane w wolumenie Dockera. Dostęp do niego uzyskasz pod adresem http://localhost:3000.
Instalacja zintegrowana (Open WebUI + Ollama)
Dla kompletnego ustawienia typu „all-in-one” z Ollama:
docker run -d \
  -p 3000:8080 \
  --gpus all \
  -v ollama:/root/.ollama \
  -v open-webui:/app/backend/data \
  --name open-webui \
  --restart always \
  ghcr.io/open-webui/open-webui:ollama
Flaga --gpus all włącza dostęp do GPU dla szybszego wnioskowania. Omitnij ją, jeśli korzystasz wyłącznie z CPU.
Ustawienie Docker Compose
Dla wdrożeń produkcyjnych Docker Compose zapewnia lepszą utrzymywalność:
version: '3.8'

services:
  ollama:
    image: ollama/ollama:latest
    ports:
      - "11434:11434"
    volumes:
      - ollama:/root/.ollama
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    ports:
      - "3000:8080"
    environment:
      - OLLAMA_BASE_URL=http://ollama:11434
    volumes:
      - open-webui:/app/backend/data
    depends_on:
      - ollama
    restart: always

volumes:
  ollama:
  open-webui:
Rozpocznij wdrażanie za pomocą docker-compose up -d.
Wdrożenie na Kubernetes
Dla wdrożeń enterprise Open WebUI oferuje wykresy Helm:
helm repo add open-webui https://helm.openwebui.com/
helm repo update
helm install open-webui open-webui/open-webui \
  --set ollama.enabled=true \
  --set ingress.enabled=true \
  --set ingress.host=chat.yourdomain.com
Tworzy to gotowe do produkcji wdrożenie z trwałym przechowywaniem danych, kontrolami stanu zdrowia i opcjonalną konfiguracją ingress.
Głębokie przeanalizowanie kluczowych funkcji
RAG i czat z dokumentami
Implementacja RAG w Open WebUI pozwala na przesyłanie dokumentów i odwoływanie się do nich przez model w rozmowach. System automatycznie dzieli dokumenty na fragmenty, generuje osadzenia (embeddings), przechowuje je w bazie wektorowej i odzyskuje odpowiedni kontekst, gdy zadajesz pytania.
Obsługiwane formaty: PDF, DOCX, TXT, Markdown, CSV i inne dzięki wbudowanym analizatorom.
Zastosowanie: Kliknij przycisk ‘+’ w czacie, wybierz ‘Wgraj pliki’, wybierz swoje dokumenty i zacznij zadawać pytania. Model będzie cytował istotne fragmenty i numery stron w swoich odpowiedziach.
Konfiguracja: Możesz dostosować rozmiar fragmentu (chunk), nakładanie (overlap), model osadzeń i parametry odzyskiwania w ustawieniach administracyjnych dla optymalnej wydajności z Twoimi typami dokumentów.
Wieloużytkownikowe uwierzytelnianie i zarządzanie
Open WebUI zawiera kompletny system uwierzytelniania odpowiedni dla zespołów i organizacji:
- Uwierzytelnianie lokalne: Nazwa użytkownika/hasło z bezpiecznym hashowaniem haseł
- Integracja OAuth/OIDC: Połączenie z istniejącymi dostawcami tożsamości (Google, GitHub, Keycloak itp.)
- LDAP/Active Directory: Integracja z katalogami enterprise
- Dostęp oparty na rolach: Administrator (pełna kontrola), Użytkownik (dostęp standardowy), Oczekujący (wymaga zatwierdzenia)
Administratorzy mogą zarządzać użytkownikami, monitorować wykorzystanie, konfigurować dostęp do modeli per użytkownik/grupa i ustawiać polityki retencji rozmów.
Wejście i wyjście głosowe
Wbudowane wsparcie dla interakcji głosowej czyni Open WebUI dostępnym i wygodnym:
- Rozpoznawanie mowy (Speech-to-text): Używa Web Speech API lub skonfigurowanych zewnętrznych usług STT
- Syntezator mowy (Text-to-speech): Obsługiwane są silniki TTS (oparte na przeglądarce, Coqui TTS, ElevenLabs itp.)
- Wspierane języki: Działa w wielu językach, w zależności od konfiguracji TTS/STT
Narzędzia do inżynierii promptów
Open WebUI dostarcza solidnych narzędzi do zarządzania promptami:
- Biblioteka promptów: Zapisz często używane prompty jako szablony
- Zmienne i placeholdery: Twórz wielokrotno użytku prompty z dynamiczną zawartością
- Udostępnianie promptów: Udostępniaj skuteczne prompty swojemu zespołowi
- Wersjonowanie promptów: Śledź zmiany i ulepszenia w czasie
Zarządzanie modelami
Łatwe przełączanie i zarządzanie modelami przez interfejs:
- Katalog modeli: Przeglądaj i pobieraj modele bezpośrednio z biblioteki Ollama
- Modele niestandardowe: Przesyłaj i konfigurowaj niestandardowe modele GGUF
- Parametry modeli: Dostosuj temperaturę, top-p, długość kontekstu i inne parametry próbkowania per rozmowa
- Metadane modeli: Wyświetlaj szczegóły modelu, rozmiar, kwantyzację i możliwości
Konfiguracja i dostosowanie
Zmienne środowiskowe
Kluczowe opcje konfiguracyjne za pomocą zmiennych środowiskowych:
# Adres URL backendu (Ollama lub inne kompatybilne z OpenAI API)
OLLAMA_BASE_URL=http://localhost:11434

# Włącz uwierzytelnianie
WEBUI_AUTH=true

# Domyślna rola użytkownika (user, admin, pending)
DEFAULT_USER_ROLE=pending

# Włącz rejestrację użytkowników
ENABLE_SIGNUP=true

# E-mail administratora (automatyczne utworzenie konta administratora)
WEBUI_ADMIN_EMAIL=admin@example.com

# Baza danych (domyślnie SQLite, lub PostgreSQL dla produkcji)
DATABASE_URL=postgresql://user:pass@host:5432/openwebui

# Włącz RAG
ENABLE_RAG=true

# Model osadzeń dla RAG
RAG_EMBEDDING_MODEL=sentence-transformers/all-MiniLM-L6-v2
Połączenie z alternatywnymi backendami
Open WebUI działa z dowolnym kompatybilnym z OpenAI API. Skonfiguruj adres URL bazowy w Ustawieniach → Połączenia:
- vLLM:
http://localhost:8000/v1 - LocalAI:
http://localhost:8080 - LM Studio:
http://localhost:1234/v1 - Text Generation WebUI:
http://localhost:5000/v1 - OpenAI:
https://api.openai.com/v1(wymaga klucza API) - Azure OpenAI: Niestandardowy adres URL endpointu
Konfiguracja proxy odwrotnego
Dla wdrożeń produkcyjnych uruchamiaj Open WebUI za proxy odwróconym:
Przykład Nginx:
server {
    listen 443 ssl http2;
    server_name chat.yourdomain.com;

    ssl_certificate /path/to/cert.pem;
    ssl_certificate_key /path/to/key.pem;

    location / {
        proxy_pass http://localhost:3000;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        # Wsparcie WebSocket
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
    }
}
Przykład Traefik (etykiety Dockera):
labels:
  - "traefik.enable=true"
  - "traefik.http.routers.openwebui.rule=Host(`chat.yourdomain.com`)"
  - "traefik.http.routers.openwebui.entrypoints=websecure"
  - "traefik.http.routers.openwebui.tls.certresolver=letsencrypt"
  - "traefik.http.services.openwebui.loadbalancer.server.port=8080"
Optymalizacja wydajności
Dostrojenie bazy danych
Dla wdrożeń wieloużytkownikowych przełącz się z SQLite na PostgreSQL:
# Zainstaluj zależności
pip install psycopg2-binary

# Skonfiguruj adres URL bazy danych
DATABASE_URL=postgresql://openwebui:password@postgres:5432/openwebui
PostgreSQL lepiej obsługuje równoległych użytkowników i zapewnia poprawioną wydajność zapytań dla wyszukiwania w rozmowach i operacji RAG.
Wybór modelu osadzeń (embedding)
Wydajność RAG w dużej mierze zależy od wybranego modelu osadzeń:
- Szybki/ograniczony zasobami:
all-MiniLM-L6-v2(384 wymiary, ~80MB) - Zbalansowany:
all-mpnet-base-v2(768 wymiarów, ~420MB) - Najlepsza jakość:
bge-large-en-v1.5(1024 wymiary, ~1.3GB)
Skonfiguruj w Ustawieniach → RAG → Model osadzeń.
Strategie cache
Włącz cache rozmów, aby zmniejszyć powtarzające się wywołania API:
- Cache modeli: Ollama automatycznie cache’uje załadowane modele w pamięci
- Cache odpowiedzi: Open WebUI może cache’ować identyczne zapytania (konfigurowalne)
- Cache osadzeń: Ponowne wykorzystanie osadzeń dla wcześniej przetworzonych dokumentów
Najlepsze praktyki bezpieczeństwa
Przy wdrażaniu Open WebUI w środowisku produkcyjnym przestrzegaj tych wytycznych bezpieczeństwa:
- Włącz uwierzytelnianie: Nigdy nie uruchamiaj Open WebUI bez uwierzytelniania w publicznych sieciach
- Używaj HTTPS: Zawsze wdrażaj za proxy odwróconym z TLS/SSL
- Regularne aktualizacje: Utrzymuj Open WebUI i Ollama na bieżąco w celu poprawek bezpieczeństwa
- Ogranicz dostęp: Używaj reguł firewalla, aby ograniczyć dostęp do zaufanych sieci
- Bezpieczne klucze API: Jeśli łączysz się z zewnętrznymi API, używaj zmiennych środowiskowych, nigdy nie koduj kluczy statycznie
- Dzienniki audytu: Włącz i monitoruj dzienniki dostępu pod kątem podejrzanej aktywności
- Kopie zapasowe danych: Regularnie wykonuj kopie zapasowe wolumenu
/app/backend/data - Szyfrowanie bazy danych: Włącz szyfrowanie danych spoczynkowych dla PostgreSQL w produkcji
- Limitowanie przepustowości: Skonfiguruj limity częstotliwości, aby zapobiec nadużyciom
- Filtrowanie treści: Wdrażaj polityki treści odpowiednie dla Twojej organizacji
Scenariusze użycia i zastosowania w praktyce
Osobisty asystent wiedzy
Połącz Open WebUI z lokalnymi modelami i RAG, aby utworzyć prywatną bazę wiedzy. Wgraj swoje notatki, artykuły naukowe, dokumentację projektów i dokumenty osobiste. Zadawaj pytania w formie konwersacyjnej, nie wysyłając danych do usług chmurowych — idealne dla badaczy, studentów i pracowników wiedzy, którzy cenią prywatność.
Współpraca zespołów deweloperskich
Wdroż Open WebUI dla swojego zespołu deweloperskiego z wspólnym dostępem do dokumentacji technicznej, specyfikacji API i wiedzy o bazie kodu. Funkcja RAG pozwala developerom szybko znajdować istotne informacje w tysiącach stron dokumentacji, a historia rozmów pomaga śledzić decyzje architektoniczne i dyskusje techniczne.
Wewnętrzny chatbot enterprise
Organizacje mogą wdrażać Open WebUI za swoim firewallem z integracją SSO, zapewniając pracownikom asystenta AI z dostępem do wewnętrznych wiki, polityk i procedur. Dostęp oparty na rolach zapewnia, że wrażliwe informacje pozostają właściwie segmentowane, a kontrole administratora utrzymują zarządzanie i zgodność.
Edukacja i szkolenia
Instytucje edukacyjne używają Open WebUI, aby zapewnić studentom i kadrze akademickiej pomoc AI bez obaw o prywatność. Wgraj materiały kursowe, podręczniki i notatki z wykładów dla kontekstowego Q&A. System wieloużytkownikowy pozwala śledzić wykorzystanie, utrzymując jednocześnie prywatność danych studentów.
Zastosowania w ochronie zdrowia i prawie
W branżach regulowanych, gdzie prywatność danych jest krytyczna, Open WebUI umożliwia wspierane przez AI procesy, utrzymując zgodność z HIPAA lub RODO. Specjaliści medyczni mogą zapytywać bazy danych leków i protokoły leczenia, a zespoły prawnicze mogą przeszukiwać orzecznictwo i umowy — wszystko to bez opuszczania danych kontrolowanej infrastruktury.
Środowiska odseparowane i offline
Agencje rządowe, placówki badawcze i centra operacji bezpiecznych używają Open WebUI w sieciach odseparowanych (air-gapped). Pełna możliwość pracy offline zapewnia dostęp do pomocy AI nawet bez połączenia z internetem, co jest krytyczne dla środowisk klasyfikowanych lub lokalizacji zdalnych.
Rozwiązywanie wspólnych problemów
Problemy z połączeniem
Problem: Open WebUI nie może połączyć się z Ollama
Rozwiązanie: Zweryfikuj, czy Ollama działa (curl http://localhost:11434), sprawdź zmienną środowiskową OLLAMA_BASE_URL i upewnij się, że reguły firewalla pozwalają na połączenie. Dla wdrożeń Dockera używaj nazw usług (http://ollama:11434) zamiast localhost.
Problem: Modele nie pojawiają się w interfejsie
Rozwiązanie: Potwierdź, czy modele są zainstalowane (ollama list), odśwież listę modeli w ustawieniach Open WebUI i sprawdź konsolę przeglądarki w poszukiwaniu błędów API.
Problemy z RAG i przesyłaniem dokumentów
Problem: Przesyłanie dokumentu się nie powiodło
Rozwiązanie: Sprawdź limity rozmiaru plików w ustawieniach, zweryfikuj obsługiwany format pliku, upewnij się, że w wolumenie danych jest wystarczająco dużo miejsca na dysku i przeglądaj logi kontenera pod kątem błędów analizy.
Problem: Odpowiedzi RAG nie odwołują się do wgranych dokumentów
Rozwiązanie: Zweryfikuj, czy model osadzeń jest pobrany i działa, sprawdź ustawienia rozmiaru fragmentów (spróbuj mniejszych fragmentów dla lepszej granularności), zwiększ liczbę odzyskiwanych fragmentów w ustawieniach RAG i upewnij się, że zapytanie jest istotne dla zawartości dokumentu.
Problemy wydajnościowe
Problem: Wolny czas odpowiedzi
Rozwiązanie: Włącz akcelerację GPU, jeśli jest dostępna, zmniejsz rozmiar modelu lub użyj wersji skwantyzowanych, zwiększ OLLAMA_NUM_PARALLEL dla równoległych żądań i przydziel więcej pamięci RAM kontenerom Dockera.
Problem: Błędy braku pamięci
Rozwiązanie: Używaj mniejszych modeli (7B zamiast 13B parametrów), zmniejsz długość kontekstu w parametrach modelu, ogranicz liczbę równoległych użytkowników lub dodaj więcej pamięci RAM/pamięci swap do swojego systemu.
Uwierzytelnianie i dostęp
Problem: Nie można zalogować się ani utworzyć konta administratora
Rozwiązanie: Ustaw WEBUI_AUTH=true, skonfiguruj WEBUI_ADMIN_EMAIL do automatycznego utworzenia administratora, wyczyść ciasteczka i cache przeglądarki oraz sprawdź logi kontenera pod kątem błędów bazy danych.
Problem: Użytkownicy nie mogą się zarejestrować
Rozwiązanie: Zweryfikuj ENABLE_SIGNUP=true, sprawdź ustawienie DEFAULT_USER_ROLE (użyj user dla automatycznego zatwierdzenia lub pending dla ręcznego zatwierdzenia) i upewnij się, że baza danych jest zapisywalna.
Alternatywy dla Open WebUI
Choć Open WebUI wyróżnia się w dostarczaniu samodzielnie hostowanego interfejsu z silną integracją z Ollama, kilka alternatyw oferuje inne podejścia do tego samego obszaru problemowego. Twój wybór zależy od tego, czy potrzebujesz elastyczności wielu dostawców, specjalistycznego przetwarzania dokumentów, ekstremalnej prostoty, czy funkcji enterprise.
LibreChat wyróżnia się jako najbardziej agnostyczne wobec dostawców rozwiązanie, oferując natywne wsparcie dla OpenAI, Anthropic, Azure OpenAI, Google Vertex AI, AWS Bedrock i Ollama w jednym interfejsie. Jego architektura wtyczek i funkcje enterprise, takie jak wielodzierżawność (multi-tenancy), szczegółowe kontrole dostępu i kwoty użycia, czynią go idealnym dla organizacji, które muszą wspierać wielu dostawców AI lub wymagają zaawansowanych śladów audytu. Kompromisem jest złożoność — LibreChat wymaga więcej wysiłku przy konfiguracji i cięższych zasobów niż Open WebUI, a jego wsparcie dla Ollama wydaje się drugorzędnym wobec dostawców chmurowych. Jeśli Twój zespół używa Claude do pisania, GPT-4 do kodowania, a lokalnych modeli do pracy wrażliwej na prywatność, zintegrowany interfejs LibreChat błyszczy.
Dla workflow opartych na dokumentach, AnythingLLM przyjmuje podejście oparte na bazie wiedzy, wykraczające poza podstawowy RAG. Jego model przestrzeni roboczych (workspaces) organizuje dokumenty i rozmowy w izolowane środowiska, a zaawansowane funkcje odzyskiwania obejmują wyszukiwanie hybrydowe, ponowne rankowanie (reranking) i śledzenie cytatów. Połączniki danych (Data connectors) pobierają zawartość z GitHub, Confluence i Google Drive, a możliwości agentic umożliwiają wieloetapowe wnioskowanie i automatyzację procesów. To sprawia, że AnythingLLM jest doskonałe dla firm konsultingowych zarządzających wieloma bazami wiedzy klientów lub zespołów wsparcia pracujących z rozległą dokumentacją. Interfejs czatu jest mniej dopracowany niż w Open WebUI, ale jeśli wyszukiwanie w dużych kolekcjach dokumentów jest Twoją główną potrzebą, zaawansowane możliwości odzyskiwania uzasadniają bardziej stromą krzywą uczenia się.
LobeChat stawia doświadczenie użytkownika ponad głębokość funkcji, oferując elegancki, przyjazny dla urządzeń mobilnych interfejs z możliwościami aplikacji progresywnej (PWA). Jego nowoczesny design, płynne animacje i silne wsparcie dla multimodalności/głosu czynią go popularnym wśród projektantów i użytkowników nietechnicznych, którzy chcą asystenta AI działającego płynnie na wielu urządzeniach. Implementacja PWA zapewnia doświadczenie mobilne przypominające aplikację, które Open WebUI nie dorównuje. Jednak funkcje enterprise są ograniczone, ekosystem wtyczek jest mniejszy, a możliwości RAG ustępują zarówno Open WebUI, jak i AnythingLLM.
Dla użytkowników preferujących aplikacje desktopowe, Jan.ai dostarcza instalatorów wieloplatformowych (Windows, macOS, Linux) z zarządzaniem lokalnymi modelami bez konfiguracji. Nie ma potrzeby instalowania Ollama osobno ani radzenia sobie z Dockerem — Jan pakuje wszystko w natywną aplikację z wsparciem tacy systemowej (system tray) i pobieraniem modeli jednym kliknięciem. Ta filozofia „po prostu działa” czyni Jana idealnym do dawania lokalnych LLM rodzinie lub współpracownikom, którzy nie czują się komfortowo z narzędziami wiersza poleceń. Kompromisami są brak wsparcia dla wielu użytkowników, mniej zaawansowanych funkcji i brak możliwości zdalnego dostępu.
Chatbox zajmuje niszę lekkich rozwiązań — minimalistyczny klient wieloplatformowy obsługujący OpenAI, Claude, Gemini i lokalne API z bardzo niskim obciążeniem zasobów. Jest idealny dla developerów, którzy muszą szybko testować różnych dostawców API, lub użytkowników ze sprzętem o ograniczonych zasobach. Tarcie przy instalacji jest minimalne, ale niektóre funkcje są zablokowane za subskrypcją, nie jest w pełni otwartoźródłowy, a wsparcie RAG jest ograniczone.
Istnieje kilka minimalistycznych UI specyficznych dla Ollama dla użytkowników, którzy chcą „wystarczającego” interfejsu: Hollama zarządza wieloma serwerami Ollama na różnych maszynach, Ollama UI zapewnia podstawowy czat i upload PDF z ekstremalnie łatwym wdrożeniem, a Oterm oferuje zaskakująco zdolny interfejs terminalowy dla sesji SSH i workflow tmux. Oferują one prostotę i szybkość kosztem funkcji.
Dla organizacji wymagających wsparcia dostawcy, opcje komercyjne takie jak TypingMind Team, BionicGPT i Dust.tt oferują samodzielne hostowanie z profesjonalnym wsparciem, certyfikatami zgodności i SLA. Wymieniają one wolność open source na gwarancję dostępności, audyty bezpieczeństwa i odpowiedzialność — co jest odpowiednie, gdy Twoja organizacja potrzebuje kontraktów wsparcia klasy enterprise.
Mądry wybór: Open WebUI trafia w punkt idealny dla większości samodzielnie hostowanych wdrożeń Ollama, balansując kompleksowe funkcje z zarządzalną złożonością. Wybierz LibreChat, gdy elastyczność dostawców jest priorytetem, AnythingLLM dla zaawansowanych workflow z dokumentami, LobeChat dla użytkowników mobilnych-first lub ceniących design, Jana dla nietechnicznych użytkowników desktopowych, lub opcje komercyjne, gdy potrzebujesz wsparcia dostawcy. Dla większości użytkowników technicznych uruchamiających lokalne modele aktywny rozwój, silna społeczność i doskonała implementacja RAG w Open WebUI czynią go zalecanym punktem wyjścia.
Przyszłe developmenty i mapa drogowa
Open WebUI kontynuuje szybki rozwój z kilkoma ekscytującymi funkcjami na mapie drogowej:
Ulepszona obsługa multimodalna: Lepsze zarządzanie obrazami, modelami wizyjnymi i rozmowami multimodalnymi z modelami takimi jak LLaVA i Bakllava.
Rozszerzone możliwości agentic: Wywoływanie funkcji (function calling), używanie narzędzi i wieloetapowe procesy wnioskowania podobne do wzorców AutoGPT.
Lepsze aplikacje mobilne: Natywne aplikacje iOS i Android wykraczające poza obecną implementację PWA dla ulepszonego doświadczenia mobilnego.
Zaawansowane funkcje RAG: RAG oparty na grafach, semantyczne chunkingowanie, odzyskiwanie wielozapytań i odzyskiwanie dokumentu nadrzędnego dla lepszego kontekstu.
Funkcje collaborative: Wspólne rozmowy, zespołowe przestrzenie robocze i współpraca w czasie rzeczywistym nad promptami i dokumentami.
Integracje enterprise: Głębsze wsparcie SSO, provisionowanie SCIM, zaawansowane dzienniki audytu i raportowanie zgodności dla branż regulowanych.
Projekt utrzymuje kompatybilność wsteczną i wersjonowanie semantyczne, co czyni aktualizacje prostymi. Aktywny repozytorium GitHub widzi codzienne commity i responsywne zarządzanie issue’ami.
Wnioski
Open WebUI ewoluował z prostego frontendu Ollama w kompleksową platformę dla samodzielnie hostowanych interakcji z AI. Jego kombinacja prywatności, funkcji i łatwości wdrożenia czyni go doskonałym wyborem dla jednostek, zespołów i organizacji chcących wykorzystać lokalne LLM bez rezygnacji z możliwości.
Niezależnie od tego, czy jesteś developerem testującym modele, organizacją budującą wewnętrzne narzędzia AI, czy osobą ceniącą prywatność, Open WebUI dostarcza fundamentu dla potężnych, samodzielnie hostowanych workflow AI. Aktywna społeczność, regularne aktualizacje i rozszerzalna architektura zapewniają, że pozostanie wiodącą opcją w przestrzeni samodzielnie hostowanego AI.
Zacznij od podstawowej instalacji Dockera, eksperymentuj z RAG, wgrując kilka dokumentów, próbuj różnych modeli z biblioteki Ollama i stopniowo eksploruj zaawansowane funkcje, gdy Twoja rośnie. Krzywa uczenia się jest łagodna, ale sufit jest wysoki — Open WebUI skaluje się od osobistego laptopa do klastra Kubernetes enterprise.
Dla tych, którzy porównują alternatywy, design Open WebUI priorytetyzujący Ollama, zbalansowany zestaw funkcji i aktywny rozwój czynią go zalecanym punktem wyjścia dla większości samodzielnie hostowanych wdrożeń LLM. Zawsze możesz migrować do bardziej specjalistycznych rozwiązań, jeśli pojawią się konkretne potrzeby, ale wielu użytkowników uznaje możliwości Open WebUI za wystarczające dla całej ich drogi, od eksperymentowania po produkcję. Aby zobaczyć, jak typowe backends Open WebUI (Ollama, vLLM itp.) dopasowują się do Docker Model Runner, LocalAI i dostawców chmurowych, sprawdź nasz przewodnik Hosting LLM: Porównanie infrastruktury lokalnej, samodzielnie hostowanej i chmurowej.
Przydatne linki
Przy konfigurowaniu swojego środowiska Open WebUI, skorzystasz z zrozumienia szerszego ekosystemu lokalnego hostingowania i wdrożeń LLM. Kompletny przewodnik Lokalny hosting LLM: Kompletny przewodnik 2025 - Ollama, vLLM, LocalAI, Jan, LM Studio i inne porównuje ponad 12 lokalnych narzędzi LLM, w tym Ollama, vLLM, LocalAI i inne, pomagając Ci wybrać optymalny backend dla Twojego wdrożenia Open WebUI na podstawie dojrzałości API, możliwości wywoływania narzędzi i benchmarków wydajności.
Dla wdrożeń produkcyjnych o wysokiej wydajności, w których przepustowość i latencja są krytyczne, zobacz przewodnik Szybki start vLLM: Wysokiej wydajności serwer LLM, który obejmuje setup vLLM z Dockerem, kompatybilność z API OpenAI i optymalizację PagedAttention. Jest to szczególnie wartościowe, jeśli Open WebUI obsługuje wielu równoległych użytkowników, a wydajność Ollama staje się wąskim gardłem.
Jeśli wolisz backend multimodalny obsługujący czat, osadzenia, generowanie obrazów i audio przez pojedynczy serwer kompatybilny z OpenAI, Szybki start LocalAI obejmuje instalację Dockera, setup galerii modeli i konfigurację API — wszystko podłączalne do Open WebUI za pomocą bazowego adresu URL http://localhost:8080.
Zrozumienie, jak Twój backend obsługuje równoległe żądania, jest kluczowe dla planowania pojemności. Artykuł Jak Ollama obsługuje równoległe żądania wyjaśnia kolejkowanie żądań Ollama, zarządzanie pamięcią GPU i model równoległego wykonywania, pomagając Ci skonfigurować odpowiednie limity i oczekiwania dla scenariuszy wieloużytkownikowych w Twoim wdrożeniu Open WebUI.
Jeśli oceniasz, czy pętla agentic search w Open WebUI jest „wystarczająco głęboka” dla Twojego obciążenia badawczego, Samodzielnie hostowane systemy Deep Research: Porównanie 12 narzędzi stawia podejście oparte na modelu w Open WebUI obok dedykowanych silników badawczych, takich jak GPT Researcher, Onyx i DeerFlow.
Zewnętrzne zasoby
Dla oficjalnej dokumentacji i wsparcia społeczności, odwołaj się do tych zewnętrznych zasobów:
