Self-Hosting

Szybki start Vane (Perplexica 2.0) z Ollama i llama.cpp

Szybki start Vane (Perplexica 2.0) z Ollama i llama.cpp

Własna wyszukiwarka AI z lokalnymi modelami LLM

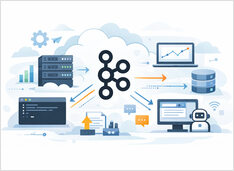
Vane to jeden z bardziej pragmatycznych projektów w przestrzeni „AI-search z cytatami”: samodzielnie hostowany silnik odpowiedzi, który łączy wyszukiwanie na żywej sieci z modelami LLM (lokalnymi lub w chmurze), a jednocześnie pozwala zachować pełną kontrolę nad całym stackiem.

Ollama w Docker Compose z GPU i trwałym magazynowaniem modeli

Ollama w Docker Compose z GPU i trwałym magazynowaniem modeli

Serwer Ollama w stylu Compose-first z obsługą GPU i trwałym zapisem danych.

Ollama świetnie działa na “gołym” metalu (bez warstwy wirtualizacji). Staje się jeszcze ciekawszy, gdy traktujesz go jak usługę: stabilny punkt końcowy, przypięte wersje, trwałe przechowywanie danych oraz GPU, które jest dostępne, lub go nie ma.

Wektory tekstowe dla RAG i wyszukiwania – Python, Ollama, API kompatybilne z OpenAI

Wektory tekstowe dla RAG i wyszukiwania – Python, Ollama, API kompatybilne z OpenAI

RAG embeddings – Python, Ollama, API OpenAI.

Jeśli pracujesz nad generacją wspieraną odzyskiwaniem (RAG), ta sekcja wyjaśnia wektory tekstowe (embeddings) prostym językiem — czym są, jak pasują do wyszukiwania i odzyskiwania informacji, oraz jak wywołać dwa popularne lokalne rozwiązania z Pythonu przy użyciu Ollama lub kompatybilnego z OpenAI interfejsu HTTP (jakiego używają serwery oparte na llama.cpp).

llama.swap: szybki start z przełącznikiem modeli dla lokalnych LLM zgodnych z OpenAI

llama.swap: szybki start z przełącznikiem modeli dla lokalnych LLM zgodnych z OpenAI

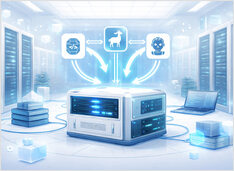
Gorąca wymiana lokalnych LLMów bez zmian w klientach.

Wkrótce będziesz jugglingiem w vLLM, llama.cpp i wielu innych — każdy stack na własnym porcie. Wszystkie komponenty dół wciąż wymagają jednego /v1 bazowego adresu URL; inaczej będziesz w nieskończoność przesuwać porty, profile i jednorazowe skrypty. llama-swap to /v1 proxy umieszczane przed tymi stackami.