Ollama

Samodzielnie hostowane systemy zaawansowanych badań: porównanie 12 narzędzi

Samodzielnie hostowane systemy zaawansowanych badań: porównanie 12 narzędzi

Autonomiczni agenci hostowani samodzielnie, badający w zakresie wykraczającym poza wyszukiwanie

Deep Research stał się samodzielną kategorią oprogramowania, a nie tylko modelem skierowanym na pole wyszukiwania. Ten artykuł porównuje dwanaście systemów hostowanych samodzielnie oraz architektury badawcze za nimi stojące.

llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

llama.cpp a Ollama w 2026 r.: który runtime powinien wybrać?

„Gdy llama-server wyprzedza Ollamę”

Ollama i llama.cpp są często porównywane tak, jakby były rywalizującymi silnikami inferencji. Rzeczywisty wybór polega na decyzji między zarządzaną usługą modeli a zestawem narzędzi, który obsługujesz bezpośrednio.

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

Dlaczego kontekst 128K zawodzi na 16 GB

Model może reklamować okno kontekstowe 128K i mimo to zawiedzie przy 40K tokenach na karcie GPU 16 GB. Architektoniczny limit nigdy nie gwarantował, że wagi, cache KV, bufora obliczeniowe i kompozytor pulpitu zmieszczą się jednocześnie na Twojej karcie.

Grawitacja danych: prawdziwa koszt strategii API-first w sztucznej inteligencji

Grawitacja danych: prawdziwa koszt strategii API-first w sztucznej inteligencji

Dlaczego Twój stos AI staje się co miesiąc bardziej kleisty.

Każde wywołanie API wydaje się prostą transakcją – dopóki nie gromadzi się ich na tyle dużo, że dane do dostrojenia, zestawy do ewaluacji oraz schematy narzędzi nie zaczynają być ukształtowane wokół jednego dostawcy, a zmiana dostawcy przestaje być jedynie zmianą routingu.

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Ollama to vLLM: kiedy migrować serwer lokalnych modeli LLM

Kiedy przejść z Ollamy na vLLM

Ollama to jeden z najprostszych sposobów na uruchomienie lokalnego modelu językowego, jednak wygoda może ukrywać moment, w którym lokalny eksperyment staje się współdzieloną usługą inferencyjną wymagającą lepszego planowania zadań i obserwowalności.

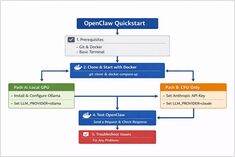
Szybki start Vane (Perplexica 2.0) z Ollama i llama.cpp

Szybki start Vane (Perplexica 2.0) z Ollama i llama.cpp

Własna wyszukiwarka AI z lokalnymi modelami LLM

Vane to jeden z bardziej pragmatycznych projektów w przestrzeni „AI-search z cytatami”: samodzielnie hostowany silnik odpowiedzi, który łączy wyszukiwanie na żywej sieci z modelami LLM (lokalnymi lub w chmurze), a jednocześnie pozwala zachować pełną kontrolę nad całym stackiem.

Ollama w Docker Compose z obsługą GPU i trwałą pamięcią modeli

Ollama w Docker Compose z obsługą GPU i trwałą pamięcią modeli

Serwer Ollama z pierwszeństwem kompozycji, obsługą GPU i trwałością danych.

Ollama świetnie działa na “gołym metalu”. Zyskuje jednak na ciekawości, gdy potraktujesz ją jako usługę: stabilny punkt końcowy, zablokowane wersje, trwałe przechowywanie danych oraz dostępność GPU, która jest albo dostępna, albo nie.

Wektory tekstowe dla RAG i wyszukiwania – Python, Ollama, API kompatybilne z OpenAI

Wektory tekstowe dla RAG i wyszukiwania – Python, Ollama, API kompatybilne z OpenAI

RAG embeddings – Python, Ollama, API OpenAI.

Jeśli pracujesz nad generacją wspieraną odzyskiwaniem (RAG), ta sekcja wyjaśnia wektory tekstowe (embeddings) prostym językiem — czym są, jak pasują do wyszukiwania i odzyskiwania informacji, oraz jak wywołać dwa popularne lokalne rozwiązania z Pythonu przy użyciu Ollama lub kompatybilnego z OpenAI interfejsu HTTP (jakiego używają serwery oparte na llama.cpp).