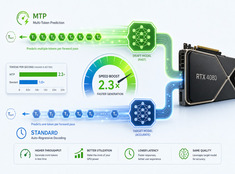
MTP w porównaniu do standardowego dekodowania na RTX 4080 — rzeczywiste benchmarki
Przetestowałem wydajność spekulacyjnego dekodowania (Wieloznakowego Przewidywania, MTP) w modelach Qwen 3.6 27B i 35B na karcie RTX 4080 z 16 GB pamięci VRAM.
Tryb routera w llama.cpp to jedna z najbardziej przydatnych zmian wprowadzonych do llama-server w ciągu ostatnich lat. Wreszcie daje lokalnym operatorom modeli LLM coś w rodzaju zarządzania modelami, do którego są przyzwyczajeni z Ollama, jednocześnie zachowując surową wydajność i kontrolę na niskim poziomie, która sprawia, że warto korzystać z llama.cpp w pierwszej kolejności.
Ta strona stanowi praktyczny przewodnik do dostrajania wnioskowania agenticznego LLM (temperatura, top_p, top_k, kary i ich wzajemne oddziaływania w wieloetapowych przepływach pracy oraz w scenariuszach intensywnie wykorzystujących narzędzia).
Gorące wymiana lokalnych modeli LLM bez konieczności zmiany klientów.
Wkrótce będziesz balansować między vLLM, llama.cpp i innymi rozwiązaniami – każdy stos na własnym porcie. Wszystko w dalszym ciągu oczekuje jednego podstawowego adresu URL /v1; inaczej ciągle będziesz przesuwać porty, profile i skrypty ad-hoc. llama-swap jest proxy /v1 przed tymi stosami.
Test modelu OpenCode LLM — statystyki kodowania i dokładności
Przetestowałem, jak OpenCode współpracuje z kilkoma lokalnie hostowanymi modelami LLM na Ollama i llama.cpp, a dla porównania dodałem kilka darmowych modeli z OpenCode Zen.
Jak zainstalować, skonfigurować i wykorzystać OpenCode
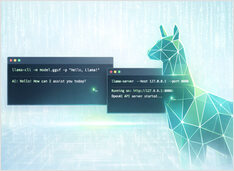
Nieustannie wracam do llama.cpp do lokalnej inferencji – daje ono kontrolę, którą Ollama i inne narzędzia abstrahują, i po prostu działa. Łatwo uruchomić modele GGUF interaktywnie za pomocą llama-cli lub wystawić kompatybilne z OpenAI API HTTP za pomocą llama-server.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.