AI Coding

gstack: Stak inżynierii oprogramowania AI

gstack: Stak inżynierii oprogramowania AI

Fabryka oprogramowania zbudowana na umiejętnościach agentów

Inteligentni agenci do kodowania potrafią już tworzyć funkcje, modyfikować repozytoria, uruchamiać testy i otwierać pull requesty. Trudniejszym problemem jest skłonienie agenta do przestrzegania powtarzalnego procesu inżynieryjnego przed, w trakcie i po napisaniu kodu.
OpenSpec: Odrzucone propozycje — konwencja pamięci decyzji

OpenSpec: Odrzucone propozycje — konwencja pamięci decyzji

Brak stanu odrzucenia. Oto obejście.

Agent, który sześć miesięcy temu zaproponował i wdrożył „przeniesienie trwałego przechowywania do wspólnej biblioteki”, z przyjemnością zaproponuje to samo następnego kwartału, chyba że coś trwałego powie mu, iż ten pomysł został już przeanalizowany i odrzucony – a OpenSpec obecnie nie ma wbudowanego mechanizmu do śledzenia takiego stanu.

Umiejętności agenta a serwery MCP: ramy decyzyjne

Umiejętności agenta a serwery MCP: ramy decyzyjne

Umiejętność, serwer MCP czy jedno i drugie?

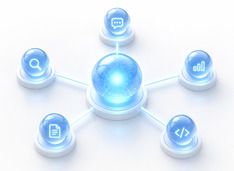
Umiejętności agenta i serwery MCP są często przedstawiane jako rywalizujące ze sobą sposoby rozszerzania możliwości agenta AI. To ujęcie jest błędne: umiejętność uczy agenta, jak pracować, podczas gdy serwer MCP daje mu kontrolowany dostęp do żywych funkcjonalności.

Szybki start z Superpowers: instalacja, przepływ pracy i testowanie

Szybki start z Superpowers: instalacja, przepływ pracy i testowanie

Wymuszone umiejętności SDD, instalowane jednym poleceniem.

Superpowers to pakiet, który integruje kompletną, specyfikacyjną metodologię programowania w instalowalne Claude Skills, wymuszając burzę mózgów, planowanie, implementację opartą na subagentach oraz rygorystyczne TDD, zamiast pozostawiać tę strukturę Twojej dyscyplinie.

Claude Code Subagenci: konfiguracja, ustawienia i przypadki użycia

Claude Code Subagenci: konfiguracja, ustawienia i przypadki użycia

Deleguj hałaśliwe zadania, utrzymuj czysty kontekst.

Większość sesji w Claude Code spowalnia i staje się nieczytelna z tego samego powodu: każde eksploracyjne użycie grep, każdy zrzut logów oraz każde „sprawdzę jeszcze jeden plik” pozostaje w głównej konwersacji na stałe.

Utrzymywanie spójności specyfikacji, testów i kodu w procesie rozwoju AI

Utrzymywanie spójności specyfikacji, testów i kodu w procesie rozwoju AI

Zapobiegaj odchyleniom agentów AI od specyfikacji, testów i kodu.

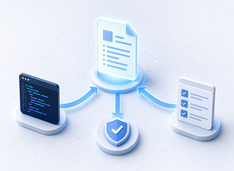
Agenci kodujący z wykorzystaniem sztucznej inteligencji (AI) szybkodostarczają funkcje, ale specyfikacje, testy i kod cicho się od siebie oddalają. Ten przewodnik omawia model śledzenia (traceability), mapowanie specyfikacji na testy oraz kodu, a także sprawdzenia CI, które wychwytują rozbieżności przed scaleniem (merge).

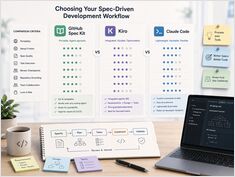
GitHub Spec Kit vs Kiro vs Claude Code – przepływy pracy SDD

GitHub Spec Kit vs Kiro vs Claude Code – przepływy pracy SDD

Głębokość procesu, a nie przenośność, nie najlepszy narzędzie.

Deweloperzy porównujący konfiguracje Spec-Driven Development (SDD) w 2026 roku zwykle nie pytają, który model jest najmądrzejszy. Pytają, który przepływ pracy utrzyma agenta AI na właściwej ścieżce, nie chowając ich w biurokracji.

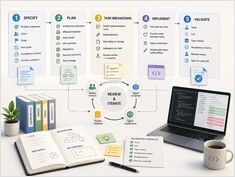
Workflow rozwoju oparty na specyfikacjach: od wymagań do kodu

Workflow rozwoju oparty na specyfikacjach: od wymagań do kodu

Pięć faz od intencji po zweryfikowany kod.

Rozwój oparty na specyfikacjach (Spec-Driven Development, SDD) działa, gdy specyfikacja jest procesem, a nie dokumentem, który archiwizujemy po spotkaniu kick-off. Chodzi nie o to, aby wyprodukować obszerny dokument wymagań produktu.

Spekulacyjne dekodowanie: 20–50% szybsza inferencja modeli LLM

Spekulacyjne dekodowanie: 20–50% szybsza inferencja modeli LLM

Szybsza inferencja LLM bez utraty jakości – praktyczny przewodnik

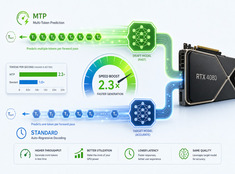
Model o 70 mld parametrów generuje jeden token w jednym przebiegu przodowym (forward pass), przy czym każda taka operacja powoduje ponowne wczytywanie wag z pamięci VRAM, obliczanie mechanizmu uwagi na całym kontekście oraz synchronizację pamięci. W odstępach między tokenami GPU pozostaje nieczynne, czekając na wyznaczenie zależności sekwencyjnych.

Wzorce orkiestracji wielu agentów: praktyczny przewodnik

Wzorce orkiestracji wielu agentów: praktyczny przewodnik

40% pilotaży z wieloma agentami kończy się porażką. Oto jak wybrać właściwy wzorzec orkiestracji – i uniknąć tych, które się zawadzają.

Systemy AI oparte na pojedynczym agencie osiągnęły szczyt popularności w 2025 roku — wystarczyło podać jednemu LLM-owi prompt, kilka narzędzi i cel, a system radził sobie dość dobrze z ograniczonymi zadaniami.