LLM Performance

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

KV Cache na GPU z 16 GB pamięci: jak realnie zmieścić długi kontekst

Dlaczego kontekst 128K zawodzi na 16 GB

Model może reklamować okno kontekstowe 128K i mimo to zawiedzie przy 40K tokenach na karcie GPU 16 GB. Architektoniczny limit nigdy nie gwarantował, że wagi, cache KV, bufora obliczeniowe i kompozytor pulpitu zmieszczą się jednocześnie na Twojej karcie.

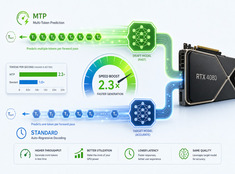
Spekulacyjne dekodowanie: 20–50% szybsza inferencja modeli LLM

Spekulacyjne dekodowanie: 20–50% szybsza inferencja modeli LLM

Szybsza inferencja LLM bez utraty jakości – praktyczny przewodnik

Model o 70 mld parametrów generuje jeden token w jednym przebiegu przodowym (forward pass), przy czym każda taka operacja powoduje ponowne wczytywanie wag z pamięci VRAM, obliczanie mechanizmu uwagi na całym kontekście oraz synchronizację pamięci. W odstępach między tokenami GPU pozostaje nieczynne, czekając na wyznaczenie zależności sekwencyjnych.

BAML vs Instructor: strukturyzowane wyjścia LLM

BAML vs Instructor: strukturyzowane wyjścia LLM

Bezpieczne typowo wyjścia LLM z BAML i Instructor

Pracując z dużymi modelami językowymi (LLM) w środowisku produkcyjnym, kluczowe jest uzyskiwanie ustrukturyzowanych wyjść bezpiecznych typowo.

Dwa popularne frameworki – BAML i Instructor – stosują różne podejścia do rozwiązania tego problemu.

ASIC LLM i specjalizowane układy do inferencji (dlaczego są ważne)

ASIC LLM i specjalizowane układy do inferencji (dlaczego są ważne)

ASICy i dedykowane układy półprzewodnikowe zwiększają szybkość i wydajność inferencji modeli LLM

Przyszłość AI to nie tylko kwestia bardziej inteligentnych modeli. Dotyczy ona również półprzewodników, które są dostosowane do rzeczywistego sposobu uruchamiania tych modeli. Specjalistyczny sprzęt do wnioskowania LLM podąża ścieżką przypominającą ewolucję kopania Bitcoina od GPU po dedykowane układy ASIC, jednak w znacznie trudniejszych warunkach, ponieważ modele i schematy precyzji wciąż się zmieniają.