virt-clone과 virt-sysprep를 사용하여 Virt-Manager에서 VM 복제하기
VM 복제는 바이트를 복제할 뿐, 아이덴티티를 복제하지 않습니다.
Virt-Manager (libvirt GUI)은 KVM 디스크를 복사하고 클론에 UUID와 MAC 주소를 할당합니다. 게스트는 machine-id와 SSH 호스트 키를 유지하며, virt-sysprep가 이를 정리할 때까지 그대로 두게 됩니다.
VM 복제는 바이트를 복제할 뿐, 아이덴티티를 복제하지 않습니다.
Virt-Manager (libvirt GUI)은 KVM 디스크를 복사하고 클론에 UUID와 MAC 주소를 할당합니다. 게스트는 machine-id와 SSH 호스트 키를 유지하며, virt-sysprep가 이를 정리할 때까지 그대로 두게 됩니다.
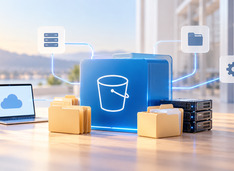
MinIO 이후 셀프호스팅 S3 선택
Amazon S3는 오브젝트 저장소의 사실상 표준 API가 되었습니다. 오픈소스 MinIO 저장소가 2026년 4월에 아카이브 처리된 이후, 7개의 신뢰할 수 있는 셀프호스팅 대안 솔루션이 남아 있습니다.
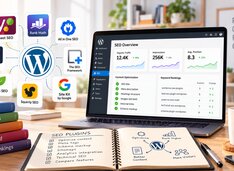
WordPress SEO 플러그인, Yoast에서 로컬 AI로
WordPress SEO 플러그인은 WordPress 코어의 위에 메타데이터, 사이트맵, 스키마, 그리고 AI 계층을 추가합니다. 2026년 현재 이 계층에는 자체 하드웨어에서 추론을 실행하는 플러그인도 포함됩니다.
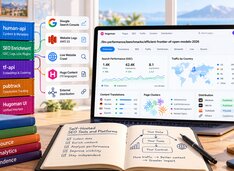
워드프레스 플러그인을 넘어선 오픈소스 SEO
자체 호스팅 SEO는 현재 크롤러, Search Console 대시보드, 랭킹 트래커, MCP 서버, 그리고 로컬 AI를 포함합니다. 이 가이드는 주요 오픈소스 플랫폼을 비교하고, 유료 SEO API 없이도 어떤 기능이 작동하는지 살펴봅니다.
검색을 넘어 연구를 수행하는 셀프호스트 에이전트
Deep Research는 이제 단순히 검색 박스에 적용되는 모델이 아니라, 독자적인 소프트웨어 카테고리가 되었습니다. 이 글에서는 12가지 셀프호스팅 시스템과 그 뒤를支撑하는 리서치 아키텍처를 비교합니다.
기억된 결론이 새로운 증거가 될 때
지속적 메모리는 에이전트를 매번 설명을 들어야 하는 도구에서 컨텍스트를 유지하며 나아가는 존재로 전환시켜 줍니다. 하지만 이는 무상태(stateless) 채팅이 피하는 실패 모드를 열어젖히기도 합니다. 해석(interpretation)이 메모리가 되어 사실처럼 검색되고, 이를 근거로 자신에 대한 더 강력한 버전의 정당화를 만드는 식입니다.
통제된 쓰기 기능을 갖춘 로컬 Hermes 메모리
Mnemosyne은 Hermes Agent를 위한 로컬 퍼스트(local-first) 메모리 프로바이더입니다. 워킹 메모리, 구조화된 사실, 시간 데이터, 그리고 에피소드적 역사를 로컬 SQLite에 저장하며, 호스팅된 서비스나 필수적인 네트워크 호출 없이도 유독 세밀한 수준의 쓰기(write) 제어를 제공합니다.
한 줄 import를 넘어선 안전한 전환
AI 어시스턴트 마이그레이션은 단순한 애플리케이션 설정 복사와는 다른 문제입니다. 가장 어려운 부분은 두 개의 게이트웨이가 동일한 봇으로 작동하지 않도록 하면서도, 정체성, 기억, 도구 동작, 예약된 작업, 그리고 메시지 접근 권한을 보존하는 것입니다.

“llama-server가 Ollama를 능가할 때”
Ollama와 llama.cpp는 종종 경쟁하는 추론 엔진으로 비교되곤 합니다. 실제 선택은 관리형 모델 서비스와 직접 운영하는 툴킷 사이의 결정에 가깝습니다.
엔진별로 적합한 AMD 백엔드 선택
ROCm과 Vulkan은 모두 로컬 LLM 호스팅을 위해 AMD GPU를 가속화하지만, 서로 대체재가 될 수 없습니다. 올바른 선택은 엔진, GPU, 그리고 워크로드에 따라 달라집니다.
16GB에서 128K 컨텍스트가 실패하는 이유
모델은 128K 컨텍스트 윈도우를 광고하면서도 16 GB GPU에서 40K 토큰에서 실패할 수 있습니다. 아키텍처 상한은 웨이트, KV 캐시, 컴퓨트 버퍼, 데스크톱 컴포지터가 모두 동시에 해당 카드에 들어맞겠다는 약속을 한 적이 없습니다.
AI 스택이 매월 더욱 강하게 고정되는 이유
모든 API 호출은 단순한 거래처럼 느껴집니다. 하지만 그 수가 쌓이면, 파인튜닝 데이터, 평가 하네스, 도구 스키마가 모두 하나의 벤더 주위에 형성되어, 벤더 전환이 더 이상 단순한 라우팅 변경이 아닌 상황이 됩니다.
컴파일된 지식의 신뢰성을 유지하세요
LLM 위키(Wiki)는 오래된 사실이 여전히 그럴듯해 보일 때, 모순이 정교하게 다듬어질 때, 그리고 생성된 요약이 원천 자료에서 벗어나면 실패합니다.
로컬 지식용 프라이빗 동기화
Syncthing은 사용자가 제어하는 여러 기기 간에 파일을 동기화하며, 클라우드 종속을 피하는 자체 호스팅 지식 인프라를 구축하는 데 가장 실용적인 도구 중 하나입니다.
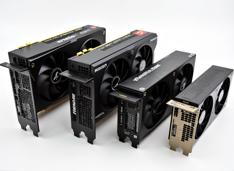
3개 벤더 간 AI GPU 비교
2026년 AI 하드웨어 시장은 크게 변화했습니다. NVIDIA, AMD, 인텔은 모두 로컬 대규모 언어 모델(LLM)과 AI 추론 워크로드를 처리할 수 있는 GPU를 필요로 하는 개발자들을 두고 치열한 경쟁을 벌이고 있습니다.
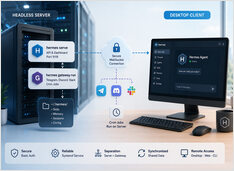
원격 데스크톱 액세스를 지원하는 Headless Hermes 서버
데스크톱 클라이언트에서 다른 머신의 헤드리스 서버에 Hermes 에이전트를 실행하고 연결하려면 두 개의 서버 프로세스와 하나의 클라이언트 연결이 필요합니다.