
오픈 모델의 효율적 프론티어: 2026년의 최적의 균형점 찾기
2026년 오픈 LLM의 최적 구간: 약 30B
2026년 9월, 오픈 모델의 효율적 프런티어(efficient frontier)는 25B~34B 파라미터 사이에 위치합니다: 24 GB 단일 GPU에서 프런티어에 근접한 에이전틱 작업을 수행할 수 있으면서, 70B급 하드웨어의 일부 비용으로만 가능합니다.
2026년 오픈 LLM의 최적 구간: 약 30B
2026년 9월, 오픈 모델의 효율적 프런티어(efficient frontier)는 25B~34B 파라미터 사이에 위치합니다: 24 GB 단일 GPU에서 프런티어에 근접한 에이전틱 작업을 수행할 수 있으면서, 70B급 하드웨어의 일부 비용으로만 가능합니다.
16GB에서 128K 컨텍스트가 실패하는 이유
모델은 128K 컨텍스트 윈도우를 광고하면서도 16 GB GPU에서 40K 토큰에서 실패할 수 있습니다. 아키텍처 상한은 웨이트, KV 캐시, 컴퓨트 버퍼, 데스크톱 컴포지터가 모두 동시에 해당 카드에 들어맞겠다는 약속을 한 적이 없습니다.
품질 저하 없이 더 빠른 LLM 추론 – 실용 가이드
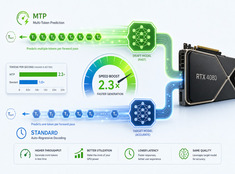
70B 모델은 포워드 패스당 1개의 토큰을 생성하며, 각 패스에서는 VRAM에서 가중치를 다시 로드하고, 컨텍스트에 대한 어텐션을 계산하며, 메모리를 동기화합니다. 토큰 사이에는 GPU가 순차적인 의존성이 해결되기를 기다리며 유휴 상태(idle)에 있게 됩니다.
RTX 4080에서 MTP와 표준 디코딩 비교 — 실제 벤치마크
Qwen 3.6 27B와 35B 모델에서 RTX 4080 16 GB VRAM 환경의 스펡추레이티브 디코딩(Speculative decoding, Multi-Token Prediction, MTP) 성능을 테스트했습니다.
느낌에 의존한 해석을 중단하고, 계약서를 검증하십시오.
대부분의 대규모 언어 모델(LLM) ‘구조화된 출력(structured output)’ 튜토리얼은 진지하지 않습니다. 이들은 사용자에게 정중하게 JSON을 요청한 후 모델이 잘 작동하기를 바라고 만듭니다. 그것은 검증(validation)이 아닙니다. 그것은 중괄호를 사용한 낙관주의에 불과합니다.
에이전틱 LLM 튜닝 참고 자료
이 페이지는 에이전트형 LLM 추론 튜닝에 대한 실용적인 참고 자료입니다(temperature, top_p, top_k, penalties 및 다단계 및 도구 중심 워크플로우에서의 상호 작용 방식).
16GB VRAM에서 llama.cpp의 토큰 처리 속도(테이블)
여기서는 16GB VRAM을 갖춘 GPU에서 구동되는 여러 LLM의 속도를 비교하고, 자가 호스팅에 가장 적합한 모델을 선택하는 과정을 다루고 있습니다.
RTX 4080 (16GB VRAM)에서 LLM 속도 테스트
로컬에서 대규모 언어 모델(Large Language Models, LLM)을 실행하면 개인 정보 보호, 오프라인 사용성, 그리고 제로 API 비용을 얻을 수 있습니다. 이 벤치마크는 RTX 4080에서 Ollama를 통해 실행된 14가지 인기 LLM의 성능을 RTX 4080으로 측정하기에서 무엇을 기대할 수 있는지를 정확히 보여줍니다.
BAML과 Instructor를 활용한 타입 안전한 LLM 출력
프로덕션 환경에서 대규모 언어 모델(LLM)을 사용할 때 구조화되고 타입 안전(structured, type-safe)한 출력을 얻는 것은 매우 중요합니다. 두 가지 인기 있는 프레임워크인 BAML과 Instructor는 이 문제를 해결하는 서로 다른 접근 방식을 취합니다.
지능형 토큰 최적화로 LLM 비용을 80% 절감하세요
토큰 최적화는 비용 효율적인 LLM 애플리케이션을 예산 소모 실험과 구분 짓는 핵심 기술입니다.
GPT-OSS 120b의 세 AI 플랫폼에서의 벤치마크
저는 Ollama에서 실행되는 GPT-OSS 120b의 성능 테스트 결과를 NVIDIA DGX Spark, Mac Studio, RTX 4080 세 가지 플랫폼에서 확인해보았습니다. Ollama 라이브러리에서 제공하는 GPT-OSS 120b 모델의 크기는 65GB로, RTX 4080의 16GB VRAM에 맞지 않으며, 더 최근의 RTX 5080에도 맞지 않습니다.
ASIC과 맞춤형 실리콘은 LLM 추론 속도와 효율성을 높입니다
두 모델의 속도, 파라미터 및 성능 비교
다음은 Qwen3:30b와 GPT-OSS:20b 비교 내용입니다. 지시 따름 능력(instruction following)과 성능 파라미터, 사양 및 속도에 초점을 맞추었습니다.
매우 좋지 않다.
Ollama의 GPT-OSS 모델은 특히 LangChain, OpenAI SDK, vllm과 같은 프레임워크와 함께 사용될 때 구조화된 출력을 처리하는 데 반복적으로 문제가 발생합니다.
조금 다른 API에는 특별한 접근 방식이 필요합니다.
다음은 인기 있는 LLM 제공업체들 간 구조화된 출력 (신뢰할 수 있는 JSON을 반환받는 것) 지원 상황의 나란한 비교표이며, 최소한의 Python 예제 코드도 함께 제공합니다.