

2026년, llama.cpp vs Ollama: 어떤 런타임을 선택해야 할까요?
“llama-server가 Ollama를 능가할 때”
Ollama와 llama.cpp는 종종 경쟁하는 추론 엔진으로 비교되곤 합니다. 실제 선택은 관리형 모델 서비스와 직접 운영하는 툴킷 사이의 결정에 가깝습니다.
“llama-server가 Ollama를 능가할 때”
Ollama와 llama.cpp는 종종 경쟁하는 추론 엔진으로 비교되곤 합니다. 실제 선택은 관리형 모델 서비스와 직접 운영하는 툴킷 사이의 결정에 가깝습니다.
엔진별로 적합한 AMD 백엔드 선택
ROCm과 Vulkan은 모두 로컬 LLM 호스팅을 위해 AMD GPU를 가속화하지만, 서로 대체재가 될 수 없습니다. 올바른 선택은 엔진, GPU, 그리고 워크로드에 따라 달라집니다.
AI 스택이 매월 더욱 강하게 고정되는 이유
모든 API 호출은 단순한 거래처럼 느껴집니다. 하지만 그 수가 쌓이면, 파인튜닝 데이터, 평가 하네스, 도구 스키마가 모두 하나의 벤더 주위에 형성되어, 벤더 전환이 더 이상 단순한 라우팅 변경이 아닌 상황이 됩니다.
Ollama에서 vLLM으로 전환해야 하는 시점
Ollama는 로컬 언어 모델을 실행하는 가장 간편한 방법 중 하나이지만, 편리함은 로컬 실험이 더 나은 스케줄링과 관측 가능성이 필요한 공유 추론 서비스로 전환되는 순간을 가릴 수 있습니다.
llama-server를 종료하지 않고도 VRAM을 확보하는 방법
llama.cpp 라우터 모드는 수년 동안 llama-server에 도입된 변화 중 가장 유용한 변화 중 하나입니다. 이는 로컬 LLM 운영자에게 Ollama에서 기대하는 모델 관리 경험에 가까운 기능을 제공하면서도, llama.cpp를 처음부터 사용하게 만드는 원시 성능과 저레벨 제어를 그대로 유지합니다.
재시작 없이 LLM을 서빙하고 교체합니다.
llama.cpp는 오랫동안 치명적인 한계점을 가지고 있었습니다. 바로 프로세스당 하나의 모델만 서빙할 수 있었고, 모델 전환을 하려면 프로세스를 재시작해야 했기 때문입니다.

로컬 LLM을 활용한 자체 호스팅 AI 검색
Vane은 “인용과 함께 하는 AI 검색” 분야에서 가장 실용적인 선택지 중 하나입니다. 이는 라이브 웹 검색과 로컬 또는 클라우드 LLM을 결합하는 자체 호스팅형 답변 엔진으로, 전체 스택을 사용자의 통제 아래에 두는 것이 특징입니다.
TGI 를 설치하고 빠르게 배포하며 더 빠르게 디버깅하세요.
Text Generation Inference(TGI) 는 매우 특유의 에너지를 지니고 있습니다. 추론 분야에서 가장 새로운 기술은 아니지만, 이미 프로덕션 환경에서 발생하는 문제를 잘 이해하고 있습니다.
공용 포트를 사용하지 않는 원격 Ollama 접근
Ollama 는 로컬 데몬 (daemon) 으로 취급될 때 가장 행복해합니다: CLI 와 애플리케이션이 루프백 HTTP API 와 통신하며, 나머지 네트워크는 Ollama 의 존재를 전혀 알지 못합니다.
GPU 및 영구 저장 기능을 갖춘 Compose 우선 Ollama 서버
Ollama는 베어 메탈(bare metal) 환경에서도 훌륭하게 작동합니다. 서비스처럼 다룰 때 더 재미가 생깁니다: 안정적인 엔드포인트, 고정된 버전, 영속적 저장소, 그리고 사용 가능하거나 불가능한 GPU.
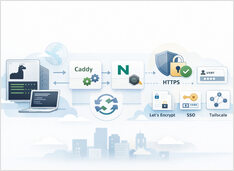
스트리밍 응답을 깨뜨리지 않고 HTTPS를 사용한 Ollama
리버스 프록시 뒤에 Ollama 를 실행하는 것은 HTTPS, 선택적 접근 제어, 예측 가능한 스트리밍 동작을 얻는 가장 간단한 방법입니다.
SGLang 로 오픈 모델을 빠르게 제공하세요.
SGLang 은 단일 GPU 에서 분산 클러스터에 이르기까지 저지연 및 고휘도 추론을 제공하도록 설계된 대규모 언어 모델 및 멀티모달 모델용 고성능 서비스 프레임워크입니다.
클라이언트 변경 없이 로컬 LLM을 핫스왑하세요.
가까운 미래에는 vLLM, llama.cpp 등 다양한 스택을 여러 포트에서 동시에 관리하게 될 것입니다. 하지만 다운스트림의 모든 시스템은 여전히 단일 /v1 기반 URL을 요구합니다. 그렇지 않으면 포트, 프로필, 일회용 스크립트를 계속 치환하는 수고스러운 일이 반복됩니다. llama-swap은 이러한 스택 앞단에 배치되는 /v1 프록시입니다.
분산형 로컬 AI 를 통해 OpenAI 호환 API 를 LocalAI 로 몇 분 안에 자체 호스팅하세요.
LocalAI 는 자신의 하드웨어 (노트북, 워크스테이션, 온프레미스 서버) 에서 AI 워크로드를 실행하기 위해 설계된 자체 호스팅, 로컬 우선 추론 서버로, OpenAI API 와의 호환성을 제공하여 기존 도구를 그대로 사용할 수 있도록 합니다.
CLI 및 서버에서 GGUF 모델 실행하기
llama.cpp는 GGUF 모델용 C/C++ 추론 엔진입니다: 대화형 챗에는 llama-cli, 스크립트된 프롬프트에는 llama-completion, OpenAI 호환 HTTP API에는 llama-server를 제공합니다.
자체 호스팅 LLM으로 데이터와 모델을 제어하세요
자체 호스팅 LLM은 데이터, 모델 및 추론을 당신의 통제 하에 유지하며, 팀, 기업, 국가를 위한 **AI 주권**으로 가는 실용적인 경로를 제시합니다.