
16GB GPU에서 Qwen 3.6 27B 및 35B MTP와 표준 모델 비교
RTX 4080에서 MTP와 표준 디코딩 비교 — 실제 벤치마크
Qwen 3.6 27B와 35B 모델에서 RTX 4080 16 GB VRAM 환경의 스펡추레이티브 디코딩(Speculative decoding, Multi-Token Prediction, MTP) 성능을 테스트했습니다.
동일한 하드웨어에서 더 많은 모델에 대한 토큰 속도 및 VRAM 트레이드오프를 폭넓게 살펴보려면 16 GB VRAM LLM 벤치마크 (llama.cpp 사용)를 참고하십시오.
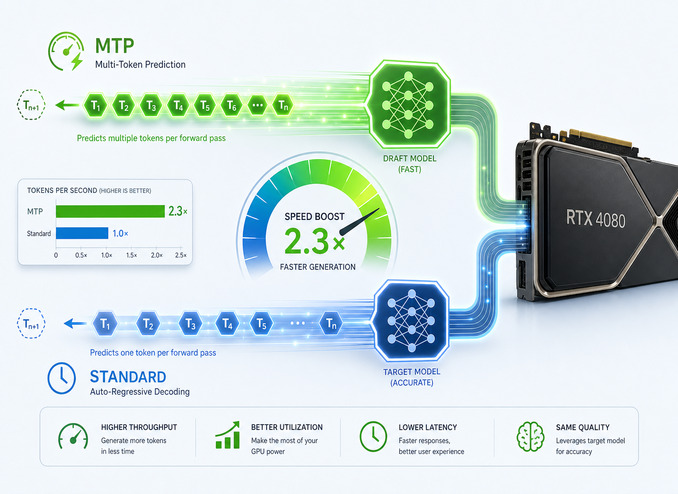
MTP(Multi-Token Prediction)란?
멀티 토큰 예측(Multi-Token Prediction)은 특정 모델 체크포인트에 직접 내장된 형태의 스펡추레이티브 디코딩입니다. 포워드 패스마다 하나의 토큰을 예측하는 대신, 모델은 ‘MTP 헤드’를 추가로 사용하여 단일 단계에서 여러 미래 토큰을 제안한 후 이를 병렬로 검증합니다. 추측이 채택되면 출력 품질이 변하지 않으면서도 실효적 처리량(Throughput)이 향상됩니다.
Qwen 3.6 시리즈는 standard(표준) GGUF 파일과 MTP 활성화 변형체(variants)를 모두 제공합니다. llama.cpp에서 MTP는 다음 명령어를 통해 활성화됩니다:
--spec-type draft-mtp --spec-draft-n-max 3
--spec-draft-n-max는 핵심 튜닝 파라미터입니다. MTP 헤드가 각 단계에서 제안하는 스펡추레이티브 토큰의 수를 설정합니다. 값이 높을수록 잠재적 속도 향상이 가능하지만, 드래프트 버퍼를 위한 추가 VRAM이 필요하므로 16 GB 카드에서는 실질적인 제약이 됩니다.
테스트 대상 및 방법
**VRAM 16 GB GPU (RTX 4080)**에서 두 Qwen 3.6 모델이 MTP 활성화 시와 표준 디코딩 시 어떻게 동작하는지 테스트했습니다.
모델 가중치와 KV 캐시를 VRAM에 맞추기 위해 강하게 양자화된 변형체를 사용했습니다:
Qwen3.6-27B-UD-IQ3_XXS및Qwen3.6-27B-UD-IQ3_XXS-MTPQwen3.6-35B-A3B-UD-IQ3_S및Qwen3.6-35B-A3B-UD-IQ3_S-MTP
각 실행(run)당 두 가지 컨텍스트 예산(Context Budget)을 추적합니다:
- Avg Ctx — llama.cpp가 약 14.8 GB의 VRAM을 차지하고, 기타 애플리케이션(Xorg, GNOME Shell, Cursor 등)에 약 500 MB의 여유 버퍼를 확보할 수 있는 컨텍스트 크기.
- Max Ctx — 동일한 데스크톱 애플리케이션이 이미 약 500 MB의 VRAM을 점유하고 있다는 전제 하에 llama.cpp가 할당할 수 있는 최대 컨텍스트.
평균 컨텍스트를 실질적인 목표치로 유지하는 주요 이유는 Hermes Agent 때문이며, 저는 이 머신에서 llama.cpp에 연결하는 주요 AI 어시스턴트로 Hermes Agent를 사용합니다. Hermes Agent는 기본적으로 최소 64 K 컨텍스트를 요구하며, 보다 작은 윈도우를 가진 모델은 시작 시 거부합니다. 해당 임계값 미만인 모델은 멀티 스텝 도구 호출 워크플로우를 위해 충분한 워킹 메모리를 유지할 수 없습니다. llama.cpp의 경우 이는 --ctx-size 65536 이상을 전달해야 함을 의미합니다. 따라서 평균 사용 가능 컨텍스트를 64 K보다 훨씬 작게 압축하는 MTP 구성은 일상적인 Hermes 워크로드에는 적합하지 않으므로, 아래 테이블의 Avg Ctx 수치가 가장 결정적인 기준이 됩니다.
두 가지 KV 캐시 양자화 레벨을 모두 테스트했습니다: q8(높은 품질, 더 많은 VRAM 사용)과 q5(낮은 VRAM 사용, 더 긴 컨텍스트). q8에서 q5 KV 캐시로 전환할 때 눈에 띄는 품질 저하가 발생할 수 있다는 점에 유의하십시오. 제 테스트에서는 q5가 저의 워크로드에 부적합할 정도로 품질 저하가 심했습니다. q5의 속도와 컨텍스트 수치는 완결성을 위해 포함되었으나, 이를 채택하기 전에 본인의 작업에서 응답 품질을 테스트해야 합니다.
Qwen 3.6 27B MTP vs 표준 디코딩
KV Cache q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prompt Speed | 148 t/s | 151 t/s | 148 t/s | 147 t/s | 200 t/s |
| Gen Speed | 65 t/s | 75 t/s | 73 t/s | 75 t/s | 45 t/s |
| Avg Ctx | 40 K | 40 K | 40 K | 30 K | 80 K |
| Max Ctx | 60 K | 60 K | 60 K | 50 K | 100 K |
q8 KV 캐시에서, --spec-draft-n-max 2인 MTP는 평균 컨텍스트 윈도우가 80 K에서 40 K로 절반으로 줄어드는 대가로 생성 속도가 약 67 % 향상됩니다 (45 t/s 대비 75 t/s). MTP가 프리필(prefill) 단계 동안 장치-호스트(device-to-host) 전송을 필요로 하기 때문에 프롬프트 처리 속도는 200 t/s에서 약 150 t/s로 떨어집니다.
KV Cache q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prompt Speed | 145 t/s | 144 t/s | 141 t/s | 139 t/s | 191 t/s |
| Gen Speed | 57 t/s | 62 t/s | 67 t/s | 66 t/s | 41 t/s |
| Avg Ctx | 70 K | 60 K | 60 K | 50 K | 130 K |
| Max Ctx | 100 K | 100 K | 90 K | 80 K | 160 K |
q5 KV 캐시로 전환하면 컨텍스트를 상당히 회복할 수 있습니다: --spec-draft-n-max 1은 57 t/s에서 70 K의 평균 컨텍스트를 제공하며, 이는 표준 디코딩 대비 생성 속도 39 % 향상과 동시에 컨텍스트 윈도우가 유용한 크기로 유지되는 결과를 가져옵니다. --spec-draft-n-max 3의 경우 컨텍스트는 60 K로 떨어지지만 생성 속도는 67 t/s에 도달합니다 (+63 %).
Qwen 3.6 27B 요약
MTP는 27B dense 모델에 실제로 유용합니다. 16 GB VRAM 환경의 최적 포인트는 다음과 같습니다:
- q8 KV +
--spec-draft-n-max 2— 최고의 순수 속도 (75 t/s), 컨텍스트는 40–60 K로 감소 - q5 KV +
--spec-draft-n-max 1— 최고의 속도-컨텍스트 균형 (57 t/s, 평균 컨텍스트 70 K)
Qwen 3.6 35B MTP vs 표준 디코딩
35B 모델은 Mixture-of-Experts(MoE) 아키텍처입니다 (35B-A3B는 전체 파라미터 35B, 토큰당 활성 약 3B를 의미합니다). MoE 모델은 일반적으로 MTP의 이점을 더 크게 얻습니다. 이는 희소 라우팅(Sparse routing)이 MTP 헤드가 전체 포워드 패스에 비해 계산적으로 훨씬 저렴하게 유지되도록 하기 때문입니다.
KV Cache q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_S) | |
|---|---|---|---|---|---|
| Prompt Speed | 277 t/s | 277 t/s | 265 t/s | 275 t/s | 368 t/s |
| Gen Speed | 186 t/s | 189 t/s | 180 t/s | 171 t/s | 146 t/s |
| Avg Ctx | 15 K | 10 K | — | — | 80 K |
| Max Ctx | 80 K | 70 K | 60 K | 50 K | 150 K |
MoE 아키텍처는 MTP 사용 시 인상적인 순수 생성 속도를 제공합니다 (max 1에서 +27 %, max 2에서 +29 %, 표준 146 t/s 대비). 그러나 실질적인 문제는 평균 컨텍스트입니다. q8 KV 캐시에서, --spec-draft-n-max 1조차도 15 K의 평균 컨텍스트만 제공하여, modest한 작업에도 간신히 충분한 수준입니다. 더 높은 드래프트 심도는 16 GB 카드에서는 실효적인 평균 컨텍스트를 전혀 제공하지 못합니다.
이것은 소비자 하드웨어에서 MTP의 핵심 VRAM 비용 문제입니다: 추가 드래프트 버퍼가 남은 VRAM 예산에 직접 영향을 미치며, q8 KV 캐시를 사용하는 35B-A3B 모델은 매우 적은 여유 공간(headroom)만을 남깁니다.
KV Cache q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_S) | |
|---|---|---|---|---|---|
| Prompt Speed | 264 t/s | 266 t/s | 270 t/s | 264 t/s | 343 t/s |
| Gen Speed | 151 t/s | 147 t/s | 137 t/s | 131 t/s | 122 t/s |
| Avg Ctx | 10 K | — | — | — | 120 K |
| Max Ctx | 120 K | 110 K | 110 K | 80 K | 200 K |
q5 KV 캐시는 평균 컨텍스트 상황을 약간만 개선합니다. --spec-draft-n-max 1은 151 t/s에서 10 K의 평균 컨텍스트를 제공합니다. q5의 표준 디코딩은 122 t/s에서 120 K의 평균 컨텍스트를 제공합니다.
Qwen 3.6 35B 요약
16 GB GPU에서 35B MoE 모델의 MTP는 강력한 벽에 부딪힙니다: 평균 사용 가능 컨텍스트가 10–15 K 토큰으로 붕괴되어 실제 워크로드에 비현실적입니다. 122–146 t/s의 속도와 80–120 K의 컨텍스트를 가진 표준 디코딩이 실제 작업에 훨씬 더 유용합니다.
24 GB 이상 VRAM이 있다면, 35B + MTP 조합은 훨씬 더 매력적이 됩니다 — 컨텍스트 윈도우 문제가 사라지고 속도 이점은 유지됩니다.
올바른 --spec-draft-n-max 값 선택
각 단계에서 제안할 스펡추레이티브 토큰 수(--spec-draft-n-max)에 대한 질문에는 유일한 정답이 없습니다. 모델 아키텍처와 사용 가능한 VRAM 모두에 따라 달라집니다:
- 16 GB의 27B dense 모델의 경우: q8 KV와 함께
--spec-draft-n-max 2가 가장 빠르고, q5 KV와 함께--spec-draft-n-max 1이 컨텍스트 관점에서 가장 유리합니다. - 16 GB의 35B MoE 모델의 경우:
--spec-draft-n-max 1만이 사용 가능한 컨텍스트를 유지하는 유일한 옵션이며,即便如此 그 정도도 간신히입니다. - 더 높은 값(
3,4)은 속도 향상에 비례하지 않는 VRAM 압박을 증가시킵니다 — max 4에서는 max 2와 거의 동일한 추가 VRAM을 소비하지만 생성 속도는 이를 따라가지 못합니다.
llama.cpp에서 MTP 활성화 방법
MTP 활성화가 포함된 GGUF 파일을 사용해야 합니다 (파일명에 MTP가 포함되어 있음). llama.cpp 플래그를 처음 접한다면 llama.cpp 빠른 시작: CLI 및 Server에서 모든 기초를 다룰 수 있습니다. 그런 다음 llama-server 또는 llama-cli를 다음처럼 실행하십시오:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 40000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
q5 KV 캐시를 위해 q8_0을 q5_1 또는 q5_0으로 변경하고 --ctx-size를 올려 조정하십시오:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 80000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 1
llama.cpp가 GGUF 파일에서 MTP 헤드를 감지하고 --spec-type draft-mtp가 설정되면 MTP가 자동으로 활성화됩니다.
따라서 표준 Qwen3.6-27B-UD-IQ3_XXS.gguf는 MTP 모드에서 동작하지 않으며, Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf가 필요합니다.
그러나 Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf는 스펡추레이티브 디코딩 모드와 자기 회귀(autoregressive) 모드 양쪽에서 모두 동작할 수 있습니다.
결론
16 GB GPU(RTX 4080)에서, 이러한 양자화 수준으로 볼 때 llama.cpp의 MTP는 Qwen 3.6 27B에게는 명확한 이점을, Qwen 3.6 35B에게는 실질적으로 부정적인 결과를 가져옵니다:
Qwen 3.6 27B (IQ3_XXS) — MTP가 가치가 있습니다:
- q8 KV + MTP max 2 → 생성 속도 약 67 % 향상, 컨텍스트 40–60 K (MTP 없을 때 80–100 K 대비)
- q5 KV + MTP max 1 → 생성 속도 약 39 % 향상, 컨텍스트 70–100 K (MTP 없을 때 130–160 K 대비)
--spec-draft-n-max 2에서 속도와 VRAM 효율의 좋은 균형 달성
Qwen 3.6 35B (IQ3_S) — 16 GB에서는 MTP가 비현실적입니다:
- 생성 속도는 27–29 % 더 빠르지만, q8에서 평균 컨텍스트는 10–15 K로, q5에서 10 K로 붕괴됩니다
- 122–146 t/s의 속도와 80–120 K의 컨텍스트를 가진 표준 디코딩이 실제 작업에 더 유용합니다
- 24 GB 이상 VRAM 환경에서는 상황이 크게 개선됩니다
이론적으로, MTP 속도 이점을 유지하면서 컨텍스트 윈도우를 극대화하기 위해 q5 KV 캐시가 당연한 답처럼 보입니다. 그러나 실무에서 q8에서 q5로 넘어갈 때의 품질 저하는 상당할 수 있습니다. 채택하기 전에 q5를 본인의 작업에서 테스트하십시오. 저의 워크로드에서는 열화가 허용할 수 없을 정도였으며, 더 빡빡한 컨텍스트 예산을 가진 q8이 여전히 더 나은 트레이드오프였습니다.
LLM 서빙 옵션과 인프라 트레이드오프의 더 넓은 그림을 보려면 2026년 LLM 호스팅 필러(Pillar)와 2026년 LLM 성능를 참고하십시오. 이 27B 클래스가 2026년 크기와 비용 스펙트럼에서 어디에 위치하는지, 그리고 왜 최신 Qwen3.8-27B Q4 빌드는 24 GB 카드가 필요하지만 위의 측정값은 16 GB를 유지하는지는 2026년 오픈 모델의 효율적 프론티어에 있습니다. Qwen 3.6 샘플러 설정을 MTP와 함께 조정하고 있다면, Qwen 3.6 및 Gemma 4를 위한 에이전틱 LLM 추론 파라미터 레퍼런스가 유용한 동반자입니다.
