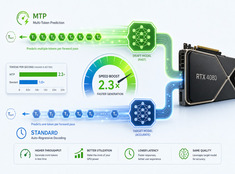
16GB GPU에서 Qwen 3.6 27B 및 35B MTP와 표준 모델 비교
RTX 4080에서의 MTP 대 표준 디코딩 — 실제 벤치마크
RTX 4080(16 GB VRAM) 환경에서 Qwen 3.6 27B 및 35B 모델의 추측 해독(Speculative decoding, 다중 토큰 예측(MTP)) 성능을 테스트했습니다.
RTX 4080에서의 MTP 대 표준 디코딩 — 실제 벤치마크
RTX 4080(16 GB VRAM) 환경에서 Qwen 3.6 27B 및 35B 모델의 추측 해독(Speculative decoding, 다중 토큰 예측(MTP)) 성능을 테스트했습니다.
llama-server를 종료하지 않고도 VRAM을 확보하는 방법
llama.cpp 라우터 모드는 수년 동안 llama-server에 도입된 변화 중 가장 유용한 변화 중 하나입니다. 이는 로컬 LLM 운영자에게 Ollama에서 기대하는 모델 관리 경험에 가까운 기능을 제공하면서도, llama.cpp를 처음부터 사용하게 만드는 원시 성능과 저레벨 제어를 그대로 유지합니다.
에이전틱 LLM 튜닝 참고 자료
이 페이지는 에이전트형 LLM 추론 튜닝에 대한 실용적인 참고 자료입니다(temperature, top_p, top_k, penalties 및 다단계 및 도구 중심 워크플로우에서의 상호 작용 방식).
재시작 없이 LLM을 서빙하고 교체합니다.
llama.cpp는 오랫동안 치명적인 한계점을 가지고 있었습니다. 바로 프로세스당 하나의 모델만 서빙할 수 있었고, 모델 전환을 하려면 프로세스를 재시작해야 했기 때문입니다.
llama.cpp의 16GB VRAM 기준 토큰 속도(표)
여기서는 16GB VRAM의 GPU에서 실행되는 여러 LLM의 속도를 비교하고, 셀프 호스팅을 위한 최적의 모델을 선택하는 과정입니다.
클라이언트를 변경하지 않고 로컬 LLM을 핫스왑합니다.
곧 vLLM, llama.cpp 등 여러 스택을 각각 다른 포트에서 관리하게 될 것입니다. 모든 다운스트림 시스템은 여전히 하나의 /v1 기본 URL 을 요구하며, 그렇지 않으면 포트, 프로필, 일회성 스크립트를 계속 조정해야 합니다. llama-swap은 이러한 스택들 앞에 위치한 /v1 프록시입니다.
OpenCode LLM 테스트 — 코딩 및 정확도 통계
로컬 호스팅된 Ollama 및 llama.cpp 기반 LLM들과 OpenCode가 어떻게 작동하는지 테스트해 보았습니다. 비교를 위해 OpenCode Zen의 일부 무료 모델도 추가했습니다.
OpenCode 설치, 설정 및 사용 방법
지역 추론(local inference)을 위해 llama.cpp에 계속 돌아오고 있습니다. Ollama 등 다른 도구들이 추상화해 버리는 부분까지 직접 제어할 수 있고, 실제로도 잘 작동하기 때문입니다. llama-cli로 GGUF 모델을 인터랙티브하게 실행하거나, llama-server로 OpenAI 호환 HTTP API를 노출하는 것이 매우 쉽습니다.