
셀프호스티드 딥 리서치 시스템: 12가지 도구 비교
검색을 넘어 연구를 수행하는 셀프호스트 에이전트
Deep Research는 이제 단순히 검색 박스에 적용되는 모델이 아니라, 독자적인 소프트웨어 카테고리가 되었습니다. 이 글에서는 12가지 셀프호스팅 시스템과 그 뒤를支撑하는 리서치 아키텍처를 비교합니다.
검색을 넘어 연구를 수행하는 셀프호스트 에이전트
Deep Research는 이제 단순히 검색 박스에 적용되는 모델이 아니라, 독자적인 소프트웨어 카테고리가 되었습니다. 이 글에서는 12가지 셀프호스팅 시스템과 그 뒤를支撑하는 리서치 아키텍처를 비교합니다.

“llama-server가 Ollama를 능가할 때”
Ollama와 llama.cpp는 종종 경쟁하는 추론 엔진으로 비교되곤 합니다. 실제 선택은 관리형 모델 서비스와 직접 운영하는 툴킷 사이의 결정에 가깝습니다.
엔진별로 적합한 AMD 백엔드 선택
ROCm과 Vulkan은 모두 로컬 LLM 호스팅을 위해 AMD GPU를 가속화하지만, 서로 대체재가 될 수 없습니다. 올바른 선택은 엔진, GPU, 그리고 워크로드에 따라 달라집니다.
16GB에서 128K 컨텍스트가 실패하는 이유
모델은 128K 컨텍스트 윈도우를 광고하면서도 16 GB GPU에서 40K 토큰에서 실패할 수 있습니다. 아키텍처 상한은 웨이트, KV 캐시, 컴퓨트 버퍼, 데스크톱 컴포지터가 모두 동시에 해당 카드에 들어맞겠다는 약속을 한 적이 없습니다.
AI 스택이 매월 더욱 강하게 고정되는 이유
모든 API 호출은 단순한 거래처럼 느껴집니다. 하지만 그 수가 쌓이면, 파인튜닝 데이터, 평가 하네스, 도구 스키마가 모두 하나의 벤더 주위에 형성되어, 벤더 전환이 더 이상 단순한 라우팅 변경이 아닌 상황이 됩니다.
Ollama에서 vLLM으로 전환해야 하는 시점
Ollama는 로컬 언어 모델을 실행하는 가장 간편한 방법 중 하나이지만, 편리함은 로컬 실험이 더 나은 스케줄링과 관측 가능성이 필요한 공유 추론 서비스로 전환되는 순간을 가릴 수 있습니다.
로컬 LLM을 활용한 자체 호스팅 AI 검색
Vane은 “인용과 함께 하는 AI 검색” 분야에서 가장 실용적인 선택지 중 하나입니다. 이는 라이브 웹 검색과 로컬 또는 클라우드 LLM을 결합하는 자체 호스팅형 답변 엔진으로, 전체 스택을 사용자의 통제 아래에 두는 것이 특징입니다.
공용 포트를 사용하지 않는 원격 Ollama 접근
Ollama 는 로컬 데몬 (daemon) 으로 취급될 때 가장 행복해합니다: CLI 와 애플리케이션이 루프백 HTTP API 와 통신하며, 나머지 네트워크는 Ollama 의 존재를 전혀 알지 못합니다.
GPU 와 영속성을 갖춘 Compose 우선 Ollama 서버
Ollama 는 베어 메탈 (bare metal) 환경에서 훌륭하게 작동합니다. 이를 서비스처럼 다룰 때 더욱 흥미로운데, 안정적인 엔드포인트, 고정된 버전, 영구 저장소, 그리고 GPU 가 있거나 없는 명확한 상태를 보장받기 때문입니다.
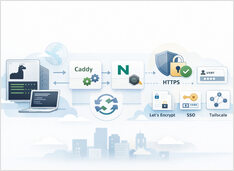
스트리밍 응답을 깨뜨리지 않고 HTTPS를 사용한 Ollama
리버스 프록시 뒤에 Ollama 를 실행하는 것은 HTTPS, 선택적 접근 제어, 예측 가능한 스트리밍 동작을 얻는 가장 간단한 방법입니다.
RAG 임베딩 - Python, Ollama, OpenAI API.
검색 증강 생성 (RAG)을 공부 중이시라면, 이 섹션에서는 텍스트 임베딩이 무엇인지, 검색 및 검색 (retrieval) 과 어떻게 연관되는지, 그리고 Ollama 또는 OpenAI 호환 HTTP API(많은 llama.cpp 기반 서버에서 제공하는 방식) 를 사용하여 Python에서 두 가지 일반적인 로컬 설정을 호출하는 방법을 쉽게 설명합니다.
OpenCode LLM 테스트 — 코딩 및 정확도 통계
로컬 호스팅된 Ollama 및 llama.cpp 기반 LLM들과 OpenCode가 어떻게 작동하는지 테스트해 보았습니다. 비교를 위해 OpenCode Zen의 일부 무료 모델도 추가했습니다.
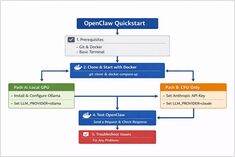
로컬에 Ollama를 사용하여 OpenClaw 설치
OpenClaw는 Ollama와 같은 로컬 LLM 런타임이나 Claude Sonnet과 같은 클라우드 기반 모델과 함께 실행하도록 설계된 셀프 호스팅(Self-hosted) AI 어시스턴트입니다.
자체 호스팅 LLM으로 데이터와 모델을 제어하세요
자체 호스팅 LLM은 데이터, 모델 및 추론을 당신의 통제 하에 유지하며, 팀, 기업, 국가를 위한 **AI 주권**으로 가는 실용적인 경로를 제시합니다.