
Llama-Server 라우터 모드 - 재시작 없는 동적 모델 전환
재시작 없이 LLM을 서빙하고 교체합니다.
llama.cpp는 오랫동안 치명적인 한계점을 가지고 있었습니다. 바로 프로세스당 하나의 모델만 서빙할 수 있었고, 모델 전환을 하려면 프로세스를 재시작해야 했기 때문입니다.
재시작 없이 LLM을 서빙하고 교체합니다.
llama.cpp는 오랫동안 치명적인 한계점을 가지고 있었습니다. 바로 프로세스당 하나의 모델만 서빙할 수 있었고, 모델 전환을 하려면 프로세스를 재시작해야 했기 때문입니다.
SGLang 로 오픈 모델을 빠르게 제공하세요.
SGLang 은 단일 GPU 에서 분산 클러스터에 이르기까지 저지연 및 고휘도 추론을 제공하도록 설계된 대규모 언어 모델 및 멀티모달 모델용 고성능 서비스 프레임워크입니다.
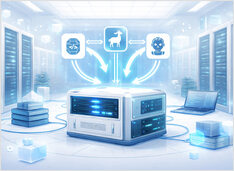
클라이언트 변경 없이 로컬 LLM을 핫스왑하세요.
가까운 미래에는 vLLM, llama.cpp 등 다양한 스택을 여러 포트에서 동시에 관리하게 될 것입니다. 하지만 다운스트림의 모든 시스템은 여전히 단일 /v1 기반 URL을 요구합니다. 그렇지 않으면 포트, 프로필, 일회용 스크립트를 계속 치환하는 수고스러운 일이 반복됩니다. llama-swap은 이러한 스택 앞단에 배치되는 /v1 프록시입니다.
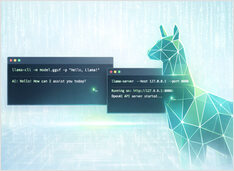
CLI 및 서버에서 GGUF 모델 실행하기
llama.cpp는 GGUF 모델용 C/C++ 추론 엔진입니다: 대화형 챗에는 llama-cli, 스크립트된 프롬프트에는 llama-completion, OpenAI 호환 HTTP API에는 llama-server를 제공합니다.