2026년 LLM 호스팅: 로컬, 자체 호스팅, 클라우드 인프라 비교
대형 언어 모델(LLM)은 더 이상 하이퍼스케일 클라우드 API에 국한되지 않습니다. 2026년에는 LLM을 다음과 같이 호스팅할 수 있습니다:
- 소비자용 GPU
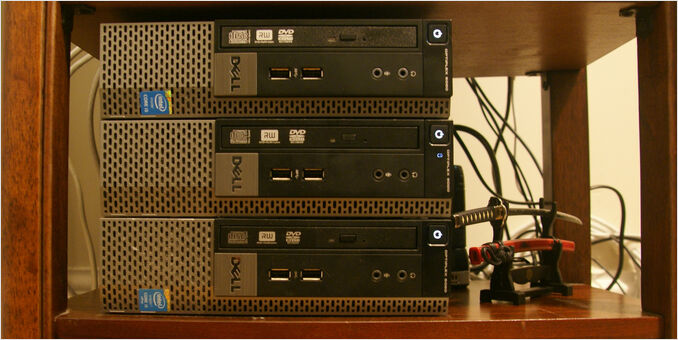
- 로컬 서버
- 컨테이너화 환경
- 전용 AI 워크스테이션
- 또는 클라우드 제공업체를 통해 완전히
더 이상 중요한 질문은 **“LLM을 실행할 수 있는가?”**가 아닙니다.
진정으로 중요한 질문은 다음과 같습니다:
제 워크로드, 예산, 제어 요구 사항에 맞는 올바른 LLM 호스팅 전략은 무엇인가?
이 pillar 페이지는 현대적인 LLM 호스팅 접근 방식을 분해하여 설명하고, 가장 관련성이 높은 도구들을 비교하며, 스택 전반에 걸친 심층 분석 페이지로 연결합니다.
LLM 호스팅이란 무엇인가?
LLM 호스팅은 추론을 위해 대형 언어 모델을 실행하는 방법과 장소를 의미합니다. 호스팅 결정은 다음과 같은 요소에 직접적인 영향을 미칩니다:
- 지연 시간(Latency)
- 처리량(Throughput)
- 요청당 비용
- 데이터 프라이버시
- 인프라 복잡성
- 운영 제어
LLM 호스팅은 단순히 도구를 설치하는 것이 아닙니다. 이는 인프라 설계 결정입니다.
LLM 호스팅 결정 매트릭스
| 접근 방식 | 적합한 용도 | 필요한 하드웨어 | 프로덕션 준비도 | 제어 |
|---|---|---|---|---|
| Ollama | 로컬 개발, 소규모 팀 | 소비자용 GPU / CPU | 제한된 규모 | 높음 |
| llama.cpp | GGUF 모델, CLI/서버, 오프라인 | CPU / GPU | 예 (llama-server) | 매우 높음 |
| Strata | 소비자용 GPU 1개에서 Qwen3.8-Flash-Next 실행 | GPU + 고정된 RAM + SSD | 단일 사용자 에이전트 | 높음 |
| vLLM | 고처리량 프로덕션 | 전용 GPU 서버 | 예 | 높음 |
| TGI | Hugging Face 모델, 스트리밍, 지표 | 전용 GPU 서버 | 예 | 높음 |
| SGLang | HF 모델, OpenAI + 네이티브 API | 전용 GPU 서버 | 예 | 높음 |
| llama-swap | /v1 URL 1개, 로컬 백엔드 여러 개 |
다양 (프록시 전용) | 중간 | 높음 |
| Docker Model Runner | 컨테이너화된 로컬 설정 | GPU 권장 | 중간 | 높음 |
| LocalAI | OSS 실험 | CPU / GPU | 중간 | 높음 |
| 클라우드 제공업체 | 제로-옵스(Zero-ops) 스케일링 | 없음 (원격) | 예 | 낮음 |
각 옵션은 스택의 다른 계층을 해결합니다.
로컬 LLM 호스팅
로컬 호스팅을 통해 얻을 수 있는 이점은 다음과 같습니다:
- 모델에 대한 완전한 제어
- 토큰당 API 요금 없음
- 예측 가능한 지연 시간
- 데이터 프라이버시
단점으로는 하드웨어 제약, 유지보수 부담, 스케일링 복잡성이 있습니다.
Ollama
Ollama는 가장 널리 채택된 로컬 LLM 런타임 중 하나입니다.
다음과 같은 경우 Ollama를 사용하십시오:
- 빠른 로컬 실험이 필요한 경우
- 간단한 CLI + API 액세스를 원하는 경우
- 소비자용 하드웨어에서 모델을 실행하는 경우
- 최소한의 구성을 선호하는 경우
Ollama를 NVIDIA GPU와 지속적 모델이 포함된 재현 가능한 컨테이너, Caddy 또는 Nginx를 통한 HTTPS 및 스트리밍이 포함된 안정적인 단일 노드 엔드포인트로 활용하고자 할 때, 하단의 Compose 및 리버스 프록시 가이드는 홈 랩이나 내부 배포에 일반적으로 중요한 설정을 다루고 있습니다.
여기서 시작하십시오:
- Ollama 치트시트
- Ollama 모델 이동
- GPU와 지속적 모델 저장소를 갖춘 Docker Compose 환경의 Ollama
- Caddy 또는 Nginx 리버스 프록시 후면의 Ollama를 통한 HTTPS 스트리밍
- Tailscale 또는 WireGuard를 통한 원격 Ollama 액세스, 공개 포트 없음
- Python으로 Ollama 사용 예제
- Go로 Ollama 사용
- Ollama의 DeepSeek R1
Ollama의 웹 검색 기능을 활용하여 지능형 검색 에이전트를 구축하기 위해:
운영 및 품질 관점:
- Ollama에서 번역 품질 비교
- Ollama에서 Cognee에 적합한 LLM 선택
- Cognee 셀프 호스팅: Ollama에서 LLM 선택
- Ollama의 기능 저하(Enshittification)
llama.cpp
llama.cpp는 GGUF 모델을 위한 경량의 C/C++ 추론 엔진입니다. 다음과 같은 경우 사용하십시오:
-
메모리, 스레드, 컨텍스트에 대한 세밀한 제어를 원할 때
-
Python 스택 없이 오프라인 또는 엣지 배포가 필요할 때
-
인터랙티브 사용에는
llama-cli, OpenAI 호환 API에는llama-server를 선호할 때 -
16GB GPU에서 Qwen 3.6 MTP 대 표준 디코딩 — 16GB 카드에서 내장된 추측 디코딩의 측정된 생성 속도 및 VRAM 트레이드오프
Strata
Strata는 Qwen3.8-Flash-Next를 위한 특수화된 엔진입니다. 이는 어텐션과 핫 익스퍼트 캐시를 GPU에 유지하고, 모든 24,576개의 라우팅된 익스퍼트를 시스템 RAM에 고정하며, 28.8GB의 n-gram 테이블을 SSD에서 읽습니다. 125B MoE가 모델이며 단일 소비자용 GPU가 체크포인트를 보유할 수 없는 경우 사용하십시오. 64GB 데스크톱에서는 팩을 여전히 머신의 나머지 부분에 여유 공간을 남기는 경우가 도구 호출이 실패하는 경우입니다.
- Strata를 사용하여 로컬에서 Qwen3.8-Flash-Next 실행: 64GB 빠른 시작 — 설치, RAM 예산, Strata 0.2.11에서의 샘플링 및 도구 호출 복구, 그리고 RTX 5090이 탑재된 64GB 박스에서의 측정된 실패 사례
llama.swap
llama-swap (일반적으로 llama.swap으로 표기됨)은 추론 엔진이 아닌 모델 스위처 프록시입니다: 여러 로컬 백엔드(llama-server, vLLM, 기타) 앞에 하나의 OpenAI 또는 Anthropic 형태 엔드포인트를 제공합니다. 다음과 같은 경우 사용하십시오:
-
IDE 및 SDK를 위한 안정적인
base_url및/v1표면이 필요할 때 -
서로 다른 모델이 서로 다른 프로세스 또는 컨테이너에 의해 서비스될 때
-
오직 올바른 업스트림만 상주하도록 핫 스왑, TTL 언로드, 또는 그룹이 필요할 때
Docker Model Runner
Docker Model Runner는 컨테이너화된 모델 실행을 가능하게 합니다.
다음과 같은 경우에 가장 적합합니다:
- Docker-first 환경
- 격리된 배포
- 명시적인 GPU 할당 제어
심층 분석:
비교:
vLLM
vLLM은 고처리량 추론에 초점을 맞춥니다. 다음과 같은 경우 선택하십시오:
-
동시 프로덕션 워크로드를 서비스할 때
-
“그냥 작동하는 것"보다 처리량이 더 중요할 때
-
더 프로덕션 지향적인 런타임을 원할 때
이미 Ollama를 실행 중이며 동시 트래픽, 큐잉, 또는 다중 GPU 요구 사항이 이동을 정당화하는지 결정하고자 하는 경우, Ollama에서 vLLM으로: 로컬 LLM 서버를 언제 이전해야 하는가에서는 이전 신호와 단계별 롤아웃 계획을 다룹니다.
TGI (Text Generation Inference)
Text Generation Inference는 Hugging Face의 Transformers 모델용 HTTP 서빙 스택입니다: 연속 배칭, 토큰 스트리밍, 텐서 병렬 샤딩, Prometheus 지표, 그리고 OpenAI 호환 메시지 API를 제공합니다. 다음과 같은 경우 선택하십시오:
-
성숙한 라우터 + 모델 서버 분리 및 1급 **관측가능성(Observability)**이 필요할 때
-
모델과 가중치가 Hugging Face 생태계에 존재할 때
-
업스트림이 유지보수 모드에 있음을 받아들이며(안정적인 표면, 느린 기능 변동)
SGLang
SGLang은 Hugging Face 스타일 모델을 위한 고처리량 서빙 프레임워크입니다: OpenAI 호환 HTTP API, 네이티브 /generate 경로, 그리고 인-프로세스 배치 워크를 위한 오프라인 Engine을 제공합니다. 다음과 같은 경우 선택하십시오:
-
강력한 처리량과 런타임 기능(배칭, 어텐션 최적화, 구조화된 출력)을 갖춘 프로덕션 지향적 서빙을 원할 때
-
GPU 클러스터 또는 무거운 단일 호스트 설정에서 vLLM의 대안을 비교할 때
-
YAML / CLI 서버 구성 및 선택적 Docker-first 설치가 필요할 때
LocalAI
LocalAI는 유연성과 멀티모달 지원에 초점을 맞춘 OpenAI 호환 추론 서버입니다. 다음과 같은 경우 선택하십시오:
-
자체 하드웨어에서 OpenAI API의 드롭인 대체품이 필요할 때
-
워크로드가 텍스트, 임베딩, 이미지, 또는 오디오를 넘나들 때
-
API와 함께 내장된 웹 UI를 원할 때
-
가장 넓은 모델 형식 지원(GGUF, GPTQ, AWQ, Safetensors, PyTorch)이 필요할 때
클라우드 LLM 호스팅
클라우드 제공업체는 하드웨어를 완전히 추상화합니다.
장점:
- 즉시 스케일링 가능
- 관리되는 인프라
- GPU 투자 없음
- 빠른 통합
트레이드오프:
- 반복적인 API 비용
- 파인 튜닝 데이터, 평가 하네스, 그리고 도구 스키마가 하나의 제공업체에 묶여 있을수록 복합적으로 증가하는 벤더 락인(Vendor lock-in)
- 감소된 제어
프로바이더 개요:
호스팅 비교
“어떤 런타임으로 호스팅해야 하나?“라는 결정을 내리는 경우, 여기서 시작하십시오:
- LLM 호스팅: Ollama 대 LocalAI 대 Jan 대 LM Studio 대 vLLM
- Ollama에서 vLLM으로: 로컬 LLM 서버를 언제 이전해야 하는가
- AMD 로컬 LLM 호스팅을 위한 ROCm 대 Vulkan: 2026 가이드
- 2026년 llama.cpp 대 Ollama: 어떤 런타임을 실행해야 하는가?
LLM 프론트엔드 및 인터페이스
모델 호스팅은 시스템의 일부일 뿐이며, 프론트엔드가 중요합니다.
- LLM 프론트엔드 개요
- Open WebUI: 개요, 빠른 시작, 대안
- 로컬 Ollama LLM용 채팅 UI
- Ollama와 함께 Perplexica 셀프 호스팅
- Ollama 및 llama.cpp와 함께 Vane (Perplexica 2.0) 빠른 시작
RAG에 초점을 맞춘 프론트엔드 비교:
셀프 호스팅 및 주권
로컬 제어, 프라이버시, 그리고 API 제공업체로부터의 독립성을 중시하는 경우:
- LLM 셀프 호스팅 및 AI 주권
- 데이터 중력: API-first AI의 진정한 비용 — 그 의존성 뒤의 4단계 메커니즘, 그리고 그것이 얼마나 깊게 뿌려져 있는지를 점수화하기 위한 점검표
성능 고려 사항
호스팅 결정은 성능 제약과 긴밀히 결합되어 있습니다:
- CPU 코어 활용도
- 병렬 요청 처리
- 메모리 할당 동작
- 처리량 대 지연 시간 트레이드오프
관련 성능 심층 분석:
벤치마크 및 런타임 비교:
- DGX Spark 대 Mac Studio 대 RTX 4080
- 16GB VRAM GPU에서 Ollama를 위한 최적 LLM 선택
- AI용 NVIDIA GPU 비교
- 논리적 오류: LLM 속도
- LLM 요약 능력
- Mistral Small 대 Gemma2 대 Qwen2.5 대 Mistral Nemo
- Gemma2 대 Qwen2 대 Mistral Nemo 12B
- Qwen3 30B 대 GPT-OSS 20B
비용 대 제어 트레이드오프
| 요인 | 로컬 호스팅 | 클라우드 호스팅 |
|---|---|---|
| 초기 비용 | 하드웨어 구매 | 없음 |
| 지속 비용 | 전기료 | 토큰 과금 |
| 프라이버시 | 높음 | 낮음 |
| 확장성 | 수동 | 자동 |
| 유지보수 | 사용자 관리 | 제공업체 관리 |
런타임을 실행 중인 다음, 다음 결정 세트는 아키텍처적입니다: 어떤 모델이 어떤 요청을 처리하는지, 토큰 비용을 어떻게 관리할지, 입력과 출력을 어떻게 검증할지. 이러한 설계 패턴은 LLM 아키텍처 클러스터에 있습니다.
언제 무엇을 선택해야 하는가
Ollama를 선택하는 경우:
- 가장 간단한 로컬 설정을 원할 때
- 내부 도구나 프로토타입을 실행할 때
- 최소한의 마찰을 선호할 때
llama.cpp를 선택하는 경우:
- GGUF 모델을 실행하고 최대의 제어를 원할 때
- Python 없이 오프라인 또는 엣지 배포가 필요할 때
- CLI 사용에는 llama-cli, OpenAI 호환 API에는 llama-server를 원할 때
Strata를 선택하는 경우:
- 모델이 Qwen3.8-Flash-Next이고 VRAM에 맞지 않을 때
- 시스템 RAM에 익스퍼트 샤드를 고정하고 n-gram 테이블을 SSD에 유지할 수 있을 때
- 워크로드가 단일 사용자 에이전트나 로컬 OpenAI 호환 엔드포인트이며, 멀티 테넌트 서버가 아닐 때
vLLM을 선택하는 경우:
- 동시 프로덕션 워크로드를 서비스할 때
- 처리량과 GPU 효율성이 필요할 때
SGLang을 선택하는 경우:
- SGLang의 기능 세트와 배포 옵션을 갖춘 vLLM 클래스 서빙 런타임을 원할 때
- OpenAI 호환 서빙 및 네이티브
/generate또는 오프라인 Engine 워크플로가 필요할 때
llama-swap를 선택하는 경우:
- 이미 여러 OpenAI 호환 백엔드를 실행 중이며 모델 기반 라우팅 및 스왑/언로드가 있는 하나의
/v1URL을 원할 때
LocalAI를 선택하는 경우:
- 로컬 하드웨어에서 멀티모달 AI(텍스트, 이미지, 오디오, 임베딩)가 필요할 때
- OpenAI API의 최대 드롭인 호환성을 원할 때
- 팀이 API와 함께 내장된 웹 UI를 필요로 할 때
클라우드를 선택하는 경우:
- 하드웨어 없이 빠른 스케일링이 필요할 때
- 반복적 비용과 벤더 트레이드오프를 받아들일 수 있을 때
하이브리드를 선택하는 경우:
- 로컬에서 프로토타입을 만들 때
- 중요한 워크로드를 클라우드로 배포할 때
- 가능한 곳에서 비용 제어를 유지할 때
자주 묻는 질문
로컬에서 LLM을 호스팅하는 가장 좋은 방법은 무엇인가?
대부분의 개발자에게 Ollama는 가장 간단한 진입점입니다. 고처리량 서빙의 경우, vLLM과 같은 런타임을 고려하십시오.
셀프 호스팅이 OpenAI API보다 저렴한가?
사용 패턴과 하드웨어 상각화에 달려 있습니다. 워크로드가 일정하고 높은 부피라면, 셀프 호스팅은 종종 예측 가능하고 비용 효율적이 됩니다.
GPU 없이 LLM을 호스팅할 수 있는가?
예, 하지만 추론 성능이 제한되고 지연 시간이 더 길어집니다.
Ollama가 프로덕션에 준비되었는가?
소규모 팀과 내부 도구의 경우, 예입니다. 고처리량 프로덕션 워크로드의 경우, 특수화된 런타임과 더 강력한 운영 도구가 필요할 수 있습니다.
