Selfhosting

Syncthing File Sync dla samodzielnie hostowanych systemów wiedzy

Syncthing File Sync dla samodzielnie hostowanych systemów wiedzy

Przesyłanie danych lokalnych w trybie prywatnym

Syncthing synchronizuje pliki między urządzeniami, które kontrolujesz, co czyni go jednym z najbardziej praktycznych narzędzi w infrastrukturze samohostowanej wiedzy, pozwalającej uniknąć zależności od usług chmurowych.
GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

GPU dla sztucznej inteligencji w 2026 roku: porównanie NVIDIA, AMD i Intela

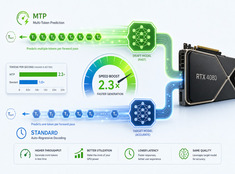
Porównanie GPU AI trzech dostawców

Krajobraz sprzętu do sztucznej inteligencji uległ znaczącej zmianie w 2026 roku, przy czym NVIDIA, AMD i Intel rywalizują o deweloperów potrzebujących kart graficznych (GPU) zdolnych do uruchamiania lokalnie dużych modeli językowych (LLM) oraz obciążeń wnioskowania (inference).

Agent Hermes: konfiguracja bezserwerowa + zdalny pulpit

Agent Hermes: konfiguracja bezserwerowa + zdalny pulpit

Serwer Headless Hermes z dostępem do zdalnego pulpitu

Uruchamianie Hermes Agent na serwerze headless (bez interfejsu graficznego) z jednoczesnym połączeniem klienta desktopowego z innego komputera wymaga uruchomienia dwóch procesów po stronie serwera oraz jednego połączenia klienckiego.

Systemy pamięci w asystentach AI

Systemy pamięci w asystentach AI

Pamięć robocza, strukturalna i odzyskiwania dla asystentów.

Pamięć zamienia asystentów w systemy trwałych, a nie tylko reaktywnych, ale to właśnie tam wiele systemów cichnie i podlega degradacji. Ankiety wskazują, że podział na pamięć krótkotrwałą i długotrwałą już nie wystarczy dla pamięci nowoczesnych agentów; SDK OpenAI i LangGraph wskazują na prostszy stos — pamięć roboczą, trwały stan i pobieranie danych (retrieval).

Usuń wszystkie modele routera llama.cpp bez restartowania

Usuń wszystkie modele routera llama.cpp bez restartowania

Darmowa pamięć VRAM bez zabijania llama-server.

Tryb routera w llama.cpp to jedna z najbardziej przydatnych zmian wprowadzonych do llama-server w ciągu ostatnich lat. Wreszcie daje lokalnym operatorom modeli LLM coś w rodzaju zarządzania modelami, do którego są przyzwyczajeni z Ollama, jednocześnie zachowując surową wydajność i kontrolę na niskim poziomie, która sprawia, że warto korzystać z llama.cpp w pierwszej kolejności.

Sterowanie głosem Hermes z telefonu

Sterowanie głosem Hermes z telefonu

Pozwól, by Hermes rozmawiał z Tobą przez telefon

Już teraz rozmawiasz z agentem Hermes przez telefon za pomocą wiadomości tekstowych. Teraz chcesz rozmawiać z nim bezpośrednio i otrzymywać odpowiedzi w formie mowy. Zazwyczaj jest to słuszny krok, zwłaszcza jeśli już korzystasz z Hermesa jako trwałego, lokalnie hostowanego asystenta. Pisanie długich promptów na małym ekranie jest powolne i podatne na błędy.

Tworzenie umiejętności dla Agenta Hermesa — struktura pliku SKILL.md i najlepsze praktyki

Tworzenie umiejętności dla Agenta Hermesa — struktura pliku SKILL.md i najlepsze praktyki

Hermes oferuje szybko ładujące się i niezawodnie działające umiejętności.

Hermes Agent traktuje umiejętności (skills) jako domyślną metodę nauczania powtarzalnych workflow. Oficjalna dokumentacja opisuje je jako dokumenty wiedzy dostarczane na żądanie, zgodne z otwartym formatem agentskills.io, ładowane przez postępującą ekspozycję (progressive disclosure), dzięki czemu model widzi najpierw mały indeks i pobiera pełne instrukcje dopiero wtedy, gdy zadanie ich faktycznie wymaga.