
Wzlot i upadek OpenClaw – harmonogram i prawdziwe przyczyny załamania
OpenClaw zyskał na sile błyskawicznie, by równie szybko zniknąć.
OpenClaw nie przegrał jako produkt. Po prostu wyczerpało się jego paliwo.
OpenClaw zyskał na sile błyskawicznie, by równie szybko zniknąć.
OpenClaw nie przegrał jako produkt. Po prostu wyczerpało się jego paliwo.
Serwuj i przełączaj modele LLM bez restartów.
Przez długi czas llama.cpp miała rażący ograniczenie:
można było obsłużyć tylko jeden model na proces, a przełączanie wymagało ponownego uruchomienia.
Porównanie narzędzi PKM, metod oraz wików self-hosted.
Osobiste zarządzanie wiedzą obejmuje Obsidian, Logseq, DokuWiki, Zettelkasten oraz metodę PARA – właściwy wybór zależy od tego, czy preferujesz lokalny graf notatek, wiki hostowane samodzielnie, czy też workflow oparty na outlinerze.
Konfiguracje Hermes oparte na profilach dla wymagających obciążen
Asystent AI Hermes, oficjalnie dokumentowany jako Hermes Agent, nie jest pozycjonowany jako prosty interfejs czatu.
Umiejętności, które warto rozwijać, i te, które można pominąć
OpenClaw posiada dwa rodzaje rozszerzeń, które łatwo pomylić.
Wtyczki rozszerzają środowisko wykonawcze. Umiejętności (Skills) rozszerzają zachowanie agenta.
Najpierw wtyczki. Krótko o nazewnictwie umiejętności.
Ten artykuł dotyczy wtyczek OpenClaw — natywnych pakietów bramkowych, które dodają kanały, dostawców modeli, narzędzia, funkcje głosowe, pamięć, media, wyszukiwanie w sieci oraz inne warstwy środowiska wykonawczego.
Jak naprawdę są skonstruowane systemy OpenClaw
OpenClaw wygląda prosto w demonstracjach. W środowisku produkcyjnym staje się on systemem.

Własna wyszukiwarka AI z lokalnymi modelami LLM
Vane to jeden z bardziej pragmatycznych projektów w przestrzeni „AI-search z cytatami”: samodzielnie hostowany silnik odpowiedzi, który łączy wyszukiwanie na żywej sieci z modelami LLM (lokalnymi lub w chmurze), a jednocześnie pozwala zachować pełną kontrolę nad całym stackiem.
Instalacja i szybki start Hermes Agenta dla deweloperów
Hermes Agent to self-hostowany, model-agnostyczny asystent AI działający na lokalnym komputerze lub tanim VPS. Działa przez interfejs terminalowy i komunikacyjny, a z czasem się doskonali, zamieniając powtarzalne zadania w wielokrotnie użyteczne umiejętności.
Zainstaluj TGI, wdrażaj szybko, debuguj jeszcze szybciej.
Text Generation Inference (TGI) ma bardzo specyficzną energię. Nie jest najmłodszym dzieckiem na ulicy inferencji, ale jest tym, które już nauczyło się, jak produkcja się psuje –
SGLang – szybkie uruchamianie otwartych modeli.
SGLang to wysokowydajny framework do obsługi dużych modeli językowych i multimodalnych, zaprojektowany do zapewnienia niskiego opóźnienia i wysokiej przepustowości podczas wnioskowania, niezależnie od tego, czy działa na pojedynczej karcie GPU, czy w rozproszonych klastrach.
Gorąca wymiana lokalnych LLMów bez zmian w klientach.
Wkrótce będziesz jugglingiem w vLLM, llama.cpp i wielu innych — każdy stack na własnym porcie. Wszystkie komponenty dół wciąż wymagają jednego /v1 bazowego adresu URL; inaczej będziesz w nieskończoność przesuwać porty, profile i jednorazowe skrypty. llama-swap to /v1 proxy umieszczane przed tymi stackami.
Większość lokalnych konfiguracji AI zaczyna się od modelu i środowiska wykonawczego.
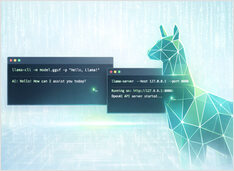
Uruchamiaj modele GGUF za pomocą CLI i serwera
llama.cpp to silnik inferencji w językach C/C++ dla modeli GGUF: llama-cli do interaktywnego czatu, llama-completion do skryptowych promptów oraz llama-server dla kompatybilnego z OpenAI interfejsu API HTTP.
Poradnik asystenta AI OpenClaw
Większość lokalnych konfiguracji AI zaczyna się w ten sam sposób: model, środowisko wykonawcze i interfejs czatu.
Porównaj headless CMS – funkcje, wydajność i przypadki użycia
Wybór odpowiedniego headless CMS może zdecydować o sukcesie lub porażce Twojej strategii zarządzania treścią. Porównajmy trzy rozwiązania open source, które wpływają na to, jak programiści budują aplikacje oparte na treści.