
Qwen 3.6 27B i 35B MTP w porównaniu ze standardowym modelem na karcie GPU 16GB
MTP vs. standardowe dekoding na karcie RTX 4080 — rzeczywiste benchmarki
Przetestowałem wydajność dekodowania spekulatywnego (Predykcja Wielu Tokenów, MTP) w modelach Qwen 3.6 27B i 35B na karcie RTX 4080 z 16 GB pamięci VRAM.
Aby uzyskać szerszy obraz prędkości tokenów i kompromisów związanych z pamięcią VRAM dla większej liczby modeli na tym samym sprzęcie, zobacz Benchmarki LLM na 16 GB VRAM z llama.cpp.
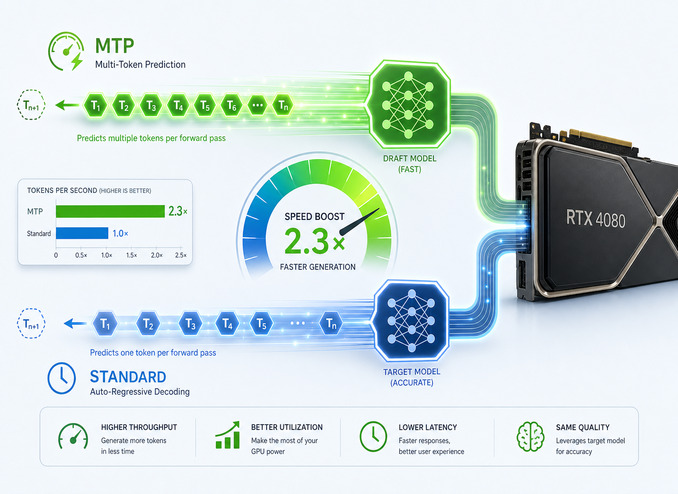
Czym jest MTP (Multi-Token Prediction)
Predykcja Wielu Tokenów (Multi-Token Prediction) to forma dekodowania spekulatywnego wbudowana bezpośrednio w pewne punkty kontrolne modeli. Zamiast przewidywać jeden token w każdym przejściu w przód, model posiada dodatkowe „głowy MTP", które proponują kilka przyszłych tokenów w pojedynczym kroku, a następnie weryfikują je równolegle. Jeśli zgadnięcia zostaną zaakceptowane, efektywna przepustowość rośnie bez zmiany jakości wyjścia.
Rodzina Qwen 3.6 oferuje zarówno pliki standardowe GGUF, jak i warianty z włączonym MTP. W llama.cpp MTP jest aktywowywane przez:
--spec-type draft-mtp --spec-draft-n-max 3
--spec-draft-n-max to kluczowy parametr strojenia. Ustala on, ile tokenów spekulatywnych głowa MTP proponuje na każdym etapie. Wyższe wartości dają potencjalny wzrost prędkości, ale kosztują dodatkową pamięć VRAM na bufory robocze (draft buffers), co jest realnym ograniczeniem na kartach 16 GB.
Co i jak testowałem
Przetestowałem, jak dwa modele Qwen 3.6 zachowują się z włączonym MTP w porównaniu ze standardowym dekodowaniem na GPU z 16 GB pamięci VRAM (RTX 4080).
Aby zmieścić wagi modelu i pamięć podręczną KV (KV cache) w pamięci VRAM, użyłem silnie skwantyzowanych wariantów:
Qwen3.6-27B-UD-IQ3_XXSiQwen3.6-27B-UD-IQ3_XXS-MTPQwen3.6-35B-A3B-UD-IQ3_SiQwen3.6-35B-A3B-UD-IQ3_S-MTP
W każdym uruchomieniu śledzono dwa budżety kontekstu:
- Śr. Ctx — rozmiar kontekstu, przy którym llama.cpp zajmuje około 14,8 GB VRAM, zostawiając inne aplikacje (Xorg, GNOME Shell, Cursor) komfortowy bufor ok. 500 MB.
- Maks. Ctx — największy kontekst, jaki llama.cpp mógł przydzielić, biorąc pod uwagę, że te same aplikacje desktopowe zajmują już około 500 MB VRAM.
Kluczowym powodem trzymania średniego kontekstu w praktycznym zakresie jest to, że Hermes Agent — który używam jako głównego asystenta AI połączonego z llama.cpp na tej maszynie — wymaga domyślnie co najmniej 64 K kontekstu i odrzuci modele z mniejszym oknem przy starcie. Modele poniżej tego progu nie są w stanie utrzymać wystarczającej pamięci roboczej dla wieloetapowych workflow z wywoływaniem narzędzi. Dla llama.cpp oznacza to przekazywanie parametru --ctx-size 65536 lub większego. Każda konfiguracja MTP, która znacząco zmniejsza średni użyteczny kontekst poniżej 64 K, jest więc niewłaściwa do codziennych obciążeń Hermes, stąd liczby Śr. Ctx w poniższych tabelach mają największe znaczenie dla podjęcia decyzji.
Przetestowano oba poziomy kwantyzacji pamięci podręcznej KV: q8 (wyższa jakość, więcej VRAM) i q5 (mniejsza ilość VRAM, dłuższy kontekst). Należy pamiętać, że przejście z q8 na q5 KV cache może spowodować odczuwalny spadek jakości — w moich testach degradacja była na tyle istotna, że q5 okazał się niewystarczający do moich zastosowań. Prędkości i liczby kontekstu dla q5 są zawarte dla kompletności, ale przed ostatecznym wyborze tej opcji należy przetestować jakość odpowiedzi na własnych zadaniach.
Qwen 3.6 27B MTP vs Standardowe
KV Cache q8
| MTP maks 1 | MTP maks 2 | MTP maks 3 | MTP maks 4 | Standardowe (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prędkość promptu | 148 tok/s | 151 tok/s | 148 tok/s | 147 tok/s | 200 tok/s |
| Prędkość generowania | 65 tok/s | 75 tok/s | 73 tok/s | 75 tok/s | 45 tok/s |
| Śr. Ctx | 40 K | 40 K | 40 K | 30 K | 80 K |
| Maks. Ctx | 60 K | 60 K | 60 K | 50 K | 100 K |
Z pamięcią podręczną KV q8, MTP z --spec-draft-n-max 2 oferuje około 67 % szybsze generowanie (75 vs 45 tok/s) kosztem połowienia średniego okna kontekstu z 80 K do 40 K. Prędkość przetwarzania promptu spada z 200 do ok. 150 tok/s, ponieważ MTP wymaga transferów z urządzenia do hosta (device-to-host) podczas fazy prefill.
KV Cache q5
| MTP maks 1 | MTP maks 2 | MTP maks 3 | MTP maks 4 | Standardowe (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prędkość promptu | 145 tok/s | 144 tok/s | 141 tok/s | 139 tok/s | 191 tok/s |
| Prędkość generowania | 57 tok/s | 62 tok/s | 67 tok/s | 66 tok/s | 41 tok/s |
| Śr. Ctx | 70 K | 60 K | 60 K | 50 K | 130 K |
| Maks. Ctx | 100 K | 100 K | 90 K | 80 K | 160 K |
Przełączenie na pamięć podręczną KV q5 odzyskuje znaczący kontekst: --spec-draft-n-max 1 daje 70 K średniego kontekstu przy 57 tok/s — to o 39 % szybsze generowanie w porównaniu ze standardowym dekodowaniem, przy jednoczesnym utrzymaniu okna kontekstu na użytecznym poziomie. Przy --spec-draft-n-max 3 kontekst spada do 60 K, ale generowanie osiąga 67 tok/s (+63 %).
Podsumowanie dla Qwen 3.6 27B
MTP jest naprawdę przydatne dla gęstego modelu 27B. Optymalnym punktem na 16 GB VRAM jest:
- KV q8 +
--spec-draft-n-max 2— najlepsza surowa prędkość (75 tok/s), kontekst spada do 40–60 K - KV q5 +
--spec-draft-n-max 1— najlepszy balans prędkości i kontekstu (57 tok/s, 70 K średniego kontekstu)
Qwen 3.6 35B MTP vs Standardowe
Model 35B to architektura Mixture-of-Experts (MoE) (35B-A3B oznacza 35 miliardów parametrów całkowitych, około 3 miliardy aktywnych na token). Modele MoE zazwyczaj korzystają bardziej z MTP, ponieważ rzadkie routowanie (sparse routing) utrzymuje głowę MTP obliczeniowo taniej w stosunku do pełnego przejścia w przód.
KV Cache q8
| MTP maks 1 | MTP maks 2 | MTP maks 3 | MTP maks 4 | Standardowe (IQ3_S) | |
|---|---|---|---|---|---|
| Prędkość promptu | 277 tok/s | 277 tok/s | 265 tok/s | 275 tok/s | 368 tok/s |
| Prędkość generowania | 186 tok/s | 189 tok/s | 180 tok/s | 171 tok/s | 146 tok/s |
| Śr. Ctx | 15 K | 10 K | — | — | 80 K |
| Maks. Ctx | 80 K | 70 K | 60 K | 50 K | 150 K |
Architektura MoE zapewnia imponującą surową prędkość generowania z MTP (+27 % przy maks 1, +29 % przy maks 2 w porównaniu ze standardowym 146 tok/s). Jednak problemem praktycznym jest średni kontekst. Z pamięcią podręczną KV q8, nawet --spec-draft-n-max 1 daje tylko 15 K średniego kontekstu — to ledwo wystarczające dla umiarkowanych zadań. Wyższe głębokości draft nie mają w ogóle wykonalnego średniego kontekstu na karcie 16 GB.
To jest kluczowe pytanie o koszt VRAM dla MTP na sprzęcie konsumenckim: dodatkowe bufory draft bezpośrednio zjadają pozostały budżet VRAM, a model 35B-A3B z pamięcią podręczną KV q8 pozostawia bardzo mało zapasu.
KV Cache q5
| MTP maks 1 | MTP maks 2 | MTP maks 3 | MTP maks 4 | Standardowe (IQ3_S) | |
|---|---|---|---|---|---|
| Prędkość promptu | 264 tok/s | 266 tok/s | 270 tok/s | 264 tok/s | 343 tok/s |
| Prędkość generowania | 151 tok/s | 147 tok/s | 137 tok/s | 131 tok/s | 122 tok/s |
| Śr. Ctx | 10 K | — | — | — | 120 K |
| Maks. Ctx | 120 K | 110 K | 110 K | 80 K | 200 K |
Pamięć podręczna KV q5 tylko nieznacznie poprawia sytuację z średnim kontekstem. --spec-draft-n-max 1 daje 10 K średniego kontekstu przy 151 tok/s. Standardowe dekodowanie z q5 daje 122 tok/s przy 120 K średniego kontekstu.
Podsumowanie dla Qwen 3.6 35B
Na GPU 16 GB model MoE 35B z MTP napotyka twardą barierę: średni użyteczny kontekst zapada się do 10–15 K tokenów, co czyni go niepraktycznym dla rzeczywistych obciążeń. Standardowe dekodowanie z 122–146 tok/s i kontekstem 80–120 K jest znacznie bardziej użyteczne.
Jeśli masz 24 GB+ VRAM, kombinacja 35B + MTP staje się znacznie bardziej atrakcyjna — problem okna kontekstu znika, a zachowujesz korzyść prędkości.
Jak wybrać prawidłową wartość --spec-draft-n-max
Pytanie o to, ile tokenów spekulatywnych proponować na każdym kroku (--spec-draft-n-max), nie ma jednej prawidłowej odpowiedzi — zależy od zarówno architektury modelu, jak i dostępnej pamięci VRAM:
- Dla 27B gęstego na 16 GB:
--spec-draft-n-max 2z KV q8 jest najszybsze,--spec-draft-n-max 1z KV q5 jest najbardziej przyjazne dla kontekstu. - Dla 35B MoE na 16 GB:
--spec-draft-n-max 1to jedyna opcja, która utrzymuje jakikolwiek użyteczny kontekst, i to tylko minimalnie. - Wyższe wartości (
3,4) zwiększają presję na VRAM bez proporcjonalnych zysków prędkości — przy maks 4 wydajesz mniej więcej tyle samo dodatkowej pamięci VRAM co przy maks 2, ale prędkość generowania nie nadąża.
Jak włączyć MTP w llama.cpp
Upewnij się, że używasz pliku GGUF z włączonym MTP (nazwa pliku zawiera MTP). Jeśli jesteś początkujący z flagami llama.cpp, Szybki start z llama.cpp z CLI i Serwerem pokrywa wszystkie podstawy. Następnie uruchom llama-server lub llama-cli z:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 40000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Dla pamięci podręcznej KV q5, zamień q8_0 na q5_1 lub q5_0 i zwiększ --ctx-size:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 80000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 1
MTP jest aktywowywane automatycznie, gdy llama.cpp wykryje głowy MTP w pliku GGUF i ustawiona zostanie flaga --spec-type draft-mtp.
Zatem standardowy plik Qwen3.6-27B-UD-IQ3_XXS.gguf nie zadziała w trybie MTP, będziesz potrzebować pliku Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf.
Ale plik Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf może działać zarówno w trybie dekodowania spekulatywnego, jak i autoregresyjnym.
Wnioski
Na GPU 16 GB (RTX 4080), z tymi kwantyzacjami, MTP w llama.cpp to wyraźna korzyść dla Qwen 3.6 27B i netto ujemna wartość dla Qwen 3.6 35B w praktycznym użyciu:
Qwen 3.6 27B (IQ3_XXS) — MTP jest warte tego:
- KV q8 + MTP maks 2 → ~67 % szybsze generowanie, kontekst 40–60 K (vs 80–100 K bez MTP)
- KV q5 + MTP maks 1 → ~39 % szybsze generowanie, kontekst 70–100 K (vs 130–160 K bez MTP)
- Dobry balans prędkości i wydajności VRAM przy
--spec-draft-n-max 2
Qwen 3.6 35B (IQ3_S) — MTP nie jest praktyczne na 16 GB:
- Prędkość generowania jest o 27–29 % wyższa, ale średni kontekst zapada się do 10–15 K przy q8 i 10 K przy q5
- Standardowe dekodowanie z 122–146 tok/s i kontekstem 80–120 K jest bardziej użyteczne dla rzeczywistych zadań
- Sytuacja znacząco poprawia się na VRAM 24 GB+
Na papierze pamięć podręczna KV q5 jest oczywistą odpowiedzią na maksymalizację okna kontekstu przy zachowaniu zysków prędkości MTP — ale w praktyce spadek jakości przy przejściu z q8 na q5 może być znaczący. Przetestuj q5 na własnych zadaniach przed jego wdrożeniem; dla moich obciążeń degradacja była nie do przyjęcia, a q8 z bardziej zaciśniętym budżetem kontekstu pozostaje lepszym kompromisem.
Dla szerszego obrazu opcji serwowania LLM i kompromisów infrastrukturalnych, zobacz filar Hosting LLM w 2026 oraz Wydajność LLM w 2026. Gdzie ta klasa 27B plasuje się na spektrum rozmiaru i kosztu w 2026 roku, oraz dlaczego aktualne buildy Qwen3.8-27B Q4 wymagają karty 24 GB, podczas gdy powyższe pomiary pozostają na 16 GB, jest w Efektywna granica otwartych modeli w 2026. Jeśli stroisz parametry samplera Qwen 3.6 w połączeniu z MTP, Referencja parametrów inferencji agentycznych LLM dla Qwen 3.6 i Gemma 4 jest przydatnym uzupełnieniem.
