
Open WebUI: 자체 호스팅 LLM 인터페이스
로컬 LLM용 셀프호스트드 ChatGPT 대안
Open WebUI는 대형 언어 모델(LLM)과 상호작용하기 위한 강력하고 확장 가능하며 기능적인 셀프 호스팅 웹 인터페이스입니다.
이 제품은 Ollama 및 OpenAI 호환 API를 지원하여, 완전한 프라이버시, 오프라인 기능, 그리고 엔터프라이즈 수준의 기능을 갖춘 친숙한 ChatGPT 경험을 사용자의 인프라로 가져옵니다. 로컬 및 클라우드 LLM 백엔드(즉, Ollama, vLLM, Docker Model Runner, LocalAI 및 클라우드 제공업체)에 대한 더 광범위한 비교는 LLM 호스팅: 로컬, 셀프 호스팅 및 클라우드 인프라 비교를 참조하세요.
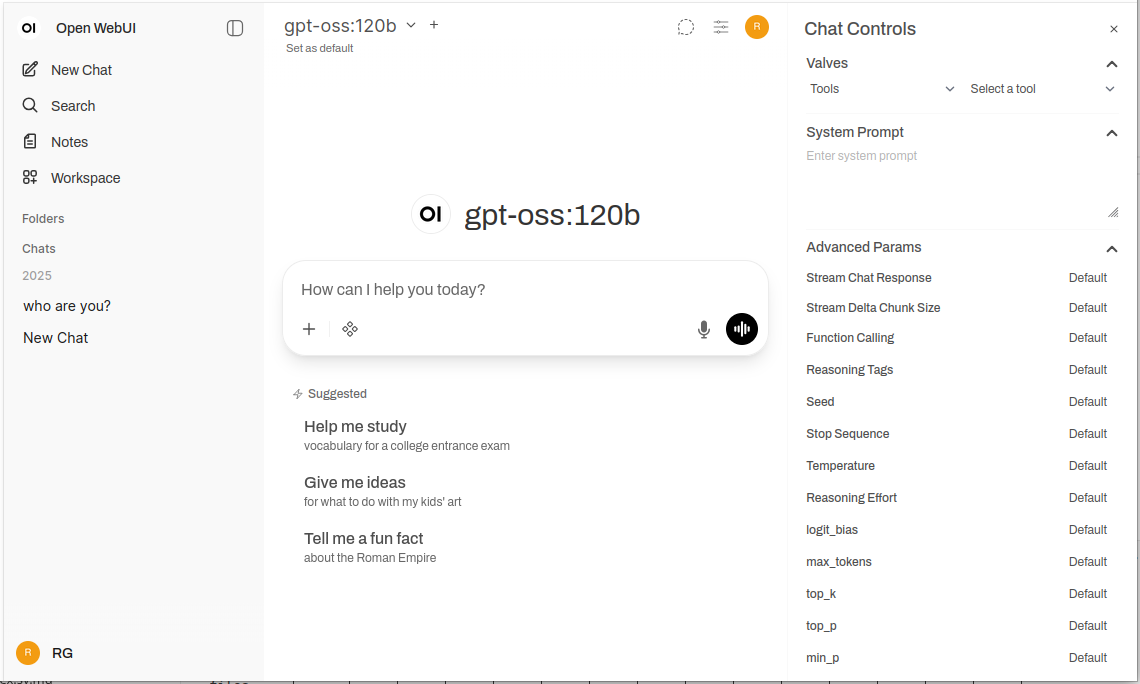
Open WebUI란 무엇인가?
Open WebUI는 대형 언어 모델과 상호작용하기 위한 현대적인 채팅 인터페이스를 제공하는 오픈소스 셀프 호스팅 웹 애플리케이션입니다. 클라우드 기반 AI 서비스와 달리, Open WebUI는 완전히 사용자의 인프라에서 실행되어 데이터, 대화, 모델 선택에 대한 완전한 제어 권한을 부여합니다.
Open WebUI는 주로 Ollama와 함께 사용되며(때로는 “Ollama WebUI"라고 비공식적으로도 불림), 실제로는 백엔드 무관(backend-agnostic) 플랫폼입니다. 로컬 모델 실행을 위해 Ollama의 API에 연결할 수 있지만, vLLM, LocalAI, LM Studio, Text Generation WebUI, 심지어 클라우드 제공업체와 같은 모든 OpenAI 호환 엔드포인트도 지원합니다. 이 유연성 덕분에 Open WebUI는 여러 백엔드를 지원하는 종합 솔루션이며, 문서 채팅을 위한 RAG(검색 증강 생성), 다중 사용자 인증, 음성 기능, 그리고 광범위한 사용자 지정 옵션을 지원합니다. 노트북, 홈 서버, 또는 Kubernetes 클러스터에서 모델을 실행하든, Open WebUI는用户的需求를 충족하기 위해 확장됩니다.
왜 Open WebUI를 선택해야 하는가?
프라이버시 우선: 모든 데이터가 사용자의 인프라에 유지됩니다. 명시적으로 외부 API를 설정하지 않는 한, 대화, 문서, 프롬프트가 네트워크를 나가지 않습니다.
오프라인 지원: 에어갭(외부 네트워크 차단) 환경, 제한된 네트워크, 또는 인터넷 접근이 불안정하거나 금지된 상황에 완벽합니다. Ollama 또는 vLLM을 통해 로컬에서 실행되는 모델과 결합하면 클라우드 서비스에 대한 완전한 독립성을 달성할 수 있습니다.
풍부한 기능: 셀프 호스팅임에도 불구하고, 문서 업로드 및 RAG, 시맨틱 검색을 통한 대화 기록, 프롬프트 템플릿 및 공유, 모델 관리, 음성 입력/출력, 모바일 반응형 디자인, 다크/라이트 테마 등으로 상업적 제품과 대등한 경쟁력을 갖추고 있습니다.
다중 사용자 지원: 역할 기반 접근 제어(관리자, 사용자, 보류), 사용자 관리 대시보드, 대화 격리, 팀 간 공유 프롬프트 및 모델을 갖춘 내장 인증 시스템을 제공합니다.
빠른 설치 가이드
Open WebUI를 가장 빨리 시작하는 방법은 Docker를 사용하는 것입니다. 이 섹션에서는 가장 일반적인 배포 시나리오를 다룹니다.
기본 설치 (기존 Ollama 연결)
이미 시스템에서 Ollama가 실행 중이라면, 다음 명령어를 사용하세요:
docker run -d \
  -p 3000:8080 \
  -v open-webui:/app/backend/data \
  --name open-webui \
  --restart always \
  ghcr.io/open-webui/open-webui:main
이 명령어는 Open WebUI를 포트 3000에서 실행하고, Docker 볼륨에 데이터를 영구적으로 저장합니다. http://localhost:3000에서 접근할 수 있습니다.
번들 설치 (Open WebUI + Ollama)
Ollama가 포함된 완전한 올인원 세트를 원한다면:
docker run -d \
  -p 3000:8080 \
  --gpus all \
  -v ollama:/root/.ollama \
  -v open-webui:/app/backend/data \
  --name open-webui \
  --restart always \
  ghcr.io/open-webui/open-webui:ollama
--gpus all 플래그는 더 빠른 추론을 위해 GPU 접근을 활성화합니다. CPU만 사용하는 경우 이 플래그를 생략하세요.
Docker Compose 설정
프로덕션 배포를 위해 Docker Compose를 사용하면 유지보수성이 더 좋습니다:
version: '3.8'

services:
  ollama:
    image: ollama/ollama:latest
    ports:
      - "11434:11434"
    volumes:
      - ollama:/root/.ollama
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    ports:
      - "3000:8080"
    environment:
      - OLLAMA_BASE_URL=http://ollama:11434
    volumes:
      - open-webui:/app/backend/data
    depends_on:
      - ollama
    restart: always

volumes:
  ollama:
  open-webui:
docker-compose up -d 명령어로 배포합니다.
Kubernetes 배포
엔터프라이즈 배포를 위해 Open WebUI는 Helm 차트를 제공합니다:
helm repo add open-webui https://helm.openwebui.com/
helm repo update
helm install open-webui open-webui/open-webui \
  --set ollama.enabled=true \
  --set ingress.enabled=true \
  --set ingress.host=chat.yourdomain.com
이로써 영구 저장소, 헬스 체크, 선택적 잉레스(ingress) 구성을 갖춘 프로덕션 준비 완료 배포가 생성됩니다.
핵심 기능 심층 분석
RAG 및 문서 채팅
Open WebUI의 RAG 구현은 문서를 업로드하고 모델이 대화 중 이를 참조하도록 허용합니다. 시스템은 자동으로 문서를 청킹(chunking)하고, 임베딩을 생성하며, 벡터 데이터베이스에 저장하고, 질문을 할 때 관련 컨텍스트를 검색합니다.
지원 형식: 내장 파서를 통해 PDF, DOCX, TXT, Markdown, CSV 및 더 많은 형식.
사용법: 채팅 창에서 ‘+’ 버튼을 클릭하고 ‘파일 업로드’를 선택한 후 문서를 선택하고 질문을 시작하세요. 모델은 응답에서 관련 구절과 페이지 번호를 인용합니다.
구성: 문서 유형에 따라 최적의 성능을 위해 관리자 설정에서 청크 크기, 중복, 임베딩 모델, 검색 매개변수를 조정할 수 있습니다.
다중 사용자 인증 및 관리
Open WebUI에는 팀 및 조직 사용을 위한 완전한 인증 시스템이 포함되어 있습니다:
- 로컬 인증: 보안 비밀번호 해싱을 가진 사용자명/비밀번호
- OAuth/OIDC 통합: 기존 ID 제공업체(Google, GitHub, Keycloak 등) 연결
- LDAP/Active Directory: 엔터프라이즈 디렉터리 통합
- 역할 기반 접근: 관리자(완전 제어), 사용자(표준 접근), 보류(승인 필요)
관리자는 사용자를 관리하고, 사용량을 모니터링하며, 사용자/그룹별 모델 접근을 구성하고, 대화 보존 정책을 설정할 수 있습니다.
음성 입력 및 출력
내장된 음성 상호작용 지원은 Open WebUI를 접근하고 사용하기 쉽게 만듭니다:
- 음성 인식(STT): Web Speech API 또는 설정된 외부 STT 서비스 사용
- 음성 합성(TTS): 여러 TTS 엔진 지원(브라우저 기반, Coqui TTS, ElevenLabs 등)
- 언어 지원: TTS/STT 설정에 따라 다국어 지원
프롬프트 엔지니어링 도구
Open WebUI는 프롬프트 관리를 위한 강력한 도구를 제공합니다:
- 프롬프트 라이브러리: 자주 사용하는 프롬프트를 템플릿으로 저장
- 변수와 플레이스홀더: 동적 콘텐츠를 가진 재사용 가능 프롬프트 생성
- 프롬프트 공유: 효과적인 프롬프트를 팀과 공유
- 프롬프트 버전 관리: 시간에 따른 변경 및 개선 사항 추적
모델 관리
UI를 통해 쉬운 모델 전환 및 관리:
- 모델 카탈로그: Ollama 라이브러리에서 모델을 직접 검색 및 불러오기
- 사용자 정의 모델: 사용자 정의 GGUF 모델 업로드 및 구성
- 모델 매개변수: 대화별로 temperature, top-p, 컨텍스트 길이 및 기타 샘플링 매개변수 조정
- 모델 메타데이터: 모델 세부 정보, 크기, 양자화, 기능 표시
구성 및 사용자 지정
환경 변수
환경 변수를 통한 주요 구성 옵션:
# Backend URL (Ollama 또는 기타 OpenAI 호환 API)
OLLAMA_BASE_URL=http://localhost:11434

# 인증 활성화
WEBUI_AUTH=true

# 기본 사용자 역할 (user, admin, pending)
DEFAULT_USER_ROLE=pending

# 사용자 가입 활성화
ENABLE_SIGNUP=true

# 관리자 이메일 (관리자 계정 자동 생성)
WEBUI_ADMIN_EMAIL=admin@example.com

# 데이터베이스 (기본 SQLite, 프로덕션용 PostgreSQL)
DATABASE_URL=postgresql://user:pass@host:5432/openwebui

# RAG 활성화
ENABLE_RAG=true

# RAG용 임베딩 모델
RAG_EMBEDDING_MODEL=sentence-transformers/all-MiniLM-L6-v2
대안 백엔드 연결
Open WebUI는 모든 OpenAI 호환 API와 작동합니다. 설정 → 연결(Connections)에서 기본 URL을 구성하세요:
- vLLM:
http://localhost:8000/v1 - LocalAI:
http://localhost:8080 - LM Studio:
http://localhost:1234/v1 - Text Generation WebUI:
http://localhost:5000/v1 - OpenAI:
https://api.openai.com/v1(API 키 필요) - Azure OpenAI: 사용자 정의 엔드포인트 URL
리버스 프록시 구성
프로덕션 배포 시, Open WebUI를 리버스 프록시 뒤에 실행하세요:
Nginx 예시:
server {
    listen 443 ssl http2;
    server_name chat.yourdomain.com;

    ssl_certificate /path/to/cert.pem;
    ssl_certificate_key /path/to/key.pem;

    location / {
        proxy_pass http://localhost:3000;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        # WebSocket 지원
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
    }
}
Traefik 예시 (Docker 레이블):
labels:
  - "traefik.enable=true"
  - "traefik.http.routers.openwebui.rule=Host(`chat.yourdomain.com`)"
  - "traefik.http.routers.openwebui.entrypoints=websecure"
  - "traefik.http.routers.openwebui.tls.certresolver=letsencrypt"
  - "traefik.http.services.openwebui.loadbalancer.server.port=8080"
성능 최적화
데이터베이스 튜닝
다중 사용자 배포 시, SQLite에서 PostgreSQL로 전환하세요:
# 의존성 설치
pip install psycopg2-binary

# 데이터베이스 URL 구성
DATABASE_URL=postgresql://openwebui:password@postgres:5432/openwebui
PostgreSQL은 동시 사용자를 더 잘 처리하고 대화 검색 및 RAG 작업에 향상된 쿼리 성능을 제공합니다.
임베딩 모델 선택
RAG 성능은 임베딩 모델 선택에 크게 좌우됩니다:
- 고속/자원 제약:
all-MiniLM-L6-v2(384 차원, 약 80MB) - 균형형:
all-mpnet-base-v2(768 차원, 약 420MB) - 최고 품질:
bge-large-en-v1.5(1024 차원, 약 1.3GB)
설정 → RAG → 임베딩 모델에서 구성합니다.
캐싱 전략
반복적인 API 호출을 줄이기 위해 대화 캐싱을 활성화하세요:
- 모델 캐싱: Ollama는 메모리에 로드된 모델을 자동으로 캐싱합니다
- 응답 캐싱: Open WebUI는 동일한 프롬프트를 캐싱할 수 있습니다(구성 가능)
- 임베딩 캐싱: 이전에 처리된 문서에 대한 임베딩 재사용
보안 모범 사례
프로덕션에서 Open WebUI를 배포할 때 다음 보안 가이드라인을 따르세요:
- 인증 활성화: 공개 네트워크에서 인증 없이 Open WebUI를 실행하지 마세요
- HTTPS 사용: 항상 TLS/SSL이 있는 리버스 프록시 뒤에 배포하세요
- 정기 업데이트: 보안 패치를 위해 Open WebUI 및 Ollama를 최신 상태로 유지하세요
- 접근 제한: 방화벽 규칙을 사용하여 신뢰할 수 있는 네트워크로의 접근을 제한하세요
- API 키 보안: 외부 API에 연결할 경우 환경 변수를 사용하고 절대 키를 하드코딩하지 마세요
- 감사 로그: 의심스러운 활동 감시를 위해 접근 로그를 활성화하고 모니터링하세요
- 데이터 백업:
/app/backend/data볼륨을 정기적으로 백업하세요 - 데이터베이스 암호화: 프로덕션에서 PostgreSQL의 저장 중 암호화를 활성화하세요
- レート 제한: 남용을 방지하기 위해 레이트 제한을 구성하세요
- 콘텐츠 필터링: 조직에 적합한 콘텐츠 정책을 구현하세요
사용 사례 및 실세계 응용
개인 지식 어시스턴트
Open WebUI를 로컬 모델 및 RAG와 결합하여 비공개 지식 베이스를 만들어 보세요. 노트, 연구 논문, 프로젝트 문서, 개인 문서를 업로드하십시오. 클라우드 서비스로 데이터를 전송하지 않고 대화형으로 질의할 수 있으며—프라이버시를 중시하는 연구자, 학생, 지식 노동자에게 완벽합니다.
개발 팀 협업
개발 팀을 위해 기술 문서, API 명세, 코드베이스 지식에 대한 공유 접근 권한이 있는 Open WebUI를 배포하세요. RAG 기능은 개발자가 수천 페이지의 문서에 걸쳐 관련 정보를 빠르게 찾을 수 있게 해주며, 대화 기록은 아키텍처 결정과 기술적 논의를 추적하는 데 도움이 됩니다.
엔터프라이즈 내부 챗봇
조직은 SSO 통합을 갖춘 방화벽 뒤에 Open WebUI를 배포하여, 내부 위키, 정책, 절차에 접근할 수 있는 AI 어시스턴트를 직원들에게 제공할 수 있습니다. 역할 기반 접근은 민감한 정보가 적절하게 세그먼트링되도록 보장하며, 관리자 제어는 거버넌스와 준수를 유지합니다.
교육 및 훈련
교육 기관은 프라이버시 우려 없이 학생과 교직원에게 AI 지원을 제공하기 위해 Open WebUI를 사용합니다. 강의 자료, 교과서, 강의 노트를 업로드하여 컨텍스트 기반 Q&A를 진행하세요. 다중 사용자 시스템은 사용량을 추적하는 동안 학생 데이터의 프라이버시를 유지합니다.
의료 및 법률 응용
데이터 프라이버시가 중요한 규제 산업에서, Open WebUI는 HIPAA 또는 GDPR 준수를 유지하면서 AI 보조 워크플로스를 가능하게 합니다. 의료 전문가는 약물 데이터베이스와 치료 프로토콜을 질의할 수 있고, 법률 팀은 판례와 계약을 검색할 수 있으며—all data가 통제된 인프라를 벗어나지 않습니다.
에어갭 및 오프라인 환경
정부 기관, 연구 시설, 보안 작전 센터는 에어갭 네트워크에서 Open WebUI를 사용합니다. 완전한 오프라인 기능은 인터넷 연결이 없어도 AI 지원이 가능하도록 보장하여, 기밀 환경이나 원격 위치에 필수적입니다.
일반적인 문제 해결
연결 문제
문제: Open WebUI가 Ollama에 연결할 수 없음
해결: Ollama가 실행 중인지 확인하세요 (curl http://localhost:11434), OLLAMA_BASE_URL 환경 변수를 확인하고, 방화벽 규칙이 연결을 허용하는지 확인하세요. Docker 배포의 경우, localhost 대신 서비스 이름(http://ollama:11434)을 사용하세요.
문제: UI에 모델이 표시되지 않음
해결: 모델이 설치되었는지 확인하세요 (ollama list), Open WebUI 설정에서 모델 목록을 새로 고침하고, 브라우저 콘솔에서 API 오류를 확인하세요.
RAG 및 문서 업로드 문제
문제: 문서 업로드 실패
해결: 설정에서 파일 크기 제한을 확인하고, 지원되는 파일 형식을 확인하며, 데이터 볼륨에 충분한 디스크 공간이 있는지 확인하고, 컨테이너 로그에서 파싱 오류를 검토하세요.
문제: RAG 응답이 업로드된 문서를 참조하지 않음
해결: 임베딩 모델이 다운로드되고 실행 중인지 확인하고, 청크 크기 설정을 확인하세요(더 작은 청크를 시도하여 더 나은 그레인도를 위해), RAG 설정에서 검색된 청크 수를 증가시키고, 쿼리가 문서 내용과 관련 있는지 확인하세요.
성능 문제
문제: 느린 응답 시간
해결: 가능하면 GPU 가속을 활성화하고, 모델 크기를 줄이거나 양자화된 버전을 사용하고, 동시 요청을 위해 OLLAMA_NUM_PARALLEL을 증가시키며, Docker 컨테이너에 더 많은 RAM을 할당하세요.
문제: 메모리 부족 오류
해결: 더 작은 모델을 사용하세요 (13B 파라미터 대신 7B), 모델 매개변수에서 컨텍스트 길이를 줄이고, 동시 사용자를 제한하거나, 시스템에 더 많은 RAM/스왑 공간을 추가하세요.
인증 및 접근
문제: 로그인하거나 관리자 계정을 생성할 수 없음
해결: WEBUI_AUTH=true를 설정하고, 관리자를 자동 생성하기 위해 WEBUI_ADMIN_EMAIL을 구성하며, 브라우저 쿠키와 캐시를 지우고, 데이터베이스 오류를 확인하기 위해 컨테이너 로그를 확인하세요.
문제: 사용자가 가입할 수 없음
해결: ENABLE_SIGNUP=true를 확인하고, DEFAULT_USER_ROLE 설정을 확인하세요 (자동 승인을 위해 user 또는 수동 승인을 위해 pending 사용), 그리고 데이터베이스가 쓰기 가능한지 확인하세요.
Open WebUI 대안
Open WebUI가 강력한 Ollama 통합을 갖춘 셀프 호스팅 인터페이스 제공에서 우수함을 발휘하지만, 동일한 문제 공간에 대해 다른 접근법을 제공하는 몇 가지 대안이 있습니다. 귀하의 선택은 다중 제공업체 유연성, 전문 문서 처리, 극단적인 단순함, 또는 엔터프라이즈 기능이 필요한지에 따라 달라집니다.
LibreChat은 가장 제공업체 무관한 솔루션으로 nổi bật하며, 단일 인터페이스에서 OpenAI, Anthropic, Azure OpenAI, Google Vertex AI, AWS Bedrock, Ollama에 대한 네이티브 지원을 제공합니다. 플러그인 아키텍처와 멀티 테넌시, 상세한 접근 제어, 사용량 쿼터와 같은 엔터프라이즈 기능은 여러 AI 제공업체를 지원하거나 정교한 감사 추적이 필요한 조직에 이상적입니다. 트레이드오프는 복잡성입니다—LibreChat은 Open WebUI보다 더 많은 설정 노력과 더 무거운 자원이 필요하며, 그 Ollama 지원은 클라우드 제공업체에 비해 보조적으로 느껴집니다.如果您的 팀이 글쓰기에 Claude, 코딩에 GPT-4, 프라이버시 민감 작업에 로컬 모델을 사용한다면, LibreChat의 통합 인터페이스가 빛을 발합니다.
문서가 많은 워크플로우의 경우, AnythingLLM은 기본 RAG를 넘어선 지식 베이스 우선 접근 방식을 채택합니다. 그 워크스페이스 모델은 문서와 대격을 격리된 환경으로 조직화하며, 고급 검색 기능에는 하이브리드 검색, 재랭킹, 인용 추적이 포함됩니다. 데이터 커넥터는 GitHub, Confluence, Google Drive에서 콘텐츠를 가져오며, 에이전트 기능은 다단계 추론과 워크플로우 자동화를 활성화합니다. 이것은 여러 고객 지식 베이스를 관리하는 컨설팅 회사나 광범위한 문서로 작업하는 지원 팀에 ممتاز합니다. 채팅 인터페이스는 Open WebUI만큼 세련되지 않지만, 대규모 문서 컬렉션을 질의하는 것이 주요 필요라면, 정교한 검색 기능은 더 가파른 학습 곡선을 정당화합니다.
LobeChat은 기능 깊이보다 사용자 경험을 우선시하여,渐进式 웹 애플리케이션 기능과 함께 세련되고 모바일 친화적인 인터페이스를 제공합니다. 그 현대적인 디자인, 부드러운 애니메이션, 강력한 음성/멀티모달 지원은 디자인 및 비기술 사용자에게 인기 있으며, 그들은 모든 장치에서 원활하게 작동하는 AI 어시스턴트를 원합니다. PWA 구현은 Open WebUI가 따라가지 못하는 앱과 같은 모바일 경험을 제공합니다. 그러나, 엔터프라이즈 기능은 제한적이며, 플러그인 생태계는 작고, RAG 기능은 Open WebUI와 AnythingLLM 모두에 밀립니다.
데스크톱 애플리케이션을 선호하는 사용자를 위해, Jan.ai는 제로 설정 로컬 모델 관리와 함께 크로스 플랫폼 설치 프로그램(Windows, macOS, Linux)을 제공합니다. Ollama를 별도로 설치하거나 Docker와 다툴 필요가 없습니다—Jan은 모든 것을 시스템 트레이 지원과 원클릭 모델 다운로드를 가진 네이티브 앱으로 번들링합니다. 이 “그냥 작동한다"는 철학은 Jan을 명령줄 도구에 익숙하지 않은 가족 구성원이나 동료에게 로컬 LLM을 제공하는 데 이상적으로 만듭니다. 트레이드오프는 다중 사용자 지원 부재, 적은 고급 기능, 그리고 원격 접근 기능 없음입니다.
Chatbox는 가볍고 미니멀한 크로스 플랫폼 클라이언트로서 OpenAI, Claude, Gemini, 로컬 API를 지원하며 매우 낮은 자원 오버헤드를 가지고 있습니다. 이는 다양한 API 제공업체를 빠르게 테스트해야 하는 개발자나 자원 제약 하드웨어를 가진 사용자에게 완벽합니다. 설정 마찰은 최소이지만, 일부 기능은 구독 게이트이며, 완전한 오픈소스는 아니고, RAG 지원은 제한적입니다.
Ollama 특화 최소 UI는 “충분한” 인터페이스를 원하는 사용자를 위한 여러 가지가 존재합니다: Hollama은 여러 기계에 걸친 여러 Ollama 서버를 관리하고, Ollama UI는 매우 쉬운 배포로 기본 채팅 및 PDF 업로드를 제공하며, Oterm은 SSH 세션과 tmux 워크플로우를 위한 놀라울 정도로 강력한 터미널 기반 인터페이스를 제공합니다. 이러한 것은 단순함과 속도를 위해 기능을 희생합니다.
벤더 지원을 필요로 하는 조직을 위해, 상용 옵션인 TypingMind Team, BionicGPT, Dust.tt는 전문적 백킹, 준수 인증, SLA와 함께 셀프 호스팅을 제공합니다. 그들은 오픈소스 자유를 보장의 가동 시간, 보안 감사, 책임감으로 교환합니다—조직이 엔터프라이즈 수준의 지원 계약이 필요할 때 적합합니다.
적절하게 선택하기: Open WebUI는 대부분의 셀프 호스팅 Ollama 배포에 달콤한 지점을 적중시켜, 포괄적인 기능과 관리 가능한 복잡성을 균형 있게합니다. 제공업체 유연성이 최우선일 때 LibreChat을, 정교한 문서 워크플로우에 AnythingLLM을, 모바일 우선 또는 디자인 중시 사용자에게 LobeChat을, 비기술 데스크톱 사용자에게 Jan을, 벤더 지원이 필요할 때 상용 옵션을 선택하세요. 로컬 모델을 실행하는 대부분의 기술 사용자에게는, Open WebUI의 활발한 개발, 강력한 커뮤니티, 뛰어난 RAG 구현이 대부분의 셀프 호스팅 LLM 배포에 대한 권장되는 시작점으로 만듭니다.
미래 개발 및 로드맵
Open WebUI는 로드맵에 몇 가지 흥미로운 기능을 가진 빠른 개발을 계속합니다:
개선회 멀티모달 지원: LLaVA 및 Bakllava와 같은 모델에 대한 이미지, 비전 모델, 멀티모달 대화의 더 나은 처리.
강화된 에이전트 기능: AutoGPT 패턴과 유사한 함수 호출, 도구 사용, 다단계 추론 워크플로우.
더 나은 모바일 앱: 개선된 모바일 경험을 위해 현재 PWA 구현을 넘어가는 네이티브 iOS 및 Android 애플리케이션.
고급 RAG 기능: 더 나은 컨텍스트를 위한 그래프 기반 RAG, 시맨틱 청킹, 멀티 쿼리 검색, 부모 문서 검색.
협업 기능: 공유 대화, 팀 워크스페이스, 프롬프트 및 문서에 대한 실시간 협업.
엔터프라이즈 통합: 규제 산업에 대한 더 깊은 SSO 지원, SCIM 프로비저닝, 고급 감사 로그, 준수 보고.
이 프로젝트는 후방 호환성과 시맨틱 버전 관리를 유지하여 업그레이드를 간단하게 만듭니다. 활발한 GitHub 저장소는 일일 커밋과 반응적인 이슈 관리를 보입니다.
결론
Open WebUI는 단순한 Ollama 프런트엔드에서 셀프 호스팅 AI 상호작용을 위한 종합적인 플랫폼으로 진화했습니다. 프라이버시, 기능, 배포 용이성의 조합은 기능을 희생하지 않고 로컬 LLM을 활용하기를 원하는 개인, 팀, 조직에게 ممتاز한 선택으로 만듭니다.
모델을 테스트하는 개발자, 내부 AI 도구를 구축하는 조직, 또는 프라이버시를 우선시하는 개인이든, Open WebUI는 강력하고 셀프 호스팅된 AI 워크플로우의 기초를 제공합니다. 활발한 커뮤니티, 정기적인 업데이트, 확장 가능한 아키텍처는 그것이 셀프 호스팅 AI 공간에서 선도적인 선택으로 남을 것임을 보장합니다.
기본 Docker 설치로 시작하고, 몇 가지 문서를 업로드하여 RAG를 실험해 보고, Ollama 라이브러리에서 다른 모델을 시도하고, 필요에 따라 고급 기능을 점차 탐색해 보세요. 학습 곡선은 완만하지만, 상한은 높습니다—Open WebUI는 개인 노트북에서 엔터프라이즈 Kubernetes 클러스터까지 확장됩니다.
대안을 비교하는 사람들을 위해, Open WebUI의 Ollama 우선 설계, 균형 잡힌 기능 세트, 활발한 개발은 대부분의 셀프 호스팅 LLM 배포에 대한 권장되는 시작점으로 만듭니다. 특정 요구가 발생하면 더 전문적인 솔루션으로 항상 마이그레이션할 수 있지만, 많은 사용자가 실험부터 프로덕션까지의 전체 여정에 걸쳐 Open WebUI의 기능이 충분하다고 느낍니다. Open WebUI의 일반 백엔드(Ollama, vLLM 등)가 Docker Model Runner, LocalAI 및 클라우드 제공업체와 어떻게 맞물리는지 확인하려면, 우리의 LLM 호스팅: 로컬, 셀프 호스팅 및 클라우드 인프라 비교 가이드를 확인해 보세요.
유용한 링크
Open WebUI 환경을 설정할 때, 로컬 LLM 호스팅 및 배포 옵션의 더 넓은 생태계를 이해하는 것이 이롭습니다. 종합적인 가이드 로컬 LLM 호스팅: 2025년 완전 가이드 - Ollama, vLLM, LocalAI, Jan, LM Studio 및 기타는 Ollama, vLLM, LocalAI 등을 포함하여 12개 이상의 로컬 LLM 도구를 비교하며, API 성숙도, 도구 호출 기능, 성능 벤치마크에 기반하여 Open WebUI 배포에 최적의 백엔드를 선택하는 데 도움을 줍니다.
처리량과 지연 시간이 중요한 고-performance 프로덕션 배포의 경우, vLLM 퀵스타트: 고-performance LLM 서빙 가이드를 탐색해 보세요. 이 가이드는 Docker를 사용한 vLLM 설정, OpenAI API 호환성, PagedAttention 최적화를 다룹니다. Open WebUI가 여러 동시 사용자를 서빙하고 Ollama의 성능이 병목이 될 때 특히 가치 있습니다.
채팅, 임베딩, 이미지 생성, 오디오를 단일 OpenAI 호환 서버를 통해 처리하는 멀티모달 백엔드를 선호한다면, LocalAI 퀵스타트는 Docker 설치, 모델 갤러리 설정, API 구성을 다룹니다 — 모두 http://localhost:8080 기본 URL을 통해 Open WebUI에 연결 가능합니다.
백엔드가 동시 요청을 처리하는 방식을 이해하는 것은 용량 계획에 필수적입니다. 기사 Ollama는 병렬 요청을 처리하는 방법는 Ollama의 요청 큐잉, GPU 메모리 관리, 동시 실행 모델을 설명하며, Open WebUI 배포의 다중 사용자 시나리오에 적합한 제한과 기대치를 구성하는 데 도움이 됩니다.
Open WebUI의 에이전트 검색 루프가 연구 워크로드에 대해 “충분히 깊은지” 평가하고 있다면, 셀프 호스팅 딥 리서치 시스템: 12개 도구 비교은 Open WebUI의 모델 주도 접근 방식을 GPT Researcher, Onyx, DeerFlow와 같은 전용 리서치 엔진과 나란히 놓습니다.
외부 리소스
공식 문서 및 커뮤니티 지원을 위해 다음 외부 리소스를 참조하세요:
