
오픈클로의 부와 몰락 — 붕괴의 타임라인과 실제 원인
OpenClaw는 빠르게 부상했다가 더 빠르게 사라졌다.
OpenClaw는 제품으로서 실패한 것이 아닙니다. 연료를 잃어버린 것입니다.
OpenClaw는 빠르게 부상했다가 더 빠르게 사라졌다.
OpenClaw는 제품으로서 실패한 것이 아닙니다. 연료를 잃어버린 것입니다.
재시작 없이 LLM을 서빙하고 교체합니다.
llama.cpp는 오랫동안 치명적인 한계점을 가지고 있었습니다. 바로 프로세스당 하나의 모델만 서빙할 수 있었고, 모델 전환을 하려면 프로세스를 재시작해야 했기 때문입니다.
PKM 도구, 방법론 및 셀프 호스트 위키 비교
개인 지식 관리(PKM)는 Obsidian, Logseq, DokuWiki, Zettelkasten, PARA 등을 아우르는 광범위한 영역입니다. 올바른 선택은 로컬 기반의 노트 그래프, 자체 호스팅 위키, 또는 아웃라이너 기반의 워크플로우 중 무엇을 원하는지에 따라 달라집니다.
심각한 워크로드를 위한 프로파일 우선 Hermes 설정
공식적으로 Hermes Agent로 문서화된 Hermes AI 어시스턴트는 단순한 채팅 래퍼(wrapper)로 포지셔닝되지 않습니다.
가져둘 가치 있는 스킬과 건너뛸 스킬
OpenClaw에는 두 가지 확장이 있으며, 이들은 쉽게 혼동될 수 있습니다.
플러그인은 런타임을 확장합니다. 스킬(기술)은 에이전트의 행동을 확장합니다.
플러그인이 우선입니다. 스킬 명칭은 간략하게 표기합니다.
이 기사는 OpenClaw 플러그인에 대해 다룹니다. OpenClaw 플러그인은 채널, 모델 제공자, 도구, 음성, 메모리, 미디어, 웹 검색 및 기타 런타임 표면을 추가하는 네이티브 게이트웨이 패키지입니다.
실제 OpenClaw 시스템이 어떻게 구성되어 있는지
데모에서는 OpenClaw가 단순해 보입니다. 하지만 프로덕션 환경에서는 하나의 시스템으로 진화합니다.

로컬 LLM을 활용한 자체 호스팅 AI 검색
Vane은 “인용과 함께 하는 AI 검색” 분야에서 가장 실용적인 선택지 중 하나입니다. 이는 라이브 웹 검색과 로컬 또는 클라우드 LLM을 결합하는 자체 호스팅형 답변 엔진으로, 전체 스택을 사용자의 통제 아래에 두는 것이 특징입니다.
개발자를 위한 Hermes Agent 설치 및 빠른 시작
Hermes Agent는 로컬 머신 또는 저비용 VPS에서 실행되는 셀프 호스팅, 모델 비의존형 AI 어시스턴트로, 터미널 및 메시징 인터페이스를 통해 작동하며 반복적인 작업을 재사용 가능한 스킬로 전환함으로써 시간이 지남에 따라 성능이 향상됩니다.
TGI 를 설치하고 빠르게 배포하며 더 빠르게 디버깅하세요.
Text Generation Inference(TGI) 는 매우 특유의 에너지를 지니고 있습니다. 추론 분야에서 가장 새로운 기술은 아니지만, 이미 프로덕션 환경에서 발생하는 문제를 잘 이해하고 있습니다.
SGLang 로 오픈 모델을 빠르게 제공하세요.
SGLang 은 단일 GPU 에서 분산 클러스터에 이르기까지 저지연 및 고휘도 추론을 제공하도록 설계된 대규모 언어 모델 및 멀티모달 모델용 고성능 서비스 프레임워크입니다.
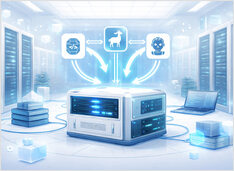
클라이언트 변경 없이 로컬 LLM을 핫스왑하세요.
가까운 미래에는 vLLM, llama.cpp 등 다양한 스택을 여러 포트에서 동시에 관리하게 될 것입니다. 하지만 다운스트림의 모든 시스템은 여전히 단일 /v1 기반 URL을 요구합니다. 그렇지 않으면 포트, 프로필, 일회용 스크립트를 계속 치환하는 수고스러운 일이 반복됩니다. llama-swap은 이러한 스택 앞단에 배치되는 /v1 프록시입니다.
대부분의 로컬 AI 설정은 모델과 런타임으로 시작합니다.
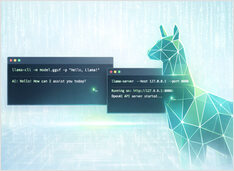
CLI 및 서버에서 GGUF 모델 실행하기
llama.cpp는 GGUF 모델용 C/C++ 추론 엔진입니다: 대화형 챗에는 llama-cli, 스크립트된 프롬프트에는 llama-completion, OpenAI 호환 HTTP API에는 llama-server를 제공합니다.
OpenClaw AI 어시스턴트 가이드
대부분의 로컬 AI 환경은 동일한 방식으로 시작합니다. 모델, 런타임, 그리고 채팅 인터페이스가 그것입니다.
헤드리스 CMS 비교 - 기능, 성능 및 사용 사례
올바른 헤드리스 CMS를 선택하는 것은 콘텐츠 관리 전략을 성공적으로 만들거나 망하게 만들 수 있습니다.
개발자가 콘텐츠 중심 애플리케이션을 구축하는 방식에 영향을 미치는 세 가지 오픈소스 솔루션을 비교해 보겠습니다.