Strata로 Qwen3.8-Flash-Next 로컬 실행: 64GB 빠른 시작
125B MoE, 콘슈머 GPU 한 대로 구동 — 그리고 3비트가 무너지는 지점
Qwen3.8-Flash-Next(QFN)는 총 125B개의 파라미터를 보유하고 있으며, 토큰당 6B개의 활성 파라미터를 사용합니다. 또한 네이티브 256K 컨텍스트 윈도우를 갖추고 있습니다. 기본적으로 추론(thinking) 기능이 활성화되어 있으며, 로컬 모델 클래스에서 가장 높은 에이전틱 코딩 벤치마크 점수를 기록하고 있습니다.
이 글에서는 64GB RAM 데스크톱과 RTX 5090을 사용하여 Strata로 QFN의 3-bit 양자화를 실행하는 방법을 설명하고, 왜 sub-Q4 양자화가 에이전틱 워크로드에서 신뢰할 수 있는 도구 호출(tool calls)을 생성하지 못하는지 문서화합니다.
아래에는 설치 명령, 각 양자화가 고정하는 RAM 양, 그리고 64GB 데스크톱에서 발생한 도구 호출 실패 사례가 정리되어 있습니다. 속도 및 실패 수치들은 해당 머신(RTX 5090, 64GB RAM, Ubuntu 26.04)에서의 실행 결과와 Strata 트래커, 그리고 0.2.11 릴리스 노트에 보고된 데이터를 혼합하여 작성되었습니다.
명령어와 엔진 기본 설정은 Strata 0.2.11, 엔진 패키지 0.1.57, 저장소 별 수 40,836개인 시점인 2026년 6월 11일에 확인되었습니다. 이 런타임이 Ollama, llama.cpp, vLLM 옆에서 어떤 위치를 차지하는지는 LLM 호스팅 가이드에서 다룹니다.
Strata란 무엇인가
이 퀵스타트에서 사용하는 엔진은 MIT 라이선스로 배포되는 Niko1221/Strata입니다. SGLang에 대한 계층적 KV 캐싱을 다룬 OSDI 2026 논문은 동일한 이름을 사용하는 별개의 프로젝트입니다. Strata는 llama.cpp와 ggml 위에 구축되었으며, 저장소에는 docs/paper/Strata-Paper.pdf 위치에 서술 문서가 포함되어 있습니다. 이 엔진은 Qwen3.8-Flash-Next를 소비자용 GPU 하나, 시스템 RAM, SSD를 가로질러 실행합니다. 동일한 엔진은 Qwen3.6-35B와 DeepSeek V4.1-Flash도 제공합니다.
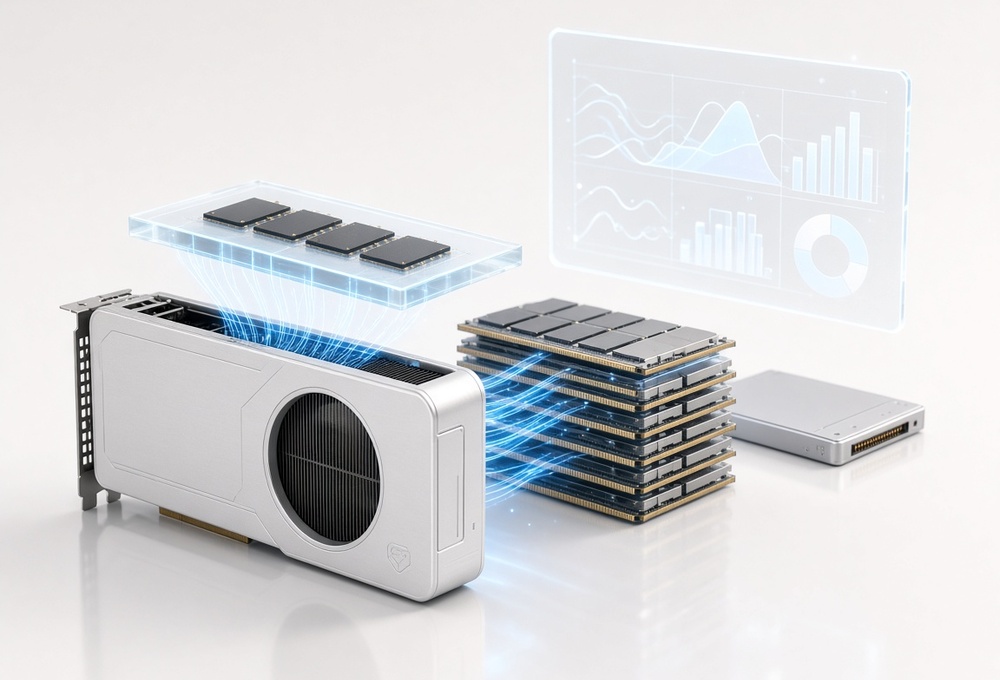
Qwen 3.8 Flash Next는 48개 레이어에 걸쳐 24,576개의 라우팅 전문가(experts)를 보유하고 있으며, 각 토큰당 10개의 전문가(총 6B개의 활성 파라미터)를 활성화합니다. Strata는 모델이 한 곳에서만 실행될 수 있도록 요구하는 대신, 모델을 세 가지 메모리 계층으로 나눕니다.
| 계층 | 보유 내용 | 역할 |
|---|---|---|
| GPU (VRAM) | Attention, DeltaNet 믹서, 게이트드-레지듀얼 가중치, 라우터, 공유 전문가, 출력 헤드, MTP 초안 레이어, KV 캐시(64K부터: 가장 자주 읽히는 부분; 나머지는 RAM에서 스트리밍), 그리고 전문가 캐시 | 토큰당 실행되는 모든 것; 전문가 캐시는 남은 VRAM에 가장 많이 사용되는 전문가들을 채우고, 실행 중인 대화에 맞춰 적응함 |
| RAM | 24,576개의 모든 전문가, 고정(pinned) 상태 | GPU에 없는 전문가를 CPU가 현장에서 계산을 수행하며, 이는 GPU가 캐시된 전문가를 처리하는 것과 동시에 이루어짐 (AVX-512/AVX2 커널, i-quants는 ggml 사용) |
| SSD | 28.8GB의 n-그램 임베딩 테이블 | OS 페이지 캐시를 통해 토큰당 몇 행을 읽음 |
51B의 n-그램 파라미터 블록은 바이그램과 트라이그램으로 인덱싱되는 2,000만 개 항목의 조회 테이블 역할을 합니다. 행렬 곱셈이 아닌 조회(lookup)이기 때문에 최소한의 런타임 비용으로 SSD에 상주할 수 있습니다.
VRAM 용량이 스케일링 축을 결정합니다. VRAM 1GB마다 약 700개의 전문가를 수용할 수 있으며, GPU에 캐시되는 각 전문가는 CPU 계산을 줄입니다. 더 많은 VRAM을 가진 느린 카드는 더 적은 VRAM을 가진 빠른 카드보다 높은 성능을 발휘합니다.
RAM 용량은 경계(hard constraint)입니다. 동시에 CPU와 GPU 계산을 위해 모든 전문가가 고정(pinned)되어야 하기 때문입니다. Strata는 디스크로 나일지 메모리 매핑(lazy memory mapping)을 지원하지 않습니다. QFN의 경우 다운로드 크기와 RAM 사용량이 거의 동일합니다.
디코딩 속도의 구성
디코딩 레이트는 세 가지 메커니즘에 의해 제공됩니다.
-
멀티-토큰 예측(MTP). 체크포인트에는 멀티스텝 드래프트를 위해 학습된 MTP 레이어 하나가 포함되어 있습니다. Strata는 최대 3개의 토큰을 드래프트하여 48개 레이어 전체에서 단일 패스로 검증합니다. 추측 디코딩 가이드에 설명된 드래프트-검증 사이클입니다. 이 프로젝트는 패스당 평균 2.4
3.2개의 토큰 수락을 측정하고, 동일한 출력에 대해 이를 1.61.8배의 디코딩 속도 향상으로 보고합니다. -
프롬프트 조회. 모델이 맥락을 반복할 때(코드 편집이나 인용과 같은 경우), 서버는 이전 맥락 사본에서 최대 5개의 드래프트 토큰을 가져옵니다. 프로젝트는 코드 편집이 6~11% 빨라지고, 다른 텍스트는 변화가 없다고 보고합니다.
-
차unked prefill. 프롬프트는 최대 8,192개 토큰의 블록으로 전달되며, 현재 레이어의 어텐션이 실행되는 동안 다음 레이어의 전문가들이 PCIe를 통해 이동합니다. 프로젝트는 긴 문서 및 코드베이스 섭취(Ingestion) 속도를 초당 1,000개 토큰 이상으로 책정하며, 대화 상태가 상주(resident)되어 있어 후속 요청은 몇 초 이내에 시작됩니다.
서버는 데스크톱 앱 또는 터미널 형태의 로컬 채팅 UI를 제공하며, 로컬호스트(localhost)에서 OpenAI 및 Anthropic 호환 엔드포인트를 제공합니다. Claude Code, Codex CLI, OpenCode, Hermes Agent, OpenClaw는 strata connect를 통해 연결됩니다. 프로젝트에서 나열하는 하드웨어: NVIDIA RTX 20/30/40/50 시리즈(CUDA 13 엔진 패키지는 드라이버 580 이상 필요), HIP 기반 AMD Radeon, Linux 기반 Intel Arc, Apple Silicon, AMD Strix Halo. 데스크톱 앱용 릴리스 0.2.11은 Strata-0.2.11-linux-x86_64.AppImage이며, 아래 터미널 경로가 이 퀵스타트가 안내하는 방식입니다.
로컬 대안 대비 QFN 벤치마크
Alibaba의 모델 카드는 Flash-Next를 Qwen3.8-27B, DeepSeek-V4-Flash(0731 체크포인트), Claude Opus 4.6(Max)와 비교합니다.
| 구분 | QFN | Qwen3.8-27B | DeepSeek-V4-Flash | Claude Opus 4.6 (Max) |
|---|---|---|---|---|
| 총/활성 파라미터 | 125B / 6B | 27B / 27B | 284B / 13B | – |
| N-그램 임베딩 파라미터 | 51B | – | – | – |
| DeepSWE 1.1 (에이전틱 코딩) | 58.7 | 42.2 | 54.4 | – |
| SWE-bench Pro | 62.5 | 61.7 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | 73.8 | – | 77.5 |
| Toolathlon Verified (도구 사용) | 73.5 | 67.1 | 70.3 | – |
| JobBench (에이전틱 오피스) | 55.7 | 33.4 | 41.3 | 36.6 |
| CoWorkBench | 73.9 | 70.7 | 45.1 | 68.2 |
| GPQA Diamond | 91.7 | 89.2 | 90.8 | 91.3 |
| LiveCodeBench v6 | 91.9 | 90.3 | 90.6 | 88.8 |
해당 카드의 에이전틱 코딩 행은 온도 1.0, top_p 0.95, 256K 윈도우 설정으로 측정되었습니다. DeepSWE는 Claude Code와 mini-SWE-agent 하네스 중 더 높은 점수를 보고하며, 카드에는 Flash-Next의 높은 점수가 mini-SWE-agent에서 나왔다고 명시되어 있습니다. SWE-bench Pro는 수정된 태스크 세트에서 베이스라인을 재실행했으며, Claude Opus 4.6 셀은 벤더가 발표한 점수이고, 나머지 셀은 Claude Code의 점수입니다.
같은 카드에서 반대 방향인 두 행이 있습니다. NL2Repo-Bench는 Flash-Next가 48.1이고 DeepSeek-V4-Flash가 54.2입니다. GPT-4o가 평가한 HLE는 Claude Opus 4.6(Max)의 40.0에 비해 35.9입니다.
에이전트 워크를 위해 카드의 기본값은 preserve_thinking을 켜두어 추론 추적(reasoning trace)이 턴 간에 유지되고, reasoning_effort를 xhigh로 설정합니다. 다른 레벨은 medium과 low입니다. Qwen 4 패밀리 페이지에서는 Alibaba가 이 라인에 대해 확인한 내용, 여기에는 Qwen Community License 1.0이 포함된 가중치에 대한 내용이 추적됩니다. 위의 표는 오늘날 측정할 수 있는 부분입니다.
양자화 빌드 및 크기
ISTA-DASLab GSQ-RCO
ISTA-DASLab GSQ-RCO GGUF는 균일하지 않은 양자화(non-uniform quantization)를 사용합니다. GSQ는 텐서당 로우-비트 스칼라 양자화이고, RCO는 크기 예산 내에서 텐서당 타입을 할당합니다. 이 방법은 검색 가능한 가중치의 95%를 차지하는 라우팅 전문가에 압축의 대부분을 소모합니다. 각 빌드는 2개의 샤드로 구성됩니다. 두 번째는 약 4.5비트/가중치로 인코딩된 n-그램 테이블이며, 디스크에서 매핑할 수 있습니다.
| 빌드 | 평균 bpw | 상주 샤드 | N-그램 샤드 | 총합 | 비고 |
|---|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB | 속도 빌드: 조회 테이블 포맷 회피; 프롬프트 367 t/s, 디코드 93.8 t/s, 평균 지연 6.7초 (거의 동일한 크기의 IQ2_XS가 12.7초인 것과 비교) |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB | 동일 품질에서 가장 작음 |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB | 메모리 부족 환경용 추천; AIME25에서 기본 모델과 매칭, GPQA-Diamond에서 약 1.5점 포기 |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB | ISTA 권장: 하네스 내 모든 태스크에서 기본 모델에 매칭하거나 우세 (GPQA-Diamond 92.93 vs 91.92) |
해당 GPQA 수치는 ISTA의 하네스 결과이며, Alibaba 카드의 91.7이 아닙니다. Coder 변형은 레이어당 512개 라우팅 전문가 중 256개를 유지하며, 58.4GB, 유효 비트당 가중치 1.89입니다. 0.91GB BF16 비전 프로젝터는 멀티모달 추가 항목입니다. ISTA 라인은 IQ3_S에서 끝납니다; Q4 빌드가 없습니다.
Strata 0.2.11의 Unsloth 팩
2026년 4월 11일, Unsloth는 Qwen3.8-Flash-Next GGUF를 Dynamic v3.1로 재업로드했습니다. 0.2.11 릴리스 노트에 따르면, Strata는 앱, strata launch --family unsloth, 또는 이미 보유하고 있는 폴더로부터 그 중 7개를 다운로드, 준비, 실행할 수 있다고 합니다. 각 파일은 Unsloth 리비전 d9620119와 크기와 SHA-256으로 검증됩니다. 모든 세트의 마지막 파일은 28.8GB의 토큰당 테이블입니다. 테이블을 공유하는 세트는 파일을 공유합니다: UD-IQ1_M은 UD-IQ2_XS와, UD-IQ3_XXS는 UD-IQ4_XS-v31과.
| Strata 내 이름 | 다운로드 | 파일 수 |
|---|---|---|
| UD-IQ1_M | 68.0 GB | 3 |
| UD-Q2_0 | 70.6 GB | 3 |
| UD-IQ2_XS | 75.8 GB | 3 |
| UD-Q2_K_XL | 79.6 GB | 4 |
| UD-IQ3_XXS | 83.6 GB | 4 |
| UD-Q3_K_XL | 89.5 GB | 4 |
| UD-IQ4_XS-v31 | 93.7 GB | 4 |
UD-IQ4_XS-v31은 Strata가 이전에 제공했던 UD-IQ4_XS와 다른 파일입니다: 다른 텐서 타입, 3개가 아닌 4개의 파일. UD-Q4_K_XL, UD-Q5_K_XL, UD-Q6_K_XL, Q8_0은 2026년 9월 30일 파일에 머물러 있습니다. 4월 11일 UD-Q4_K_XL은 4개 파일 분할로 된 동일한 가중치이며, Strata는 이미 그 분할을 보유하고 있다면 수용합니다. UD-IQ1_S는 로드되지 않습니다 — 한 레이어가 두 개의 전문가 포맷을 혼합하기 때문 — 따라서 UD-IQ1_M이 1-bit 선택지입니다.
UD-IQ4_XS-v31은 33개 레이어에서 Q5_0 전문가 포맷을 사용합니다. 동일한 노트에는 Strata의 Q5_0 연산이 해당 텐서에 대해 정밀 결과에서 1.21.3% 편차를 보인다고 하며, llama.cpp 공식은 2.63.0% 편차를 보입니다. Mac에서 앱은 첫 시작 전에 전문가를 하나의 GPU 파일로 재작성하므로, 디스크 예산은 다운로드 용량에 그 파일 용량과 몇 기가바이트(UD-IQ1_M의 경우 약 115GB)를 더한 것입니다.
28.8GB 테이블이 매핑된 상태에서 유지되면, UD-IQ4_XS-v31의 나머지 부분은 KV 캐시 전 약 64.9GB입니다. 이는 Strata의 고정 규칙 하에서 64GB 머신을 이미 초과하는 상태입니다. UD-IQ1_M의 나머지 부분은 약 39.2GB입니다. 이 파일은 IQ3_S가 맞지 않는 곳에 맞을 수 있으며, 아래에서 3비트에서 측정된 도구 호출 동작과는 더 먼 1-bit 팩입니다.
퀵스타트: 설치, 실행, 최초 실행 설정
Linux 데스크톱에는 프로젝트가 나열한 RTX 20/30/40/50 시리즈 카드 또는 다른 GPU, 선택한 팩과 KV 캐시 여유 공간에 충분한 RAM, 그리고 다운로드를 위한 SSD 공간이 필요합니다. CUDA 13 엔진 패키지는 드라이버 580 이상을 요구합니다.
터미널 설치:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh && sh install.sh
strata launch
strata launch는 모델, 양자화, 컨텍스트, 저장 폴더, 접근 설정을 묻고, 카드를 위한 엔진을 다운로드하며, 서버를 시작하고, 속도, 메모리, 요청 데이터를 보여주는 모니터를 표시합니다. 기본 엔드포인트는 http://127.0.0.1:8080입니다.
76GB 다운로드 전에 어떤 것이 맞는지를 확인하거나, 프롬프트 없이 시작하려면:
strata launch --family qwen --model q2_0 --plan      # 드라이 러너: 무엇이 부족하고, 무엇이 맞는지
strata launch --family qwen --model q2_0 --yes --no-tui   # 백그라운드로 시작
strata launch --status
strata connect    # Claude Code / OpenCode / Hermes / OpenClaw 등용 설정 출력
strata launch --stop
해당 --family qwen --model q2_0 플래그는 Ubuntu 26.04에서 ISTA Q2_0 빌드를 위한 드라이 러너로 사용되었습니다. Unsloth 팩은 --family unsloth와 위 표의 이름을 사용합니다. strata connect는 도구별 프로바이더 블록을 출력합니다. 두 가지 API 형태 모두 OpenAI 호환 기본 URL(http://127.0.0.1:8080/v1)과 실행 시 출력된 모델 이름을 사용합니다. 커서(Cursor)를 포함하여 커스텀 OpenAI 호환 엔드포인트를 수용하는 모든 클라이언트는 그 쌍을 사용합니다.
최초 실행 시 확인해야 할 두 가지 설정
-
샘플링. 0.2.11에서
sampling블록이 없는 팩 구성은 모델 카드를 따릅니다. 추론 요청은 온도 1.0, top_p 0.95, top_k 20을 받습니다. 비추론 요청은 0.7, 0.8, 20과 presence_penalty 1.5를 받습니다. 우선순위 순서: 요청, 웹 UI의 채팅 설정, 구성 블록, 모델 카드. 온도 0은 요청 또는 블록에서 설정할 때만 적용되며, 해당 탐욕(greedy) 실행들은 이 체크포인트에서 반복 루프에 빠진 실행들이었습니다. 구버전 팩 구성에 여전히"sampling": {"temperature": 0}가 포함되어 있다면, 카드의 추론 프리셋으로 교체하세요. -
tool_call_recovery. 이 키는 모델 런 구성(strata-*.json)에 존재합니다. 0.2.8부터 기본적으로 켜져 있으며, 0.2.7 이하는 꺼져 있습니다. Strata 엔진 노트는 1,462개 에이전트 턴을 인용하며, 스위치가 켜진 상태에서 호출의 98.3%가 의도대로 읽히고, 꺼진 상태에서는 92.9%라고 보고합니다. 요청에 이름이 포함된 호출의 4가지 형태를 수용합니다:<parameter=NAME>태그,<tool_call>내부의 JSON,<tool_call>래퍼가 없는<function=NAME>블록, 그리고 하나의<tool_call>안의 두 번째 호출. 선언되지 않은 이름 또는 깨진 JSON은 텍스트로 남습니다. 0.2.7 이하에서는"tool_call_recovery": true로 설정하세요. 에이전트 워크를 위해 0.2.11의 기본값(켜짐)을 유지하세요.
서버를 로컬호스트에 유지하기
서버는 기본적으로 로컬호스트에 바인딩되며, 접근 설정은 strata launch의 일부입니다. 엔드포인트는 해당 머신에서 모델과 대화를 노출하며, 개방된 네트워크를 위해 설계되지 않았습니다. 다른 머신이 이를 필요로 할 때, 포트 앞에 인증된 리버스 프록시를 두세요.
ss -ltnp | grep :8080    # 리스너가 0.0.0.0이 아닌 127.0.0.1인지 확인
curl -s http://127.0.0.1:8080/v1/models   # 서버가 로컬호스트에서 응답
VRAM 13GB 이하 카드
STRATA_ROUTE_PRIOR=1.5는 라우터가 이미 카드에 있는 전문가를 선호하도록 지시합니다. RTX 3060 12GB에서 IQ3_XXS를 실행하는 Strata 노트는 prior가 꺼져 있는 상태에 비해 스토리 디코딩에서 +15%, 코드 디코딩에서 +37%의 성능 향상을 보고하며, 에이전트 태스크 통과 건수는 평균 4회 실행 중 4.5건으로, prior가 꺼진 7회 실행의 5.6건보다 적었습니다. 0.2.7 버전은 13GiB 이하의 이산 NVIDIA 카드에 대해 1.5를 스스로 켰습니다. 0.2.8 버전은 반복 발생과 약화된 긴 에이전트 세션 이후 2026년 10월 29일에 이를 다시 끄고, (이슈 #4402)를 언급했습니다. 변수가 설정되지 않은 0.2.11은 0.2.6처럼 라우팅합니다. 프로젝트는 prior를 12GB 카드의 채팅과 짧은 답변을 향하고, 긴 에이전트 실행에서는 벗어나도록 지시합니다.
테스트베드: 에이전트를 실행하는 64GB 데스크톱
측정된 머신 구성:
| 컴포넌트 | 스펙 |
|---|---|
| CPU | Intel Core Ultra 7 265 (20코어, DDR5-6400 듀얼 채널 ≈ 102 GB/s) |
| GPU | RTX 5090, 32 GB |
| RAM | 64 GB |
| OS | Ubuntu 26.04 |
| 동시 실행 | Hermes VM을 위한 KVM 호스트, Cursor IDE, 브라우저 |
ISTA IQ3_XXS를 사용할 경우 상주 샤드는 47GB입니다. 전문가가 고정되므로, 기타 용도로 약 9GB가 남습니다. 에이전트 스택이 포함된 Hermes 프로덕션 설정의 Hermes VM과 Cursor는 약 5GB를 남기며, 이는 긴 에이전트 세션을 위한 페이지 캐시나 KV 캐시에는 부족합니다.
ISTA IQ3_S는 일일 데스크톱으로 이 머신에 맞지 않습니다. 54.8GB의 상주 샤드와 28.8GB의 매핑된 n-그램 테이블은 64GB를 사용합니다. Cursor 실행 시 3GB가 비어 있고, Hermes VM은 갈 곳이 없습니다.
| 설정 | 상주 | 무료 RAM (모델 전용) | 무료 RAM (모델 + VM + Cursor) | 디코드 (측정) | 에이전틱 판정 |
|---|---|---|---|---|---|
| IQ3_XXS (3.00 bpw) | 47 GB | ~9 GB | ~5 GB | – | 도구 호출이 정기적으로 실패; 일일 드라이버 부적합 |
| IQ3_S (3.50 bpw) | 54.8 GB + 28.8 GB mmap | ~3 GB (Cursor 전용) | – | 100–130 tok/s | 여유 공간 전무; 사용 불가 |
IQ3_S는 초당 100~130 토큰으로 디코딩되었으며, Qwen 3.6 MTP 비교의 16GB GPU에서 MTP 3를 가진 llama.cpp 기반 27B 빌드와 동일한 속도 클래스입니다. RAM 예산에 맞는 팩(IQ3_XXS)은 도구 호출 포맷을 놓치는 것입니다. ISTA가 권장하는 팩(IQ3_S)은 데스크톱의 나머지 부분을 위한 공간을 남기지 않습니다.
IQ3_XXS에서 모델은 잘못된 도구 호출 인자를 출력하고, 스키마에 없는 도구 이름을 발명했으며, 짧은 추론 블록 후 같은 명령을 3~5번 재발행했습니다. 하네스는 각 누락(miss)을 재시도로 취급하므로, 세션은 같은 오류로 채워집니다. 이 하드웨어에서 IQ3_XXS는 에이전트 모델이 아닙니다.
커뮤니티 보고 사항
Strata에서의 Qwen3.8-Flash-Next 속도 보고, 이슈 스레드 및 0.2.11 노트에서:
| 구성 | 결과 |
|---|---|
| 2× RTX 4090 | 프롬프트 6,553 t/s, 싱글 스트림 디코드 271 t/s |
| RTX 5080 + 4060 Ti, 32 GB RAM | 디코드 피크 200+ tok/s |
| 12 GB VRAM + 32 GB RAM, 전문가 CPU 오프로딩 | ~65 tok/s; q8 KV, 199K 컨텍스트의 한 댓글: 프롬프트 1,740 t/s, 디코드 ~21.5 t/s |
| RTX 5070 12 GB + 64 GB RAM, IQ3_S | 디코드 85–100 tok/s |
| Pro 6000 + 2× 3090, 256 GB RAM, Unsloth 6-bit, 160K 컨텍스트 | llama-server에서 Strata로 전환 후 디코드 70–80 → 150 tok/s |
| RTX 2060 랩톱, 32 GB RAM + 6 GB VRAM | Q2_0 실행 가능 |
| RTX 3060 12 GB, UD-IQ1_M, 짧은 프롬프트 (0.2.11 노트) | 디코드 31–37 tok/s, 카드 내 전문가 18% |
로우-비트 Qwen3.8-Flash-Next의 에이전트 워크로드에서 세 가지 실패 모드가 서술되어 있습니다.
-
스키마 크기에 따라 변화하는 훼손된 도구 호출 출력. 이슈 #1431은 39개 함수 스키마(약 12K 토큰)와 6K 시스템 프롬프트를 가진 상태에서, Strata 0.1.40의 IQ3_XXS가 20회 이상의 제어된 재현 실행 중 약 30
50%에서 사용 가능한 턴을 생성했다고 보고합니다. 모델은 파서가 매핑할 수 없는 도구 호출 형태를 출력했습니다(텍스트는50% 밴드 위로 올리지 못했습니다.finish_reason: stop와 함께content에 기록됨) 또는 추론 블록을 닫고 호출이나 답변 없이 시퀀스 종료(end-of-sequence)를 출력했습니다. 동일한 가중치에서 llama.cpp는 8회 연속 실행 모두에서 도구 호출을 파싱했습니다. llama.cpp는 PEG 문법으로 출력을 제약하고, 훼손된 내용을tool_calls로 다시 올립니다. 텍스트를 나중에 복구하는 래퍼는 토큰이 이미 선택된 후에 실행되므로, 사용 가능한 턴 비율을 해당 30 -
설정 오류와 결정론적이지 않은 전문가 경로. 이슈 #2685는 RTX 5070, IQ3_S, 60GB RAM으로, Strata를 통해 도구 호출이 실패하는 것을 보고합니다: 잘못된 인자, 환각된 도구, 재시도 루프(샘플링 블록과
tool_call_recovery가 켜진 후에도). 동일한 양자화를llama serve를 통해 실행할 때, 동일한 하네스의 5회 실행 중 5회에서 성공했습니다. 보고자는 동일한 시드(preseed)가 프리필(prefill) 중 MMQ 전문가 경로에서 발산하며, 해당 경로를 비활성화하면 실행이 비트-일치(bit-identical)가 됨을 발견했습니다. Strata 0.1.44는 결정론 수정을 배포했습니다. 후속 보고들은 여전히 동일한 양자화에서 Strata가 llama.cpp를 매칭하지 못하고 있음을 보여줍니다. -
추론 블록 내부에 남은 도구 호출. 이슈 #804는 닫히지 않은
think블록 내부의 완전한 도구 호출이reasoning_content로 반환되고,content가 비어 있으며tool_calls가 없으며, 에이전트 루프가 멈추는 것을 보고합니다. 한 사용자는 Hermes를 IQ3_XXS, IQ2_XS, Coder 빌드로 사용하여 약 1,300개의 실제 에이전트 응답 중 약 100건마다 1건이 발생한다고 계산했습니다.
왜 Sub-Q4가 에이전틱 도구 호출을 깨뜨리는가
도구 호출은 와이어 포맷(wire format)과 일치해야 합니다. 3비트에서 이 125B 모델은 일부 턴에서 해당 포맷을 놓치고, 누락은 도구 스키마 컨텍스트가 커질수록 증가합니다. 더 큰 스키마는 호출을 포맷팅하는 워킹 메모리에 더 많은 것을 요구하며, 양자화 노이즈는 그 포맷팅에 떨어집니다. 채팅 턴은 이를 숨깁니다. 대부분이 도구 호출인 에이전트 턴은 그렇지 않습니다.
적은 파라미터가 활성일 때 동일한 압축은 더 큰 피해를 줍니다. OpenCode를 위한 로컬 LLM 비교에서 IQ3_XXS의 Dense 27B는 구조화 된 에이전트 태스크에서 약 5%의 오류율을 측정했습니다. 유사한 비트 폭의 로우-액티브 MoE 체크포인트는 더 심각하게 실패했습니다: 35B-A3B는 IQ3_S에서 64.2%, IQ4_XS에서 98.8%의 오류를, 122B-A10B는 IQ3_S에서 80%, IQ3_XXS에서 90%의 오류를 보였습니다. Qwen3.8-Flash-Next는 토큰당 6B의 파라미터를 활성화하므로, 3-bit 팩은 무거운 양자화에서의 작은 모델처럼 행동합니다. 해당 OpenCode 실행들은 35B-A3B와 122B-A10B에서 IQ3와 IQ4가 구조화 된 태스크를 놓치고 있음을 보여주며, Flash-Next의 Q5 실행은 포함되지 않았습니다. Strata의 UD-IQ4_XS-v31은 0.2.11부터 다운로드 가능하지만, 여기서 확인한 소스에는 에이전트 태스크 비교가 없으며, 64GB 박스에 맞지 않습니다.
동일한 GSQ-RCO 가중치는 llama.cpp와 Ollama에서 로드될 때 실패합니다. llama.cpp는 여전히 문법으로 출력을 제약하고 훼손된 스팬을 tool_calls로 다시 올릴 수 있으므로, 클라이언트는 깨진 문자열 대신 호출을 봅니다. 엔진 노트의 Strata JSON 모드는 스키마 프롬프팅과 생성 후 체크이며, 문법 제약 디코딩이 아닙니다: 잘못된 개체는 structured_output_failed와 함께 HTTP 502를 반환합니다. tool_call_recovery와 후속 릴리스는 위에 나열된 4가지 형태를 복구합니다. 이는 모델이 샘플링하는 분포를 변경하지 않으므로, 이슈 #1431의 래퍼가 출력율을 넘어설 수 없었습니다.
Strata는 CPU와 GPU를 동기화시키기 위해 RAM을 소모합니다. 64GB에서 데스크톱과 에이전트 VM의 공간을 남기는 가장 큰 ISTA 팩은 IQ3_XXS이며, 해당 팩은 여기서 측정된 출력 임계값보다 낮습니다. IQ3_S는 이미 MTP 3를 가진 27B 모델과 동일한 밴드로 디코딩하므로, 해당 팩의 한계는 RAM입니다. 나일지 맵을 가진 llama.cpp 실행은 더 적은 RAM을 커밋하지만, 이 모델에서 Strata를 두 개 중 더 빠른 것으로 만드는 디코딩 레이트를 포기하게 됩니다.
판정
Qwen 3.8 Flash Next는 에이전틱 벤치마크에서 Qwen3.8-27B보다 우수한 성능을 발휘합니다: DeepSWE 58.7 vs 42.2, JobBench 55.7 vs 33.4, Toolathlon 73.5 vs 67.1. 멀티스텝 워크는 뚜렷하게 더 유능합니다. 토큰당 컴퓨트는 125B 모델보다 작은 모델에 더 가깝습니다.
Q4 미만의 양자화는 에이전틱 워크를 위한 신뢰할 수 있는 도구 호출 출전을 제공하지 못하며, Strata와 llama.cpp 양쪽 모두에서 재시도 루프를 생성하는 실패율을 보입니다. Q4 성능은 아직 에이전트 벤치마크의 제어된 비교를 통해 입증되지 않았습니다. Q5 클래스 양자화는 신뢰할 수 있는 에이전틱 워크를 위한 입증된 하한선이며, Unsloth UD-Q5_K_XL은 존재하지만 공개된 벤치마크가 없습니다.
M5 Max와 128GB 통합 메모리를 가진 Mac Studio는 에이전트 스택을 위한 충분한 여유 공간과 함께 105GB MLX 빌드나 Q4 팩을 보유할 수 있습니다. QFN 아키텍처는 이 오프로딩 모델のために 설계되었습니다.
저는 현재 세팅에서 NVFP4 27B 모델을 계속 사용할 것입니다 — RTX 5090에서 17GB — MTP 3와 함께, 신뢰할 수 있는 도구 호출과 RAM 경쟁 없이 초당 100개 이상의 토큰을 달성하고 있습니다. Q4 클래스 양자화가 에이전트 태스크에서 벤치마크될 때, Strata의 출력 복구가 성숙할 때, 또는 하드웨어가 업그레이드될 때 QFN으로 돌아갈 것입니다.
참고 자료
- Niko1221/Strata — 이 글의 추론 엔진. SGLang의 OSDI 2026 계층적-KV 논문은 동일한 이름을 가진 별개의 프로젝트입니다.
- Strata 0.2.11 릴리스 노트 — Unsloth Dynamic v3.1 팩, Q5_0 연산, 그리고 위에서 인용한 짧은 프롬프트 속도.
- 엔진 노트 (
docs/DETAILS.md) — 샘플링 우선순위,tool_call_recovery, 라우트-프라이어 측정. - Qwen/Qwen3.8-Flash-Next — 아키텍처, 샘플링 프리셋, 벤치마크 표.
- ISTA-DASLab Qwen3.8-Flash-Next GSQ-RCO GGUF — 테스트베드의 Q2와 IQ3 빌드.
- 이슈 #1431, 이슈 #2685, 이슈 #804, 이슈 #4402 — 커뮤니티 및 소형 카드 섹션의 실패 보고.
유용한 링크
- 16GB VRAM GPU에서 Ollama를 위한 최상의 LLM 선택 — 카드가 한계인 경우의 Dense-model 대안.
- Ollama 치트시트 — 동일한 GGUF를 가져올 수 있는 다른 로컬 서버.
