Modell-Routing: Verwenden Sie nicht ein Modell für alles

Modell-Routing: Verwenden Sie nicht ein Modell für alles

Das richtige Modell für die richtige Aufgabe.

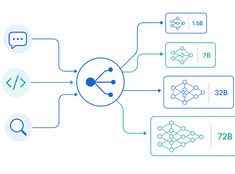
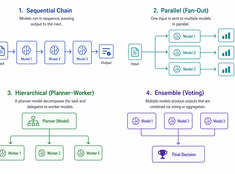
Das Ausführen eines Modells mit 70 Milliarden Parametern, um eine 200-Wörter-E-Mail zusammenzufassen, ist verschwenderisch. Das Ausführen eines 3-Milliarden-Parameter-Modells zur Überprüfung von Produktionscode ist fahrlässig. Die meisten Systeme liegen irgendwo dazwischen – und genau hier kommt das Modell-Routing ins Spiel.

LLM-Guardrails in der Praxis: Was wirklich funktioniert

LLM-Guardrails in der Praxis: Was wirklich funktioniert

Kontrollieren Sie das Risiko, nicht nur das Modell.

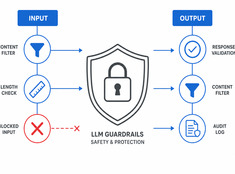
LLMs sind unvorhersehbar. Sie halluzinieren, lecken Daten, generieren schädliche Inhalte oder lehnen legitime Anfragen ab. Guardrails (Schutzmechanismen) begrenzen das Modellverhalten, ohne die Fähigkeiten einzuschränken.

Kostenoptimierung für LLM-Systeme: Wo das Geld tatsächlich hingeht

Kostenoptimierung für LLM-Systeme: Wo das Geld tatsächlich hingeht

Setze Token gezielt dort ein, wo es wirklich zählt.

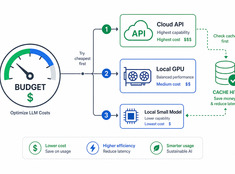
LLM-Kosten skalieren linear mit der Nutzung. Ein System, das 10.000 Anfragen pro Tag zu 0,01 USD pro Anfrage verarbeitet, kostet 100 USD täglich – 365 USD pro Jahr. Im Unternehmensumfeld belaufen sich diese Kosten auf über 10.000 USD.

Speichersysteme in KI-Assistenten

Speichersysteme in KI-Assistenten

Arbeits-, strukturiertes und Abrufgedächtnis für Assistenten.

Speicher wandelt Assistenten von reaktiv in persistent um, aber genau dort verrotten auch viele Systeme still vor sich hin. Umfragen zeigen, dass die Trennung in Kurzzeit- und Langzeitgedächtnis für modernes Agenten-Gedächtnis nicht mehr ausreicht; OpenAI und LangGraph-SDKs deuten auf einen simpleren Stack hin — Arbeitsgedächtnis, dauerhafter Zustand und Abruf (Retrieval).

Architektur von KI-Assistenten: LLM, Speicher, Werkzeuge, Routing, Observability

Architektur von KI-Assistenten: LLM, Speicher, Werkzeuge, Routing, Observability

Wie seriöse Assistenten tatsächlich entwickelt werden.

Ein produktionsreifes KI-Assistentensystem ist nicht einfach „ein LLM mit einem Prompt“. Es handelt sich um ein System, das Absichten entgegennimmt, den Zustand verwaltet, entscheidet, wann Daten abgerufen oder Aktionen ausgeführt werden sollen, und genügend Laufzeitdetails bereitstellt, um Fehler zu debuggen.

Retrieval vs. Repräsentation in Wissenssystemen

Retrieval vs. Repräsentation in Wissenssystemen

Die Suche ist keine Wissensstruktur

Die meisten modernen Wissenssysteme optimieren die Abrufprozesse (Retrieval), und das ist verständlich. Die Suche ist sichtbar, leicht zu demonstrieren und wirkt fast magisch, wenn sie funktioniert. Frage eingeben, Antwort erhalten.

PKM vs. RAG vs. Wiki vs. Memory-Systeme klar erklärt

PKM vs. RAG vs. Wiki vs. Memory-Systeme klar erklärt

Eine Landkarte moderner Wissenssysteme

PKM, RAG, Wikis, KI-Speichersysteme und nun auch praktische, KI-gestützte Workflows werden oft so diskutiert, als lösten sie dasselbe Problem. Tun sie nicht. Sie alle befassen sich mit Wissen, arbeiten aber auf unterschiedlichen Ebenen:

Second Brain erklärt – für Ingenieure und Wissensarbeiter

Second Brain erklärt – für Ingenieure und Wissensarbeiter

Notizen sind Speicher. Ein zweites Gehirn ist Berechnung.

Informationsüberflutung hat weniger mit der schieren Menge zu tun als vielmehr mit ungelösten Eingaben. Moderne Wissensarbeit hinterlässt eine Spur aus Tabs, Chat-Verläufen, Dokumenten, Hervorhebungen, Code-Fragmenten, Transkripten, Screenshots und halbfertigen Notizen.

Abonnieren

Neue Beiträge zu Systemen, Infrastruktur und KI-Engineering.