Cheatsheet

llama.swap Modellumschalter: Schnelleinstieg für OpenAI-kompatible lokale LLMs

llama.swap Modellumschalter: Schnelleinstieg für OpenAI-kompatible lokale LLMs

Lokale LLMs per Hot-Swap austauschen, ohne die Clients anzupassen.

Bald jonglierst du mit vLLM, llama.cpp und weiteren – jeder Stack auf seinem eigenen Port. Alles, was downstream liegt, erwartet weiterhin eine einzige /v1-Basis-URL; andernfalls musst du ständig Ports, Profile und Einmalskripte umstellen. llama-swap ist die /v1-Proxy-Schicht vor diesen Stacks.

LocalAI QuickStart: OpenAI-kompatible LLMs lokal ausführen

LocalAI QuickStart: OpenAI-kompatible LLMs lokal ausführen

Bereitstellen von OpenAI-kompatiblen APIs mit LocalAI in wenigen Minuten auf dem eigenen Server.

LocalAI ist ein selbstgehosteter, lokal-first Inferenzserver, der sich wie eine Drop-in OpenAI API verhält, um KI-Arbeitslasten auf Ihrer eigenen Hardware (Laptop, Workstation oder lokaler Server) auszuführen.

Schnellstart von llama.cpp mit CLI und Server

Schnellstart von llama.cpp mit CLI und Server

GGUF-Modelle mit der CLI und dem Server ausführen

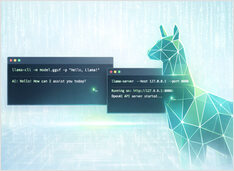
llama.cpp ist eine C/C++-Inferenz-Engine für GGUF-Modelle: llama-cli für interaktive Chats, llama-completion für skriptgesteuerte Prompts und llama-server für eine OpenAI-kompatible HTTP-API.