NVIDIA

Die effiziente Frontiere offener Modelle: Den Sweet Spot für 2026 finden

Die effiziente Frontiere offener Modelle: Den Sweet Spot für 2026 finden

Der ideale Bereich für offene LLMs im Jahr 2026: rund 30 Mrd. Parameter.

Im September 2026 liegt die effiziente Frontier der offenen Modelle zwischen 25 Milliarden und 34 Milliarden Parametern: nahezu Frontier-nahes Agenten-Work auf einer einzigen 24-GB-GPU, mit einem Bruchteil der Hardware von 70B-Klasse.
KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

Warum 128K Kontext auf 16 GB scheitert

Ein Modell kann einen 128K-Kontextfenster bewerben und trotzdem bei 40K Tokens auf einer 16-GB-GPU scheitern. Die architektonische Obergrenze hat nie versprochen, dass Modellgewichte, KV-Cache, Rechenspeicher und der Desktop-Compositor gleichzeitig auf Ihrer Grafikkarte Platz finden würden.

GPUs für KI im Jahr 2026: NVIDIA, AMD und Intel im Vergleich

GPUs für KI im Jahr 2026: NVIDIA, AMD und Intel im Vergleich

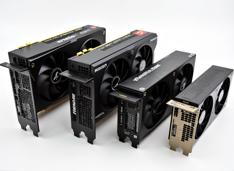
Vergleich von AI-GPUs dreier Anbieter

Die Landschaft der KI-Hardware hat sich 2026 erheblich verändert. NVIDIA, AMD und Intel konkurrieren alle um Entwickler, die GPUs benötigen, die in der Lage sind, lokale Large Language Models (LLMs) und KI-Inferenz-Arbeitslasten auszuführen.

Ollama in Docker Compose mit GPU und persistenter Model-Speicherung

Ollama in Docker Compose mit GPU und persistenter Model-Speicherung

Compose-first Ollama-Server mit GPU und Persistenz.

Ollama läuft hervorragend auf Bare-Metal-Systemen. Es wird noch interessanter, wenn man es wie einen Dienst behandelt: mit einem stabilen Endpunkt, festgelegten Versionen, persistentem Speicher und einer GPU, die entweder verfügbar ist oder eben nicht.

KI-Infrastruktur auf Consumer-Hardware

KI-Infrastruktur auf Consumer-Hardware

Bereitstellung von Enterprise-KI auf kostengünstiger Hardware mit Open-Modellen

Die Demokratisierung der KI ist da. Mit Open-Source-LLMs wie Llama, Mistral und Qwen, die nun proprietäre Modelle herausfordern, können Teams eine leistungsstarke KI-Infrastruktur mit Consumer-Hardware aufbauen – und dabei die Kosten drastisch senken, während sie die vollständige Kontrolle über Datenschutz und Bereitstellung behalten.

FLUX.1-dev mit GGUF Q8 ausführen

FLUX.1-dev mit GGUF Q8 ausführen

Beschleunigen Sie FLUX.1-dev mit GGUF-Quantisierung

FLUX.1-dev ist ein leistungsstarkes Text-zu-Bild-Modell, das beeindruckende Ergebnisse liefert, aber dessen Speicherbedarf von über 24GB die Nutzung auf vielen Systemen erschwert. GGUF-Quantisierung von FLUX.1-dev bietet eine Lösung, indem sie den Speicherbedarf um etwa 50% reduziert, während die Bildqualität erhalten bleibt.