
Gestufte Kontexte: Eine Wissenshierarchie für KI-Agenten
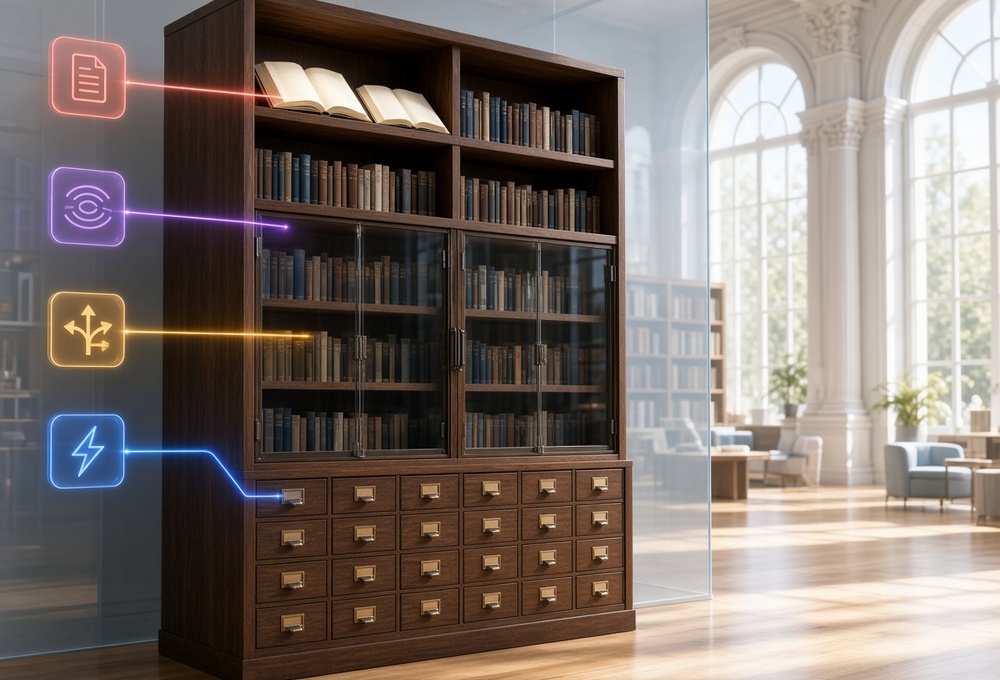
Fünfstufige Wissenshierarchie für das Agenten-Speicher.
Ein Agent mit einer einzelnen, flachen Memory-Datei vergisst nichts; er kann einfach nicht aufhören, Dinge in Erinnerung zu behalten, nach denen er nicht gefragt wurde. Die Lösung ist ein gestufter Kontext, bei dem jede Wissensebene durch einen anderen Trigger eingespeist wird.
Das Fehlermuster besteht nicht im Vergessen, sondern in seinem Gegenteil. In einem einzigen flachen Speicherort lebt jede Tatsache an derselben Stelle, tritt auf dieselbe Weise in den Kontext ein und ist daher auf dieselbe Weise verfügbar – immer. Fragt man den Agenten nach einer E-Mail eines Kunden, so erzählt er beim Verfassen der Antwort von der Router-Konfiguration; bittet man ihn, ein Problem mit einem Dienst zu lösen, erwähnt er die Sponsoring-Gebühr, die letzten Monat zitiert wurde. Der Memory-Haufen ist ein Monolith: Jede Änderung an einer Angelegenheit betrifft jede andere Angelegenheit, und der Spreng_RADIUS jeder Anfrage ist der gesamte Korpus.
Der Standardrat ist verhaltensbasiert: Man lehrt den Agenten, was zum aktuellen Thema relevant ist. Das ist das Software-Äquivalent dazu, „Bitte Vorsicht“ auf eine tragende Wand zu schreiben – der Agent kann instruiert werden, und er wird in der Regel darauf eingehen, bis zu dem Tag, an dem es nicht mehr passiert. Die strukturelle Alternative ist Wissen, das in ein Gespräch nicht einfließen kann, es sei denn, die Aktivität, die es benötigt, findet bereits statt. Dieser Artikel definiert diese Struktur als eine fünfstufige Wissenhierarchie – was jede Ebene ist, was ihre Injektion triggert, was dazugehört und wo sie fehlschlägt – und wendet sie auf eine konkrete Multi-Domain-Konfiguration an: ein allgemeines Profil, eines für das Homelab, eines für Privatangelegenheiten, eines für die Arbeit und eines für Bildung.
Die Hierarchie benennen
Es gibt keinen einzelnen branchenweiten Standardbegriff, daher ist die Definition hier explizit. Eine Wissenhierarchie ist eine geschichtete Anordnung dessen, was der Agent weiß, wobei sich jede Schicht in drei Eigenschaften unterscheidet: wie sie den Kontext des Modells betritt, wie groß sie sein darf und wie lange davon ausgegangen wird, dass sie korrekt bleibt. Auf der Ebene der Wissensarchitektur werden die angrenzenden Paradigmen – PKM, RAG, Wikis und Memory-Systeme – in PKM vs RAG vs Wiki vs Memory-Systeme verglichen, und die Laufzeitverträge, die Assistenten tatsächlich implementieren, werden in Memory-Systeme in KI-Assistenten kartiert. Beide befinden sich innerhalb des Wissensmanagement-Clusters, das die Grundlagen, Methoden und Werkzeuge menschlicher Wissenssysteme abdeckt. Dieser Artikel fügt die triggerbasierte Klassifizierung und die Profilgrenze hinzu, die die Platzierung erzwingbar machen.
Zwei Herkunftslinien erklären die Form der Hierarchie.
Die erste ist die CPU-Speicherhierarchie. Ein Prozessor speichert nicht jedes Byte, das er jemals benötigen könnte, im selben Register. Er hat L1-Cache – klein, immer vorhanden, zugreifbar ohne jede Entscheidungsfindung –, L2, Hauptspeicher und Festplatte, wobei jede Ebene größer ist, langsamer zu erreichen ist und nur zugegriffen wird, wenn die oberen Ebenen nicht die Antwort haben. Die Designregel lautet nicht „Alles schnell halten“. Es lautet: Die meisten Daten sind selten relevant; zahle Zugriffs kosten nur dann, wenn sie es sind. Ein Agent mit einer einzigen flachen Memory-Datei ist eine CPU, bei der alles in den L1-Cache gepresst ist: die Registerdatei ist riesig, daher ist alles sichtbar, einschließlich der Bytes, nach denen die aktuelle Instruktion nicht gefragt hat. MemGPT hat denselben Schritt für Agenten unternommen, indem es Speicher als Ebenen mit expliziter Bewegung zwischen schnellen und langsamen Speichern modelliert.
Die zweite ist die taxonomische Klassifikation des kognitiven Gedächtnisses, die Wissen in prozedurales Gedächtnis (wie man Dinge tut), semantisches Gedächtnis (Tatsachen über die Welt) und episodic Gedächtnis (was passiert ist, wann, wem) einteilt. Die Taxonomie ist relevant, weil sich die Fehlermodi nach Typ unterscheiden: veraltetes prozedurales Wissen ist ein Fehler in Ihrem Arbeitsablauf, veraltetes semantisches Wissen ist eine falsche Tatsache, und ausfließendes episodic Wissen ist ein Datenschutzvorfall. Eine nach Inhaltstyp organisierte Hierarchie, nicht nach Ort, zeigt Ihnen, welche Fehler gefährlich sind.
Die Ordnungsachse für diesen Artikel ist keins der beiden oben Genannten. Klassifizieren Sie Wissen danach, was dazu führt, dass es in den Kontext eintritt. Der Injektions-Trigger ist der Mechanismus, und der Mechanismus ist das, was Sie tatsächlich durchsetzen können. Ein Agentensystem bietet genau vier Trigger:
- Immer. Bedingungslos in jeden Turn injiziert.
- Aufgaben-Trigger. Geladen, wenn die aktuelle Aktivität mit einer deklarierten Bedingung übereinstimmt.
- Semantische Erinnerung. Zum Vorschein gebracht, wenn die aktuelle Nachricht etwas Ähnlichem entspricht, das gespeichert wurde.
- Explizite Referenz. Abgerufen, weil eine Aufgabe die Datei oder die Abfrage benennt.
Jede Ebene der Hierarchie ist dadurch definiert, welcher Trigger sie speist. Das ist das gesamte Design, und der Rest dieses Artikels ist eine Erläuterung einer einzigen Tabelle.
Die fünf Ebenen
| Ebene | Was sie ist | Injektions-Trigger | Typischer Träger | Größen-Disziplin | Schlägt fehl als |
|---|---|---|---|---|---|
| 0 — Identität | Wer der Agent ist, wie er redet, was er nicht tun wird | Immer | SOUL.md oder Äquivalent | Klein; ändert sich selten | Ballast – Identität wird zu einem Fakten-Speicher |
| 1 — Residentes Gedächtnis | Dauerhafte Fakten, die auf jede Sitzung anwendbar sind | Immer | MEMORY.md / USER.md oder Äquivalente | In Zeichen budgetiert; zeiger-dicht | Monolith – Domänenfakten wandern herein |
| 2 — Prozedural | Wie wiederkehrende Aufgaben zu erledigen sind, plus wo deren Daten liegen | Aufgaben-Trigger | Fertigkeiten (Skills) | Begrenzt pro Fertigkeit; Prozeduren, keine Daten | Daten-Schwamm – Fertigkeiten werden zu Datenbanken |
| 3 — Referenz | Das System der Aufzeichnung: Tabellen, Konfigurationen, Verträge, Runbooks | Explizite Referenz | Dateien, Wiki | Unbegrenzt; durchsuchbar, versioniert | Veraltung – niemand aktualisiert die Aufzeichnung |
| 4 — Abgerufenes Gedächtnis | Episodic und relationale Fakten: Entscheidungen, Austausch, Zustandsänderungen | Semantische Erinnerung | Ein Memory-Backend mit Abruf (z. B. ein Vektor-/Graphen-Speicher) | Pro Abruf budgetiert; mit Tags bewertbar | Ausfluss – Abruf bringt die falsche Domäne zum Vorschein |
Lesen Sie die Tabelle entlang der Trigger-Spalte, nicht quer. Ebene 0 und Ebene 1 sind der L1-Cache: Sie bezahlen für ihr Privileg des immer-Vorhandenseins, indem sie winzig sind. Ebene 2 ist der Instruktionen-Cache: Abgerufen bei einer Verzweigbedingung, nämlich wenn die Aufgabe den Trigger der Fertigkeit entspricht. Ebene 3 ist die Festplatte: Sie kann riesig sein, weil nichts in den Kontext eintritt, bis ein Schritt einer Aufgabe explizit eine benannte Datei liest. Ebene 4 ist die unangenehme – sie ist der Hauptspeicher, nach Ähnlichkeit zugegriffen, was der einzige Trigger in der Liste ist, der keine von Ihnen oder der Aufgabe getroffene Entscheidung beinhaltet. Ähnlichkeit ist ein probabilistisches Tor, und deshalb benötigt sie die strengsten externen Kontrollen, die der Profilabschnitt bereitstellt. Das Schubladenbild am Anfang dieses Artikels kodiert dieselbe Idee: Je höher eine Ebene sitzt, desto freier treten ihre Inhalte in ein Gespräch ein, und die Glaspartition markiert, wo das Regal einer Domäne endet.
Ebene 0: Identität
SOUL.md, oder wie auch immer Ihr Agent seinen System-Prompt nennt. Seine Aufgabe ist es, wer zu definieren, nicht was: Ton, Werte, Abgrenzungs-Grenzen und Memory-Politik. Die Memory-Politik gehört hierher, weil sie die einzige Instruktion ist, die in Kraft sein muss, bevor überhaupt ein Gedächtnis konsultiert wird. Eine Identitätsdatei, die zu listen beginnt, Servernamen, Kunden- oder Raten zu nennen, ist bereits fehlgeschlagen – sie ist zu Inhalten der Ebene 1 geworden, die die Abzeichen der Ebene 0 tragen, und sie reitet nun in jedes Gespräch ein, einschließlich solcher, in denen sie nicht erscheinen darf.
Ebene 1: Residentes Gedächtnis
Die persistenten Memory-Dateien: allgemeine Notizen und das Benutzerprofil. Zwei Regeln regieren diese Ebene, und sie sind die Regeln, die eine funktionierende Hierarchie von einem Haufen trennen.
Erstens: Zeiger, keine Fakten. Wenn eine Tatsache nur einer Domäne dient, gehört sie nicht hierher. Der korrekte Eintrag ist nicht die Tatsache selbst, sondern eine Wegweisung:
Infra-Fakten: wiki/infra/ + Memory-Bank 'homelab'.
Kunden und Verträge: wiki/business/clients/ + Bank 'business'.
Die Wegweisung ist domänen-neutral, daher ist es sicher, sie überall mitzuführen. Die Tatsache, auf die sie verweist, wird nur von der Aktivität geladen, die das Ziel benannt hat.
Zweitens: Ein hartes Budget, durchgesetzt. Wenn der Speicher keine Zeichenbegrenzung hat, füllt er sich, und die Befüllung ist immer mit dem zuletzt diskutierten Thema – daher verdrängt eine Infra-Woche still den allgemeinen Kontext oder umgibt ihn mit Infra. Ein fast volles Budget erzwingt Triage, und Triage ist der einzige Mechanismus, der diese Ebene ehrlich hält. Die Hermes-Implementierung ist ein funktionierendes Beispiel: MEMORY.md, begrenzt auf 2.200 Zeichen, und USER.md auf 1.375, injiziert als eingefroener Block zu Beginn der Sitzung, sind in Hermes Agent Memory System dokumentiert.
Ebene 2: Prozedurales Wissen
Fertigkeiten (Skills) sind die Art und Weise, wie der Agent wie kodiert: die Prozedur, die Fallstricke und – entscheidend für diesen Artikel – die Zeiger in die tieferen Ebenen. Eine Fertigkeit für die Homelab-Verwaltung benennt, welches Wiki-Verzeichnis das Inventar hält und welche Memory-Bank abzurufen ist. Eine Fertigkeit für Kundenarbeit benennt den Vertragspeicher und die Business-Bank. Die Beschreibung der Fertigkeit ist ihr Trigger: Sie ist die Verzweigbedingung, die entscheidet, ob die Prozedur und damit ihre Zeiger überhaupt in den Kontext eintritt.
Dies ist die Ebene, die die Hierarchie operationell zum Laufen bringt, weil sie die Nahtstelle zwischen „welche Aktivität stattfindet“ und „welche Daten diese Aktivität sehen darf“ ist. Eine Aufgabe über eine Kunden-E-Mail lädt die Kunden-Fertigkeit; die Kunden-Fertigkeit benennt die Business-Bank und das Verträge-Verzeichnis; die Homelab-Bank und das Infra-Verzeichnis werden schlichtweg nie von einem Pfad referenziert, den die Aufgabe beschritten hat.
Das Fehlermuster ist Daten-Schwamm: das Einfügen der eigentlichen Kundenliste oder der eigentlichen IP-Tabelle in den Körper der Fertigkeit. Dann werden die Daten immer geladen, wann immer die Prozedur geladen wird, und der Trigger der Prozedur ist zur Offenbarungsgrenze der Daten geworden. Fertigkeiten tragen den Weg zu den Daten, und nichts anderes, das sensibel ist.
Ebene 3: Referenzdaten
Das Wiki, der Notizen-Baum, das System der Aufzeichnung. Dies ist die Ebene mit den wenigsten Einschränkungen und den wenigsten Überraschungen, weil sie die einzige Ebene mit einem deterministischen Zugriffspfad ist: Etwas tritt nur in den Kontext ein, weil ein Schritt einer Aufgabe diese Datei explizit gelesen hat. Tabellen, Inventare, Verträge, Runbooks, Statistiken – das Zeug, das man in einer Datenbank oder einem Konfigurationsmanagementsystem aufbewahren würde. Wenn der Korpus von einem LLM gewartet wird, gilt das LLM-Wiki-Muster: Die Synthese geschieht zur Ingest-Zeit, und das Ergebnis wird als strukturierte, verlinkte Seiten gespeichert.
Der Grund, warum Referenzdaten hier und nicht in Ebene 4 dazugehören, ist, dass Abrufqualität das falsche Werkzeug für Tabellen ist. Semantische Erinnerung ist ausgezeichnet für „was hat Kunde X über die Deadline bestätigt“ und furchtbar für „welcher Port gehört zum Dienst auf Host Y“ – Letzteres hat genau eine korrekte Zeile, und ein Reranker, der die drei nächsten Absätze zurückgibt, ist eine Last. Deterministische Nachschlage gewinnt für Referenzdaten; Ähnlichkeit gewinnt für Episoden. Halten Sie sie getrennt, und das Zugriffsmuster jeder Ebene passt zu ihrer Inhaltsform.
Das Fehlermuster ist Veraltung, was ein Wartungsproblem ist, kein Architekturproblem: Die Aufzeichnung driftet von der Realität ab, und der Agent, der alles richtig macht, arbeitet von einer falschen Tabelle. Die Milderung ist dieselbe, die jedes System der Aufzeichnung braucht – ein Schreiber pro Datei, Änderungsprotokolle und ein Audit-Takt – plus die Drift-Erkennungs- und Widerspruchsprüf-Praxen, die in LLM Wiki-Wartung: Drift, Widersprüche und Prüfung abgedeckt werden.
Ebene 4: Abgerufenes Gedächtnis
Ein Memory-Backend mit automatischem pro-Turn-Abruf: das episodic und relationale Gedächtnis des Agenten. Entscheidungen und ihre Daten, „Kunde X bestätigte Y“, „wir haben Z versucht und es hat nicht funktioniert.“ Hier lebt der dynamische, selbstorganisierende Teil des Systems – und hier wird die Sicherheitsgeschichte interessant, weil semantische Erinnerung ein probabilistisches Tor ist und probabilistische Toren ausfließen.
„Rechnungsstellungsfrage für Kunde X“ und „welcher Host betreibt den Abrechnungsserver“ sind nah im Embedding-Raum. Jede einzelne Bank, die sowohl die Kundenakten als auch das Infrastruktur-Inventar hält, wird mit nicht-trivialer Wahrscheinlichkeit Letzteres bei Ersterem zum Vorschein bringen. Man kann dies mit Tags und Abrufbeschränkungen eingrenzen, und man sollte es – aber ein Tagfilter auf einem gemischten Korpus ist eine Disziplin, keine Struktur. Die strukturelle Antwort ist, zu stoppen zu mischen: eine Bank pro Domäne, so dass der Ausflussradius eines Abrufs per Konstruktion eine Domäne ist. Die Wahl des Backends selbst – Erfassungspolitk, Abhängigkeiten, Self-Hosting-Einschränkungen – ist ein separater Vergleich, abgedeckt in [Agent Memory Providers im Vergleich](https://www.glukhov.org/de/ai-systems/memory/agent-memory-providers/ “Vergleich von Hermes- und OpenClaw-Memory-Backends nach Erfassungspolitk, Abhängigkeiten und Self-Hosting.”}).
Zwei mechanische Details sind wichtig, wenn man diese Ebene verdrahtet. Schreibpfade und Lesepfade sind separate Kontrollen: Eine Bank kann in den Abruf aufgenommen werden, während sie von der Retention ausgeschlossen wird, wie man ein Profil baut, das alles liest und nichts schreibt. Und jede Bank sollte ihre eigene Retention-Mission tragen – eine kurze Aussage darüber, was diese Bank existiert, um zu halten. Eine Business-Bank mit der Mission „Kundenkorrespondenz, Vertragsbedingungen, Verhandlungszustand; nie Infrastruktur-Details“ wird dementsprechend extrahieren, weil Extraktion ein LLM-Aufruf ist, der die Mission liest. OpenAIs Personalisierungs-Kochbuch behandelt Konsolidierung als die empfindlichste und fehleranfälligste Stufe eines Memory-Lebenszyklus – die Retention-Mission ist der Vertrag, der diese Stufe ehrlich hält.
Profile: Die Grenze, die Trennung strukturell macht
Bis hierhin trennt die Hierarchie Wissen nach Ebene – notwendig, aber nicht ausreichend. Die fünf Ebenen oben sind die Anatomie eines Agenten. Die Frage, mit der dieser Artikel begann, dreht sich um Domänen: Homelab, Privat, Arbeit, Bildung und der allgemeine Kontext, der sie überspannt.
Der Mechanismus für die Domänen-Trennung ist das Profil – eine vollständige, unabhängige Instanz des Agenten: seine eigene Identitätsdatei, sein eigenes residentes Gedächtnis, sein eigener Fertigkeiten-Verzeichnis, seine eigenen geplanten Jobs und, entscheidend, sein eigenes Memory-Bank-Verdrahtung. Ein Profil ist kein Tag auf einem Gespräch; es ist ein separates System, das zufällig eine Maschine teilt. Wenn Sie agent -p homelab ausführen, erhalten Sie einen Prozess, dessen gesamte Ebene 0 bis Ebene 4 auf die Homelab-Domäne beschränkt ist und dessen Abruf-Pool die Business-Bank nicht enthalten kann, weil die Business-Bank gar nicht in seiner Konfiguration ist.
Das ist der Unterschied zwischen den beiden Antworten auf das Leck-Problem. „Keine Infrastruktur in Business-Gesprächen offenlegen“ ist eine Prompt-Instuktion – eine Wahrscheinlichkeit. „Der Abruf-Pool des Business-Profils enthält nicht die Infrastruktur-Bank“ ist eine Konfiguration – eine Garantie. Die Hierarchie sagt Ihnen, was wohin gehört; die Profilgrenze ist es, was die Platzierung von innen aus dem Gespräch heraus nicht umgehbar macht.
Das durchgerechnete Beispiel, fünf Domänen:
| gemeinsames (Default) | Homelab | privat | Arbeit | Bildung | |
|---|---|---|---|---|---|
| Identität (L0) | Gemeinsame Basis + Memory-Politik | Basis + „Infra-Operator“-Rahmen | Basis + „privat, kein Business-Ton“ | Basis + „professionell, kundenorientiert“ | Basis + „Lehrer, keine Vorwissen annehmen“ |
| Residentes Gedächtnis (L1) | Nur Zeiger – zu den vier Domänen-Heimen | Homelab-Zeiger, Maschinenfakten | Private Zeiger | Arbeits-Zeiger | Kurs-Zeiger |
| Fertigkeiten (L2) | Allgemeine Workflow-Fertigkeiten | Infra-Fertigkeiten, Runbook-Fertigkeit, Monitor-Fertigkeit | — | Kunden-Betriebsfertigkeit, Outreach-Fertigkeit | Unterrichtplanung-Fertigkeit |
| Referenz (L3) | Geteilter Index des Wikis | wiki/infra/ | wiki/personal/ | wiki/business/clients/ | wiki/education/ |
| Gehaltene Bank (L4) | Keine (nur-Lesen) | Bank: Homelab | Bank: privat | Bank: Business | Bank: Bildung |
| Nur-Abruf-Bänke (L4) | Homelab, privat, Business, Bildung | — | — | — | — |
Zwei Zellen in dieser Tabelle leisten die Schwerstarbeit.
Die Bank-Zelle des gemeinsamen Profils ist „keine, nur-Lesen“. Das allgemeine Gespräch ist der Ort, an dem man durchgreifende Fragen stellt, daher sollte es die abgerufenen Fakten jeder Domäne sehen können – aber es darf in keine davon schreiben. Geplapper in einer allgemeinen Sitzung ist genau das Material, das man nicht in das dauerhafte Gedächtnis einer Domäne extrahieren möchte, und die nur-Lesen-Verdrahtung entfernt die Wahl vollständig vom Modell. Wenn die Verdrahtung des Backends nur-Abruf-Banken-Listen unterstützt (separat von Schreib-Banken), ist das eine Konfigurationszeile pro Domänen-Bank; wenn nicht, ruft das gemeinsame Profil aus einer dedizierten allgemeinen Bank ab und man akzeptiert eine schwächere Querschnittsansicht.
Die Abruf-Zeilen der Domänen-Profile sind leer. Jedes Domänen-Profil sieht genau eine Bank. Das Homelab-Profil wird niemals einen Vertragsbegriff eines Kunden abrufen, nicht weil ihm gesagt wurde, es nicht zu tun, sondern weil der Begriff nicht im Pool ist, den es abfragt. Das ist die bidirektionale Trennung, um die es in der ganzen Übung geht: Sie funktioniert per Konstruktion symmetrisch, ohne dass in irgendeine Richtung eine Instruktion involviert ist.
Drei operationelle Konsequenzen folgen daraus, und sie sind der Grund, warum der Profil-Ansatz mehr kostet als der Ein-Agenten-Ansatz, aber für jeden, dessen Domänen wirklich disjunkt sind, den Aufwand wert ist.
- Der Trigger wird zur Oberfläche. Wenn die Homelab-Arbeit in einem Terminal stattfindet, das Sie mit
-p homelabstarten, und Kundenarbeit auf einem Messaging-Konto stattfindet, das an das Arbeits-Profil geroutet wird, dann welche Mütze Sie tragen, eine Eigenschaft dessen, wie Sie den Agenten aufgerufen haben, nicht ein Flag, an das Sie sich erinnern müssen es zu sagen. Fehlführung – versehentlich Kunden-Aufgaben im Homelab-Kontext auszuführen – wird so sichtbar wie das Führen des falschen Shells. - Geplante Arbeit erbt die Grenze. Cron-Jobs und delegierte Teil-Aufgaben laufen innerhalb dessen Profils, das sie besitzt. Ein nächtlicher Infra-Check, der im Homelab-Profil geplant ist, kann keinen Business-Inhalt in die Homelab-Bank driften lassen, weil er ihn nie hat.
- Das Dateisystem ist geteilt, und das ist die ehrliche Grenze. Profile trennen Kontext, nicht Zugriff. Das Terminal jedes Profils kann die Dateien jedes Profils lesen; die Grenze schützt Gespräche, nicht Festplatten. Daher brauchen die Ebenen, die wirklich sensibles Material halten, ihre eigene Disziplin: Zugangsdaten in einer Umgebungsdatei oder einem Secret-Store statt in Wiki-Klartext, das Wiki außerhalb eines öffentlichen Repositories und pro-Verzeichnis-Berechtigungen, wo das Betriebssystem hilft. Behandeln Sie die Profilgrenze als eine Firewall für Kontext – ausgezeichnet bei ihrer Aufgabe – und lassen Sie sie nicht für eine für Daten gehalten werden.
Bootstrap von einem flachen Haufen
Die Hierarchie wird meist von unten erreicht: ein Agent, der mit einer einzigen Memory-Datei begann und nun alles darin hält. Die Migrationsreihenfolge ist wichtig, weil jeder Schritt nur billig ist, wenn der vorherige erledigt ist.
Erstens: Trennen Sie den Abruf-Pool. Das Erstellen einer Memory-Bank pro Domäne ist eine Konfigurationsänderung, keine Inhalts-Umschreibung – und es ist der Schritt mit der höchsten Hebelwirkung, weil der Abruf-Ausfluss aufhört, am Tag, an dem die Banken getrennt sind. Inhalte können danach migrieren; die Grenze sollte nicht darauf warten.
Zweitens: Budgetieren Sie Ebene 1. Setzen Sie eine Zeichen-Begrenzung für die residenten Dateien, und auditieren Sie dann, was bereits darin ist, gegen die Begrenzung. Domänenspezifische Fakten werden zu Zeigern auf ihren zukünftigen Wohnort; was bleibt, ist das, was wirklich auf jede Sitzung anwendbar ist.
Drittens: Geben Sie den demotierten Fakten ein Ziel. Ein Wiki-Verzeichnis pro Domäne, mit der Ein-Schreiber- und Änderungsprotokoll-Disziplin, nimmt auf, was Ebene 1 freigibt. Fertigkeiten holen die Zeiger zu ihm zuletzt, weil eine Fertigkeit, die ein Verzeichnis benennt, das noch nicht existiert, schlechter ist als keine Fertigkeit.
Wo die Hierarchie verfault
Die Architektur ist nur so gut wie ihre Wartung, und jede Ebene verfault auf charakteristische Weise.
Ebene 1 füllt sich zuerst. Sie ist die Ebene mit dem bequemsten Schreibpfad („erinner dich einfach daran“), daher ist sie die erste, die domänenfakten im Verborgenen akkumuliert. Das Budget macht dies sichtbar: Wenn der Speicher 90% voll ist, auditieren Sie ihn auf Einträge, die Zeiger sein sollten. Die Lösung ist immer derselbe Schritt – demotieren Sie Fakten auf Ebene 3, promovieren Sie die Wegweisung.
Ebene 2 kriecht als zweites. Fertigkeiten sind der Ort, an dem Prozeduren und Daten zusammenleben wollen, weil „die Prozedur referenziert die Daten ständig“ zum Schreibzeitpunkt vernünftig erscheint. Der Check ist mechanisch: Wenn der Körper einer Fertigkeit eine Tabelle enthält, die die Quelldaten für etwas ist, gehört sie ins Wiki, und die Fertigkeit sollte einen Pfad tragen.
Ebene 4 driftet still. Abgerufenes Gedächtnis ist anhang-orientiert und selbst erklärend, daher werden veraltete Episoden nie korrigiert, nur übertroffen. Die Abruf-Prämisse („diese Erinnerungen sind historischer Kontext, keine verifizierte Fakten“) ist die Standard-Milderung. Die sauberere Milderung ist dieselbe, die Ebene 3 nutzt: Wenn eine Episode zu einer dauerhaften Tatsache wird („der Kunde hat an diesem Datum zu diesen Bedingungen unterschrieben“), wird sie in das System der Aufzeichnung geschrieben, wo sie sichtbar und editierbar ist, und die Bank behält nur die Erzählung. Eine schärfere Variante dieser Drift – die eigene Inferenz des Agenten als Beweismaterial zurückgeschrieben – wird in Selbstverstärkende Memory-Schleifen in KI-Agenten durchgespielt.
Profile vermehren sich. Fünf Profile sind managebar; fünfzehn sind eine Flotte. Die Disziplin ist, dass ein neues Profil nur erscheint, wenn eine neue Domäne erscheint – nicht für ein neues Projekt, ein neues Werkzeug oder eine neue Stimmung. Projekt-Trennung ist dafür da, was die Verzeichnisstruktur der Referenzebene ist; Domänen-Trennung ist dafür da, was Profile sind. Die Verwechslung beider ist der Weg, wie man auf einen Profil-Zoo und keine klare Abruf-Geschichte landet.
Das Fazit: eine Platzierungsregel
Legen Sie jedes Stück Wissen an die flachste Ebene, deren Trigger seinen Bedarf abdeckt: immer benötigte Fakten als Zeiger im residenten Gedächtnis, Prozeduren in Fertigkeiten, Referenzdaten in Dateien, Episoden in einer Bank – und stellen Sie die Bank jeder Domäne hinter ein Profil, das das Profil keiner anderen Domäne abrufen kann. Der Agent verhält sich dann wie ein gut designtes System: das richtige Wissen ist vorhanden, weil die richtige Aktivität es angefordert hat, das falsche Wissen ist abwesend, weil nichts im Gespräch einen Pfad zu ihm hatte, und das Einzige, das die beiden zusammenzwingen könnte, ist eine Änderung der Konfiguration – etwas, das man bewusst trifft und daher sehen kann, wenn es passiert.
Der flache Haufen war nie ein Disziplin-Fehler. Es war eine Architektur, in der jede Tatsache einen einzigen Trigger teilt, und dieser Trigger ist „immer“. Trennen Sie den Trigger, und die Lecks hören auf, eine Frage des Urteils des Modells zu sein. Sie hören auf, möglich zu sein.
Referenzen
- PKM vs RAG vs Wiki vs Memory-Systeme — der grundlegende Vergleich von persönlichen Wissensspeichern, Abrufpipelines und Agentengedächtnis
- Memory-Systeme in KI-Assistenten — der Laufzeit-Memory-Stack, in dem diese Hierarchie sitzt
- Abruf vs Darstellung in Wissenssystemen — warum die Form Ihres Speichers bestimmt, was er beantworten kann
- KI-Systeme Memory Hub
