
Qwen 3.6 27B und 35B MTP im Vergleich zur Standard-Version auf einer 16-GB-GPU
MTP vs. Standard-Decoding auf der RTX 4080 – echte Benchmarks
Ich habe die Leistung des spekulativen Dekodierens (Multi-Token Prediction, MTP) in Qwen 3.6 27B und 35B auf einer RTX 4080 mit 16 GB VRAM getestet.
Für einen umfassenderen Blick auf die Token-Geschwindigkeiten und die Abwägungen bei der VRAM-Nutzung über weitere Modelle hinweg auf derselben Hardware, siehe 16 GB VRAM LLM-Benchmarks mit llama.cpp.
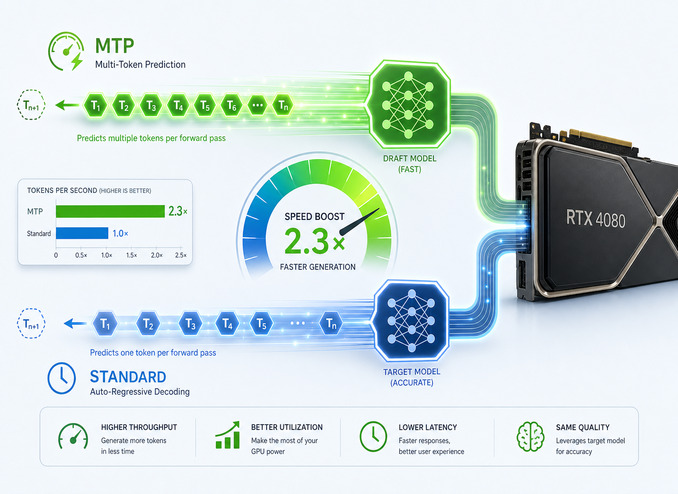
Was MTP (Multi-Token Prediction) ist
Multi-Token Prediction ist eine Form des spekulativen Dekodierens, die direkt in bestimmten Modell-Checkpoints integriert ist. Anstatt pro Vorwärtsdurchlauf ein Token zu vorhersagen, trägt das Modell zusätzliche „MTP-Header“, die mehrere zukünftige Tokens in einem einzigen Schritt vorschlagen – und diese anschließend parallel verifiziert. Wenn die Vermutungen akzeptiert werden, steigt der effektive Durchsatz, ohne die Ausgabequalität zu verändern.
Die Qwen-3.6-Familie bietet sowohl **Standard-**GGUF-Dateien als auch Varianten mit aktiviertem MTP an. In llama.cpp wird MTP wie folgt aktiviert:
--spec-type draft-mtp --spec-draft-n-max 3
--spec-draft-n-max ist der entscheidende Stellschraubpunkt. Er legt fest, wie viele spekulative Tokens der MTP-Header in jedem Schritt vorschlägt. Höhere Werte liefern einen potenziellen Geschwindigkeitsvorteil, erfordern aber zusätzlichen VRAM für die Entwurfs-Puffer – eine reale Einschränkung bei Karten mit 16 GB.
Was und wie ich getestet habe
Ich habe getestet, wie sich die beiden Qwen-3.6-Modelle bei aktiviertem MTP im Vergleich zum Standard-Dekodieren auf einer GPU mit 16 GB VRAM (RTX 4080) verhalten.
Um die Modellgewichte und den KV-Cache in den VRAM zu bringen, verwendete ich stark quantisierte Varianten:
Qwen3.6-27B-UD-IQ3_XXSundQwen3.6-27B-UD-IQ3_XXS-MTPQwen3.6-35B-A3B-UD-IQ3_SundQwen3.6-35B-A3B-UD-IQ3_S-MTP
Pro Lauf werden zwei Kontext-Budgets verfolgt:
- Ø Kontext – die Kontextgröße, bei der llama.cpp etwa 14,8 GB VRAM belegt, sodass anderen Anwendungen (Xorg, GNOME Shell, Cursor) ein komfortabler Puffer von ca. 500 MB bleibt.
- Max. Kontext – der größte Kontext, den llama.cpp zuweisen konnte, unter der Voraussetzung, dass die genannten Desktop-Anwendungen bereits etwa 500 MB VRAM belegen.
Ein wesentlicher Grund dafür, den Durchschnittskontext auf ein praktikables Ziel zu halten, ist, dass Hermes Agent – den ich als primären KI-Assistenten verwende, der auf dieser Maschine mit llama.cpp verbunden ist – standardmäßig mindestens 64 K Kontext erfordert und Modelle mit einem kleineren Fenster beim Start zurückweist. Modelle unterhalb dieser Schwelle können nicht genügend Arbeitspeicher für mehrstufige Tool-Aufruf-Workflows aufrechterhalten. Für llama.cpp bedeutet dies, --ctx-size 65536 oder höher zu übergeben. Jede MTP-Konfiguration, die den durchschnittlichen nutzbaren Kontext deutlich unter 64 K komprimiert, ist daher für tägliche Hermes-Workflows ungeeignet, weshalb die Ø-Kontext-Zahlen in den folgenden Tabellen die entscheidendsten sind.
Beide KV-Cache-Quantisierungsebenen wurden getestet: q8 (höhere Qualität, mehr VRAM) und q5 (weniger VRAM, längerer Kontext). Beachten Sie, dass der Wechsel von q8 zu q5 beim KV-Cache zu einem deutlichen Qualitätsverlust führen kann – in meinen Tests war die Degradation erheblich genug, um q5 für meine Workflows unbrauchbar zu machen. Die Geschwindigkeits- und Kontextzahlen für q5 sind der Vollständigkeit halber aufgeführt, Sie sollten jedoch die Antwortqualität bei Ihren eigenen Aufgaben testen, bevor Sie sich dafür entscheiden.
Qwen 3.6 27B MTP vs. Standard
KV-Cache q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prompt-Geschw. | 148 t/s | 151 t/s | 148 t/s | 147 t/s | 200 t/s |
| Gen-Geschw. | 65 t/s | 75 t/s | 73 t/s | 75 t/s | 45 t/s |
| Ø Kontext | 40 K | 40 K | 40 K | 30 K | 80 K |
| Max. Kontext | 60 K | 60 K | 60 K | 50 K | 100 K |
Mit q8-KV-Cache liefert MTP bei --spec-draft-n-max 2 eine um etwa 67 % schnellere Generierung (75 gegenüber 45 t/s) auf Kosten einer Halbierung des durchschnittlichen Kontextfensters von 80 K auf 40 K. Die Prompt-Eingabegeschwindigkeit fällt von 200 auf ca. 150 t/s, da MTP während der Prefill-Phase Übertragungen vom Gerät zum Host erfordert.
KV-Cache q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prompt-Geschw. | 145 t/s | 144 t/s | 141 t/s | 139 t/s | 191 t/s |
| Gen-Geschw. | 57 t/s | 62 t/s | 67 t/s | 66 t/s | 41 t/s |
| Ø Kontext | 70 K | 60 K | 60 K | 50 K | 130 K |
| Max. Kontext | 100 K | 100 K | 90 K | 80 K | 160 K |
Der Wechsel zu q5-KV-Cache stellt einen sinnvollen Kontext wieder her: --spec-draft-n-max 1 liefert 70 K durchschnittlichen Kontext bei 57 t/s – eine um 39 % schnellere Generierung im Vergleich zum Standard-Dekodieren, bei der das Kontextfenster dennoch eine nützliche Größe behält. Bei --spec-draft-n-max 3 sinkt der Kontext auf 60 K, aber die Generierung erreicht 67 t/s (+63 %).
Fazit Qwen 3.6 27B
MTP ist für das 27B-dichte Modell genuinely nützlich. Der Sweet Spot bei 16 GB VRAM ist:
- q8 KV +
--spec-draft-n-max 2– schnellste Rohgeschwindigkeit (75 t/s), Kontext sinkt auf 40–60 K - q5 KV +
--spec-draft-n-max 1– bestes Verhältnis von Geschwindigkeit zu Kontext (57 t/s, 70 K Ø-Kontext)
Qwen 3.6 35B MTP vs. Standard
Das 35B-Modell nutzt eine Mixture-of-Experts- (MoE-)Architektur (35B-A3B bedeutet 35B Gesamtparameter, ca. 3B aktive pro Token). MoE-Modelle profitieren in der Regel stärker von MTP, da die spärliche Routenfindung den MTP-Header im Verhältnis zu einem vollständigen Vorwärtsdurchlauf rechnerisch günstig hält.
KV-Cache q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_S) | |
|---|---|---|---|---|---|
| Prompt-Geschw. | 277 t/s | 277 t/s | 265 t/s | 275 t/s | 368 t/s |
| Gen-Geschw. | 186 t/s | 189 t/s | 180 t/s | 171 t/s | 146 t/s |
| Ø Kontext | 15 K | 10 K | — | — | 80 K |
| Max. Kontext | 80 K | 70 K | 60 K | 50 K | 150 K |
Die MoE-Architektur liefert eine beeindruckende Roh-Generierungsgeschwindigkeit mit MTP (+27 % bei max 1, +29 % bei max 2 gegenüber 146 t/s im Standard). Aber das praktische Problem ist der Durchschnittskontext. Mit q8-KV-Cache liefert selbst --spec-draft-n-max 1 nur 15 K durchschnittlichen Kontext – kaum genug für moderate Aufgaben. Höhere Entwurfstiefen haben auf einer 16-GB-Karte überhaupt keinen tragfähigen Durchschnittskontext.
Das ist die zentrale VRAM-Kostenfrage für MTP auf Consumer-Hardware: Die zusätzlichen Entwurfs-Puffer fressen direkt in das verbleibende VRAM-Budget, und das 35B-A3B-Modell mit q8-KV-Cache lässt sehr wenig Spielraum.
KV-Cache q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_S) | |
|---|---|---|---|---|---|
| Prompt-Geschw. | 264 t/s | 266 t/s | 270 t/s | 264 t/s | 343 t/s |
| Gen-Geschw. | 151 t/s | 147 t/s | 137 t/s | 131 t/s | 122 t/s |
| Ø Kontext | 10 K | — | — | — | 120 K |
| Max. Kontext | 120 K | 110 K | 110 K | 80 K | 200 K |
q5-KV-Cache verbessert die Geschichte des Durchschnittskontextes nur marginal. --spec-draft-n-max 1 liefert 10 K Durchschnittskontext bei 151 t/s. Standard-Dekodieren bei q5 liefert 122 t/s bei 120 K Durchschnittskontext.
Fazit Qwen 3.6 35B
Auf einer 16-GB-GPU steht das 35B-MoE-Modell mit MTP vor einer harten Grenze: Der durchschnittliche nutzbare Kontext bricht auf 10–15 K Tokens ein, was es für reale Workflows unpraktikabel macht. Standard-Dekodieren bei 122–146 t/s mit 80–120 K Kontext ist für echte Aufgaben deutlich nützlicher.
Wenn Sie 24 GB oder mehr VRAM haben, wird die Kombination aus 35B + MTP deutlich attraktiver – das Kontextfenster-Problem verschwindet und Sie behalten den Geschwindigkeitsvorteil.
Die richtige --spec-draft-n-max-Wert wählen
Die Frage, wie viele spekulative Tokens pro Schritt vorgeschlagen werden sollen (--spec-draft-n-max), hat nicht eine einzige richtige Antwort – sie hängt sowohl von der Modellarchitektur als auch vom verfügbaren VRAM ab:
- Für 27B dichte Modelle auf 16 GB:
--spec-draft-n-max 2mit q8 KV ist das schnellste,--spec-draft-n-max 1mit q5 KV ist das kontextfreundlichste. - Für 35B MoE auf 16 GB:
--spec-draft-n-max 1ist die einzige Option, die irgendeinen nutzbaren Kontext beibehält, und selbst dann nur marginal. - Höhere Werte (
3,4) erhöhen den VRAM-Druck ohne proportionalen Geschwindigkeitsgewinn – bei max 4 geben Sie ungefähr den gleichen zusätzlichen VRAM aus wie bei max 2, aber die Generierungsgeschwindigkeit hält nicht Schritt.
So aktivieren Sie MTP in llama.cpp
Stellen Sie sicher, dass Sie ein MTP-fähiges GGUF verwenden (der Dateiname enthält MTP). Wenn Sie neu in der Verwendung von llama.cpp-Flags sind, behandelt llama.cpp Quickstart mit CLI und Server alle Grundlagen. Starten Sie dann llama-server oder llama-cli mit:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 40000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Für q5-KV-Cache ersetzen Sie q8_0 durch q5_1 oder q5_0 und passen Sie --ctx-size nach oben an:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 80000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 1
MTP wird automatisch aktiviert, sobald llama.cpp die MTP-Header in der GGUF-Datei erkennt und --spec-type draft-mtp gesetzt ist.
Das Standard-Qwen3.6-27B-UD-IQ3_XXS.gguf funktioniert also nicht im MTP-Modus, Sie benötigen Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf.
Aber das Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf kann sowohl im spekulativen Dekodiermodus als auch im autoregressiven Modus verwendet werden.
Fazit
Auf einer 16-GB-GPU (RTX 4080), mit diesen Quantisierungen, ist das MTP von llama.cpp ein klarer Gewinn für Qwen 3.6 27B und ein Netto-Nachteil für Qwen 3.6 35B in der praktischen Nutzung:
Qwen 3.6 27B (IQ3_XXS) – MTP lohnt sich:
- q8 KV + MTP max 2 → um ca. 67 % schnellere Generierung, Kontext 40–60 K (gegenüber 80–100 K ohne MTP)
- q5 KV + MTP max 1 → um ca. 39 % schnellere Generierung, Kontext 70–100 K (gegenüber 130–160 K ohne MTP)
- Gutes Gleichgewicht zwischen Geschwindigkeit und VRAM-Effizienz bei
--spec-draft-n-max 2
Qwen 3.6 35B (IQ3_S) – MTP ist bei 16 GB nicht praktikabel:
- Die Generierungsgeschwindigkeit ist 27–29 % höher, aber der Durchschnittskontext bricht auf 10–15 K bei q8 und 10 K bei q5 ein
- Standard-Dekodieren bei 122–146 t/s mit 80–120 K Kontext ist für reale Aufgaben nützlicher
- Die Situation verbessert sich erheblich bei 24 GB oder mehr VRAM
Auf dem Papier ist der q5-KV-Cache die offensichtliche Antwort, um das Kontextfenster zu maximieren, während die MTP-Geschwindigkeitsgewinne erhalten bleiben – aber in der Praxis kann der Qualitätsverlust beim Wechsel von q8 zu q5 erheblich sein. Testen Sie q5 bei Ihren eigenen Aufgaben, bevor Sie es übernehmen; für meine Workflows war die Degradierung inakzeptabel, und q8 mit einem strafferen Kontextbudget bleibt der bessere Kompromiss.
Für das umfassendere Bild der LLM-Serving-Optionen und der Infrastruktur-Abwägungen, siehe die Säule LLM-Hosting in 2026 und LLM-Leistung in 2026. Wo diese 27B-Klasse im Spektrum von Größe und Kosten für 2026 steht, und warum ein aktueller Qwen3.8-27B Q4-Build eine 24-GB-Karte benötigt, während die Messungen oben bei 16 GB bleiben, finden Sie in Die effiziente Frontier offener Modelle in 2026. Wenn Sie die Sampler-Einstellungen von Qwen 3.6 zusammen mit MTP feinjustieren, ist die Referenz für agentic LLM-Inferenzparameter für Qwen 3.6 und Gemma 4 eine nützliche Begleitung.
