AI Coding

gstack: KI-Software-Engineering-Stack

gstack: KI-Software-Engineering-Stack

Eine Softwarefabrik, gebaut aus Agenten-Fähigkeiten

KI-Coding-Agenten können bereits Funktionen schreiben, Repositorien modifizieren, Tests ausführen und Pull Requests öffnen. Das schwierigere Problem ist es, einen Agenten dazu zu bringen, einen wiederholbaren Engineering-Prozess vor, während und nach dem Schreiben des Codes zu befolgen.
OpenSpec abgelehnte Vorschläge: Eine Konvention für die Entscheidungsgeschichte

OpenSpec abgelehnte Vorschläge: Eine Konvention für die Entscheidungsgeschichte

Kein Ablehnungszustand. Hier ist der Workaround.

Ein Agent, der vor sechs Monaten „Persistenz in eine Shared Library verlagern“ vorgeschlagen und umgesetzt hat, wird dieses Vorschlag im nächsten Quartal wieder gern machen, es sei denn, etwas Dauerhaftes teilt ihm mit, dass diese Idee bereits untersucht und abgelehnt wurde – und OpenSpec verfügt heute über keinen eingebauten Zustand dafür.

OpenSpec-Einstieg: Installation, Workflow und häufige Fehlerquellen

OpenSpec-Einstieg: Installation, Workflow und häufige Fehlerquellen

Spezifikationen als Deltas, nicht als 40-seitiges PRD.

OpenSpec ist eine kostenlose, Open-Source-CLI von Fission AI, die sicherstellt, dass Sie und Ihr Coding-Agent sich vor dem Schreiben von Code über eine Änderung in klarem Markdown einigen, ohne die phasenbasierte Formalität schwerer, spezifikationsgetriebener Frameworks.

Agent-Fähigkeiten vs. MCP-Server: Entscheidungsrahmen

Agent-Fähigkeiten vs. MCP-Server: Entscheidungsrahmen

Fertigkeit, MCP-Server oder beides?

Agent Skills und MCP-Server werden oft als konkurrierende Ansätze zur Erweiterung eines KI-Agenten dargestellt. Diese Einordnung ist falsch: Eine Skill lehrt den Agenten, wie er arbeitet, während ein MCP-Server ihm kontrollierten Zugriff auf live Funktionen gewährt.

Superpowers Quickstart: Installation, Workflow und Test

Superpowers Quickstart: Installation, Workflow und Test

Erzwungene SDD-Fähigkeiten, installiert mit einem einzigen Befehl.

Superpowers bündelt eine vollständige, spec-gesteuerte Methodik in installierbare Claude-Skills und erzwingt Brainstorming, Planung, subagentenbasierte Implementierung und striktes TDD (Testgetriebene Entwicklung), anstatt diese Struktur der freien Gestaltung zu überlassen.

Pi Coding Agent im Test: Minimale, anpassbare KI-CLI zum Programmieren

Pi Coding Agent im Test: Minimale, anpassbare KI-CLI zum Programmieren

Ein kleiner Coding-Agent, der darauf ausgelegt ist, von Ihnen geformt zu werden.

Pi Coding Agent ist ein minimalistisches, quelloffenes Terminal-Coding-Harness, das mit vier Standard-Tools ausgeliefert wird und das meiste Verhalten an Erweiterungen, Skills und Ihren eigenen Workflow überlässt.

Claude Code Subagenten: Einrichtung, Konfiguration und Einsatzszenarien

Claude Code Subagenten: Einrichtung, Konfiguration und Einsatzszenarien

Delegieren Sie die lärmintensive Arbeit und halten Sie Ihren Kontext sauber.

Die meisten Claude Code-Sitzungen werden aus demselben Grund langsam und unübersichtlich: Jeder explorative Grep-Durchlauf, jeder Log-Dump und jedes „Ich checke noch eine Datei“ bleibt für immer im Hauptchatverlauf stehen.

Specs, Tests und Code in der KI-Entwicklung synchron halten

Specs, Tests und Code in der KI-Entwicklung synchron halten

Verhindern Sie, dass KI-Agenten von den Spezifikationen, Tests und dem Code abweichen.

KI-Coding-Agenten liefern Features schnell, aber Spezifikationen, Tests und Code veralten stillschweigend und gehen auseinander. Dieser Leitfaden behandelt ein Nachverfolgungsmodell (Traceability), die Zuordnung von Spezifikation zu Test und von Spezifikation zu Code sowie die CI-Prüfungen, die Abweichungen vor einem Merge erkennen.

GitHub Spec Kit vs. Kiro vs. Claude-Code-SDD-Workflows

GitHub Spec Kit vs. Kiro vs. Claude-Code-SDD-Workflows

Prozessiefe gegenüber Portabilität, nicht das beste Tool.

Entwickler, die sich im Jahr 2026 mit verschiedenen Spec-Driven-Development-Setups (SDD) vertraut machen, fragen in der Regel nicht danach, welches KI-Modell am intelligentsten ist. Sie fragen sich, welcher Workflow einen KI-Agenten ausgerichtet halten wird, ohne sie unter einer Flut an Formalitäten zu begraben.

Spekulatives Dekodieren: 20–50 % schnellere LLM-Inferenz

Spekulatives Dekodieren: 20–50 % schnellere LLM-Inferenz

Schnellere LLM-Inferenz ohne Qualitätsverlust – Ein praktischer Leitfaden

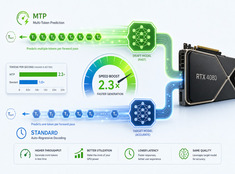
Ein 70B-Modell erzeugt pro Vorwärtsdurchlauf ein einzelnes Token, wobei jeder Durchlauf Gewichte aus dem VRAM neu lädt, die Aufmerksamkeit über den gesamten Kontext berechnet und den Speicher synchronisiert. Zwischen den Tokens verbringt die GPU Zeit im Leerlauf, während sie darauf wartet, dass sequenzielle Abhängigkeiten aufgelöst werden.

Muster zur Orchestrierung mehrerer Agenten: Ein praktischer Leitfaden

Muster zur Orchestrierung mehrerer Agenten: Ein praktischer Leitfaden

40 % der Multi-Agent-Piloten scheitern. So wählen Sie das richtige Orchestrierungs­muster aus und vermeiden die, die versagen.

Einzelagenten-basierte KI-Systeme erreichten 2025 ihren Höhepunkt — man übertrug einem LLM einen Prompt, einige Tools und ein Ziel, und es erledigte abgegrenzte Aufgaben reasonably gut.