LLM Performance

Die effiziente Frontiere offener Modelle: Den Sweet Spot für 2026 finden

Die effiziente Frontiere offener Modelle: Den Sweet Spot für 2026 finden

Der ideale Bereich für offene LLMs im Jahr 2026: rund 30 Mrd. Parameter.

Im September 2026 liegt die effiziente Frontier der offenen Modelle zwischen 25 Milliarden und 34 Milliarden Parametern: nahezu Frontier-nahes Agenten-Work auf einer einzigen 24-GB-GPU, mit einem Bruchteil der Hardware von 70B-Klasse.
KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

Warum 128K Kontext auf 16 GB scheitert

Ein Modell kann einen 128K-Kontextfenster bewerben und trotzdem bei 40K Tokens auf einer 16-GB-GPU scheitern. Die architektonische Obergrenze hat nie versprochen, dass Modellgewichte, KV-Cache, Rechenspeicher und der Desktop-Compositor gleichzeitig auf Ihrer Grafikkarte Platz finden würden.

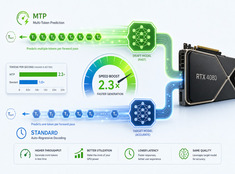
Spekulatives Dekodieren: 20–50 % schnellere LLM-Inferenz

Spekulatives Dekodieren: 20–50 % schnellere LLM-Inferenz

Schnellere LLM-Inferenz ohne Qualitätsverlust – Ein praktischer Leitfaden

Ein 70B-Modell erzeugt pro Vorwärtsdurchlauf ein einzelnes Token, wobei jeder Durchlauf Gewichte aus dem VRAM neu lädt, die Aufmerksamkeit über den gesamten Kontext berechnet und den Speicher synchronisiert. Zwischen den Tokens verbringt die GPU Zeit im Leerlauf, während sie darauf wartet, dass sequenzielle Abhängigkeiten aufgelöst werden.

Strukturierte Ausgabevalidierung von LLMs in Python, die standhält

Strukturierte Ausgabevalidierung von LLMs in Python, die standhält

Hören Sie auf, auf Vibes zu vertrauen. Validieren Sie Verträge.

Die meisten Tutorials zu „strukturierten Ausgaben“ von LLMs sind wenig ernst gemeint. Sie lehren Sie, höflich um JSON zu bitten und darauf zu hoffen, dass das Modell sich entsprechend verhält. Das ist keine Validierung. Das ist Optimismus mit geschweiften Klammern.

BAML vs. Instructor: Strukturierte LLM-Ausgaben

BAML vs. Instructor: Strukturierte LLM-Ausgaben

Typsichere LLM-Ausgaben mit BAML und Instructor

Bei der Arbeit mit Large Language Models (LLMs) in der Produktion ist es entscheidend, strukturierte und typsichere Outputs zu erhalten. Zwei beliebte Frameworks – BAML und Instructor – verfolgen unterschiedliche Ansätze, um dieses Problem zu lösen.

LLM-ASICs und spezielle Inferenz-Chips (warum sie wichtig sind)

LLM-ASICs und spezielle Inferenz-Chips (warum sie wichtig sind)

ASICs und maßgeschneiderte Silizium-Chips erhöhen Geschwindigkeit und Effizienz der LLM-Inferenz

Die Zukunft der KI dreht sich nicht nur um intelligenter werdende Modelle. Sie bezieht sich auch auf Silizium-Verarbeitung, die genau dazu passt, wie diese Modelle tatsächlich bereitgestellt werden. Spezialisierte Hardware für LLM-Inferenz folgt dabei einem Weg, der an den Übergang des Bitcoin-Mining von GPUs zu speziell dafür entwickelten ASICs erinnert – allerdings mit strengeren Einschränkungen, da sich Modelle und Präzisionsverfahren ständig weiterentwickeln.