
Modelle Routing: Hör auf, ein einzelnes Modell für alles zu verwenden
Das richtige Modell für die richtige Aufgabe.
Ein Modell mit 70 Milliarden Parametern für die Zusammenfassung einer 200-Wörter-E-Mail einzusetzen, ist verschwenderisch. Ein 3-Milliarden-Modell zur Überprüfung von Produktionscode einzusetzen, ist fahrlässig. Die meisten Systeme bewegen sich irgendwo dazwischen – und genau hier setzt Modell-Routing an.
Es passt die Aufgabenkomplexität der Modellkapazität an. Die Kompromisse sind real, aber auch die Ersparnisse.
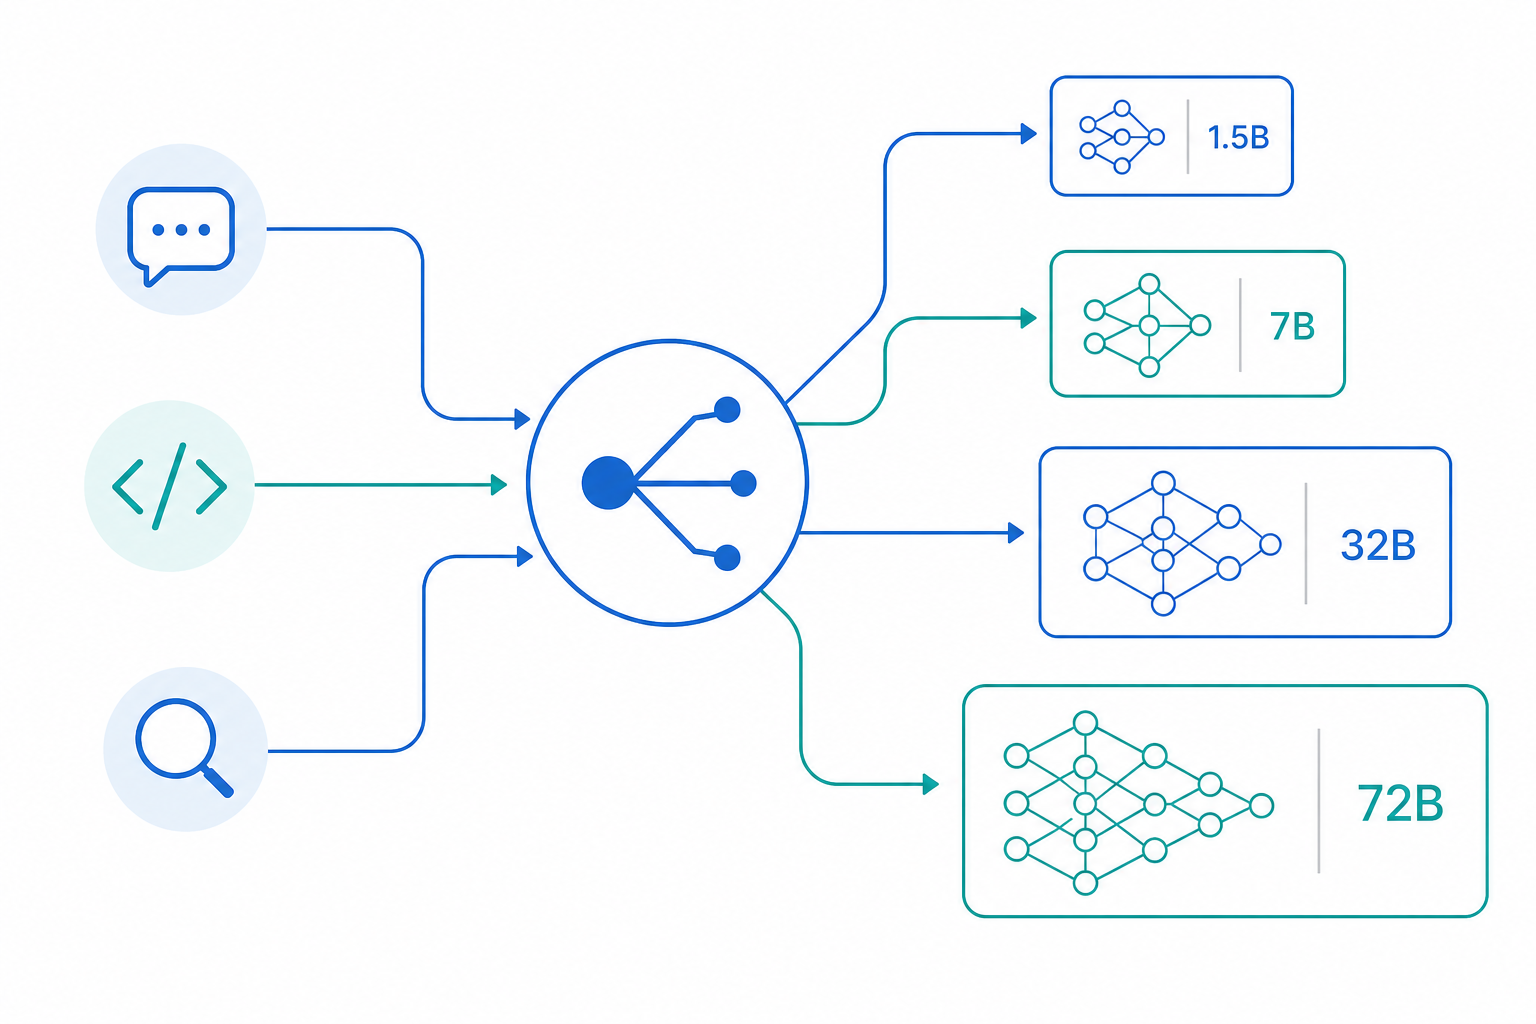
Das Routing-Problem
Anwender beginnen in der Regel mit einem einzigen Modell und bleiben dabei. Das funktioniert, bis man die Kosten oder die Latenz bemerkt, oder beides. Die Alternative ist der Aufbau eines Routers – etwas, das entscheidet, welches Modell welche Anfrage bearbeitet.
In der Praxis funktionieren vier Strategien:
- Fähigkeitsbasiert – Routen anhand dessen, was das Modell kann
- Kostenbewusst – Routen anhand dessen, was man ausgeben will
- Latenzbewusst – Routen anhand der benötigten Geschwindigkeit
- Hybrid – Kombination all dieser Ansätze
Jede Strategie optimiert etwas anderes. Die Wahl einer bestimmten Option ist in der Regel eine Entscheidung darüber, was am meisten schmerzt.
Fähigkeitsbasiertes Routing
Der einfachste Ansatz. Die Aufgabe wird klassifiziert und dem Modell zugeordnet, das sie bearbeiten kann.
| Aufgabe | Modellgröße | Beispiele |
|---|---|---|
| Klassifizierung, Tagging | 1–3B | Qwen3-1.7B, Gemma-2-2B |
| Zusammenfassung, Extraktion | 3–7B | Qwen3-8B, Llama-3.1-8B |
| Code-Generierung | 7–14B | Qwen2.5-Coder-7B, DeepSeek-Coder-V2 |
| Komplexes Schließen | 14–32B | Qwen3-32B, Llama-3.1-70B |
| Kreatives Schreiben, Analyse | 32B+ | Qwen2.5-72B, Claude, GPT-4 |
Wenn die Aufgabe das größere Modell nicht benötigt, sollte es auch nicht verwendet werden. Ein 1,5B-Modell kann die Sentiment-Klassifizierung problemlos bewältigen. Es wird lediglich keinen kohärenten Aufsatz schreiben.
Die Implementierung ist unkompliziert:
ROUTING_RULES = {
    "classify": {"model": "qwen3-1.7B", "max_tokens": 100},
    "summarize": {"model": "qwen3-8B", "max_tokens": 500},
    "code_review": {"model": "qwen2.5-coder-7b", "max_tokens": 2000},
    "reason": {"model": "qwen3-32b", "max_tokens": 4000},
    "creative": {"model": "claude-sonnet-4", "max_tokens": 8000},
}

def route_request(task_type: str) -> dict:
    return ROUTING_RULES.get(task_type, ROUTING_RULES["reason"])
Der Haken ist die Klassifizierung selbst. Fehlt man bei der Art der Aufgabe, wird auf das falsche Modell geroutet. Ich habe Systeme erlebt, die eine Code-Überprüfung als „Zusammenfassung“ klassifizierten und dabei stillschweigend Qualität verloren.
Kostenbewusstes Routing
Lokale Inferenz spielt hier ihre Stärke aus. Lokale Modelle sind nach der Amortisierung der Hardware praktisch kostenlos. Eine RTX 5080 amortisiert sich bei mäßigem API-Nutzungsgrad in etwa sechs Monaten.
| Modell | Input ($/M Token) | Output ($/M Token) | Lokale Kosten/Stunde |
|---|---|---|---|
| GPT-4o | 2,50 $ | 10,00 $ | — |
| Claude Sonnet 4 | 3,00 $ | 15,00 $ | — |
| Qwen2.5-72B (API) | 0,50 $ | 2,00 $ | — |
| Qwen3-32B (lokal) | 0,00 $ | 0,00 $ | ~0,10 $ |
| Qwen3-8B (lokal) | 0,00 $ | 0,00 $ | ~0,05 $ |
Wer Tausende von Anfragen pro Sitzung verarbeitet, für den schlägt selbst 0,05 $ Stromkosten die 15 $/M Token.
Budgetbasiertes Routing wechselt ab, je nachdem, wie viel ausgegeben wird:
class CostAwareRouter:
    def __init__(self, budget_per_session: float = 0.10):
        self.budget = budget_per_session
        self.spent = 0.0
        self.models = {
            "cheap": {"model": "qwen3-8B", "cost": 0.0},
            "medium": {"model": "qwen3-32b", "cost": 0.0},
            "expensive": {"model": "claude-sonnet-4", "cost": 0.000015},
        }

    def route(self, task: str) -> str:
        ratio = self.spent / self.budget
        if ratio < 0.5:
            return self.models["expensive"]["model"]
        elif ratio < 0.8:
            return self.models["medium"]["model"]
        return self.models["cheap"]["model"]
Die Qualität verschlechtert sich, wenn auf günstigere Modelle zurückgegriffen wird. Man beginnt mit Claude, wechselt zu Qwen3-32B und dann zu Qwen3-8B. Am Ende einer langen Sitzung ist die Ausgabe deutlich schlechter. Ob das relevant ist, hängt davon ab, was man aufbaut.
Den routinierten Datenverkehr an ein lokales Modell zu leiten und die API für Sonderfälle vorzubehalten, hat neben der Kostenersparnis einen weiteren Nebenvorteil: Es hält davon ab, in die Art von Daten-Schwere zu geraten, bei der jeder Fine-Tune und jede Eval-Harness um die API eines einzelnen Anbieters herum gestaltet wird.
Latenzbewusstes Routing
Interaktive Tools benötigen schnelle erste Token. Batch-Jobs können warten. Der Unterschied liegt in der Regel in einem Faktor von fünf bei der Modellgröße.
| Anwendungsfall | Erster Token | Komplett | Max. Modellgröße |
|---|---|---|---|
| Echtzeit-Chat | < 200 ms | < 2 s | < 7B |
| Interaktive Tools | < 500 ms | < 5 s | < 14B |
| Batch-Verarbeitung | < 1 s | < 30 s | Beliebig |
| Recherche/Analyse | < 2 s | < 60 s | Beliebig |
Wenn Token an einen Benutzer gestreamt werden, ist die Latenz des ersten Tokens das, was dieser spürt. Ein 32B-Modell, das eine halbe Sekunde zum Start braucht, wirkt schleppend im Vergleich zu einem 1,5B-Modell, das sofort loslegt.
class LatencyAwareRouter:
    def __init__(self):
        self.model_latencies = {
            "qwen3-1.7b": {"first_token": 0.05, "complete": 0.5},
            "qwen3-8B": {"first_token": 0.15, "complete": 2.0},
            "qwen3-32b": {"first_token": 0.5, "complete": 10.0},
            "claude-sonnet-4": {"first_token": 0.3, "complete": 5.0},
        }

    def route(self, target_latency: float) -> str:
        for model, latencies in sorted(
            self.model_latencies.items(),
            key=lambda x: x[1]["complete"]
        ):
            if latencies["complete"] <= target_latency:
                return model
        return "qwen3-1.7b"
Die Latenzzahlen sind ungenau – sie hängen von der eigenen Hardware, der Quantisierung und der Batch-Größe ab. Messen Sie an der eigenen Einrichtung.
Fallback-Strategien
Modelle versagen. APIs begrenzen die Anfragelimit. Timeouts passieren. Das Muster, das funktioniert, ist eine Fallback-Kette, geordnet vom besten zum zuverlässigsten:
class FallbackRouter:
    def __init__(self):
        self.fallback_chain = [
            {"model": "claude-sonnet-4", "timeout": 30},
            {"model": "qwen2.5-72b", "timeout": 60},
            {"model": "qwen3-32b", "timeout": 120},
            {"model": "qwen3-8b", "timeout": 300},
        ]

    def route_with_fallback(self, prompt: str) -> str:
        for config in self.fallback_chain:
            try:
                return self.call_model(
                    config["model"], prompt,
                    timeout=config["timeout"]
                )
            except (TimeoutError, APIError) as e:
                log.warning(f"Model {config['model']} failed: {e}")
                continue
        raise RuntimeError("All fallback models failed")
Das letzte Modell in der Kette sollte lokal sein. Es ist langsamer, wird aber nicht wegen eines Netzwerkproblems oder eines API-Schlüssels versagen.
Wann Routing sinnvoll ist
Routing macht Sinn, wenn die Arbeitslast gemischt ist. Wenn in einem System Klassifizierung, Zusammenfassung und Schließen durchgeführt werden, spart ein Router Geld und Latenz.
Es macht keinen Sinn, wenn alles, was getan wird, die gleiche Komplexität aufweist. Verwenden Sie einfach das Modell, das gut in dieser Aufgabe ist. Der Router fügt Komplexität hinzu, die nicht benötigt wird.
Frühe Prototypentwicklung ist ein weiterer Grund, es zu vermeiden. Bringen Sie die Aufgabe zunächst mit einem Modell zum Laufen und fügen Sie Routing hinzu, wenn Kosten oder Latenz tatsächlich zu einem Problem werden.
Kompromisse
Jede Routing-Strategie optimiert etwas und opfert etwas anderes:
- Einzelnes Modell – am einfachsten, am teuersten, gleichbleibende Qualität
- Fähigkeitsbasiert – bessere Kosten, höhere Qualität pro Aufgabe, moderate Komplexität
- Kostenbewusst – am günstigsten, Qualität variiert, moderate Komplexität
- Latenzbewusst – am schnellsten, kann Qualität opfern, moderate Komplexität
- Hybrid – das Beste von allem, am komplexesten in der Implementierung
Produktionsysteme konvergieren in der Regel auf Hybrid. Beginnen Sie mit fähigkeitsbasiertem Routing, fügen Sie Kostenbewusstsein hinzu, wenn die Rechnung eingeht, und fügen Sie Latenzbewusstsein hinzu, wenn Benutzer sich über Langsamkeit beschweren.
Verwandt
- Kostenoptimierung für LLM-Systeme – Token-Budgetierung, Caching, Fallback-Modelle
- LLM-Guardrails in der Praxis – Eingabevalidierung, Ausgabefilterung, Sicherheit
- Multi-Modell-Systemdesign – Architektur für mehrere Modelle
- Entscheidungs-LLMs: Wann ein Modell entscheiden sollte – und wann nicht – die Taxonomie der Entscheidungsrollen hinter der Ebenenwahl, mit konfidenzbasierter Eskalation
- LLM-Architektur – Säule der Systemdesigns: Routing, Kosten, Guardrails und Orchestrierung
