
Systemdesign mehrerer Modelle: Wenn ein Modell nicht ausreicht
Wählen Sie das einfachste Muster, das funktioniert.
Einzelsystemen mit einem einzigen Modell sind einfach. Mehrfachmodell-Systeme sind leistungsstark. Die Herausforderung besteht nicht darin, Modelle auszuwählen, sondern darin, die Architektur zu gestalten, die sie orchestriert.
Ein Mehrfachmodell-System geht es nicht darum, mehr Modelle zu haben. Es geht darum, das richtige Modell für die richtige Aufgabe zum richtigen Zeitpunkt einzusetzen.
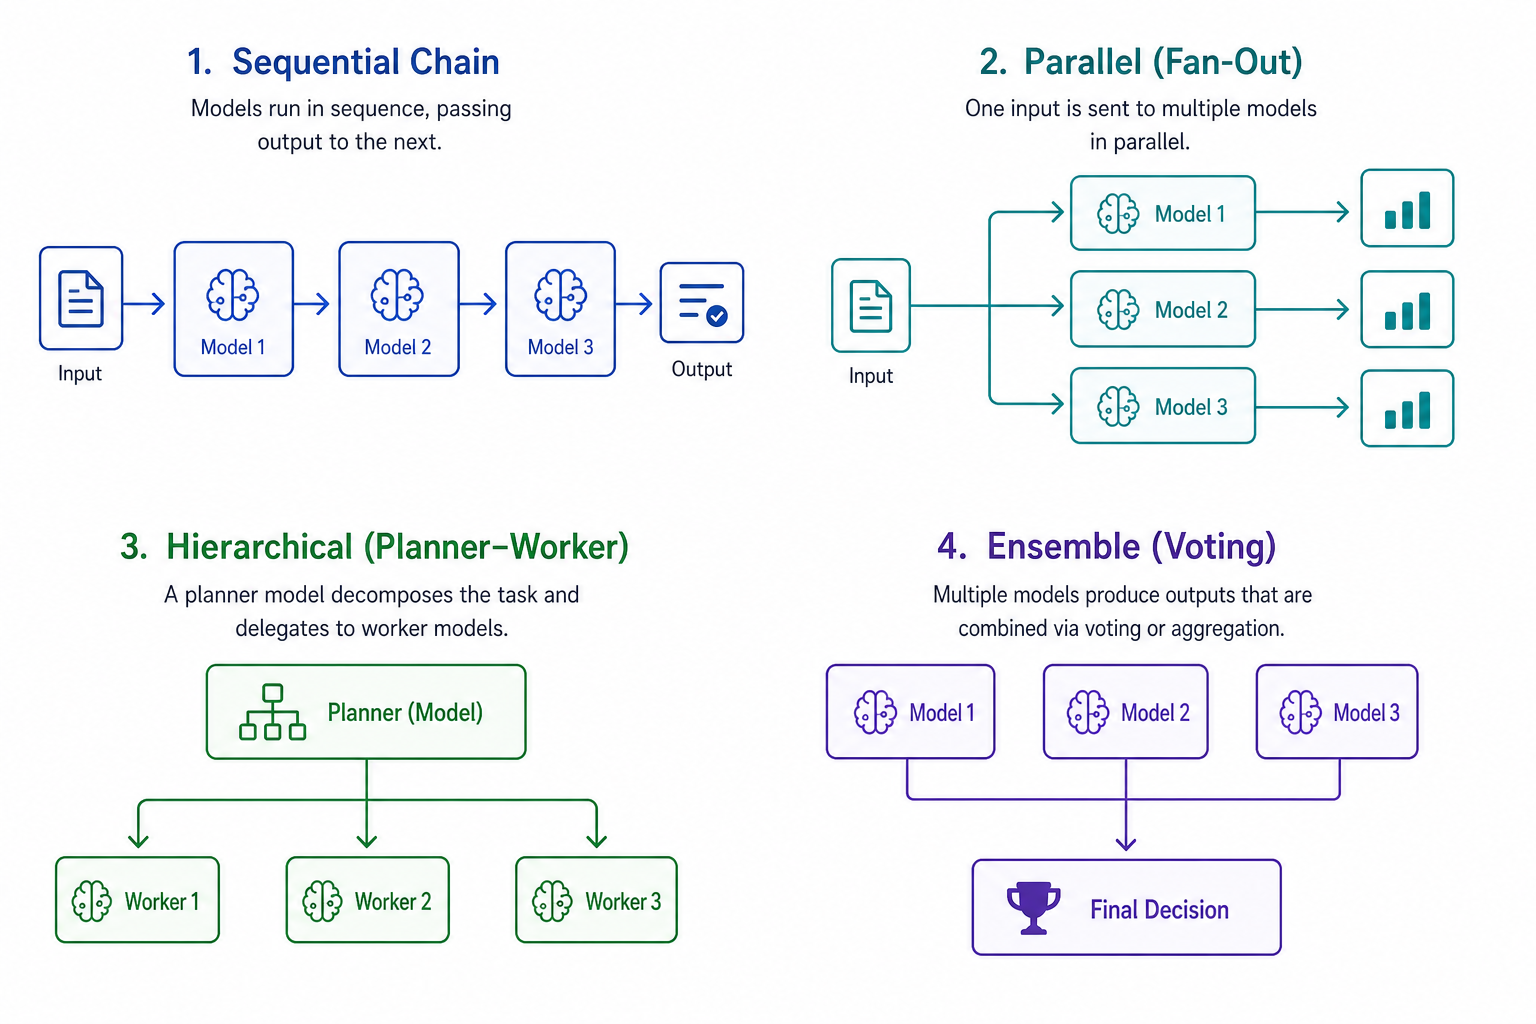
Architekturmuster
Fünf Muster decken die meisten Anwendungsfälle ab:
| Muster | Komplexität | Wann einsetzen | Kompromiss |
|---|---|---|---|
| Einzeln Modell | Niedrigste | Prototyping, einfache Aufgaben | Begrenzte Leistungsfähigkeit |
| Sequenziell | Niedrig | Mehrstufige Workflows | Höhere Latenz |
| Parallell | Mittel | Unabhängige Aufgaben | Höhere Kosten |
| Hierarchisch | Hoch | Komplexes Schließen | Komplexes Orchestrieren |
| Ensemble | Am höchsten | Kritische Entscheidungen | Höchste Kosten |
Wählen Sie das einfachste Muster, das funktioniert. Komplexität ist real, und sie summierst sich.
Sequenzielle Architektur
Verarbeiten Sie Aufgaben durch eine Kette von Modellen, die jeweils in einem Schritt spezialisiert sind.
Muster 1: Pipeline
Pipelinemuster – die Ausgabe eines jeden Modells fließt in das nächste:
class ModelPipeline:
    def __init__(self):
        self.models = [
            {"model": "qwen3-1.7b", "task": "classify"},
            {"model": "qwen3-8b", "task": "extract"},
            {"model": "qwen3-32b", "task": "reason"},
        ]

    def process(self, input: str) -> str:
        current = input
        for model_config in self.models:
            current = self.call_model(
                model_config["model"],
                self.create_prompt(model_config["task"], current)
            )
        return current
Die Latenz summiert sich. Drei Modelle in Sequenz bedeuten die dreifache Latenz. Verwenden Sie dies nur, wenn jeder Schritt tatsächlich ein anderes Modell benötigt.
Muster 2: Router
Routermuster – klassifizieren Sie die Aufgabe und leiten Sie sie an den Spezialisten weiter:
class ModelRouter:
    def __init__(self):
        self.classifier = "qwen3-1.7b"
        self.specialists = {
            "code": "qwen2.5-coder-7b",
            "math": "qwen3-32b",
            "creative": "claude-sonnet-4",
            "general": "qwen3-8b",
        }

    def route(self, prompt: str) -> str:
        task_type = self.classify(prompt)
        model = self.specialists.get(task_type, self.specialists["general"])
        return self.call_model(model, prompt)
Der Klassifizierer ist der schwache Punkt. Wenn er falsch klassifiziert, leiten Sie an das falsche Modell weiter und verlieren Qualität. Verwenden Sie einen Klassifizierer, der gut genug ist – selbst ein kleiner funktioniert, wenn die Kategorien klar sind.
Parallele Architektur
Verarbeiten Sie unabhängige Aufgaben gleichzeitig.
Muster 1: Fan-Out
Fan-out – führen Sie denselben Prompt durch mehrere Modelle:
import asyncio

class ModelFanOut:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    async def process(self, prompt: str) -> list[str]:
        tasks = [self.call_model(model, prompt) for model in self.models]
        return await asyncio.gather(*tasks)
Nützlich für Vergleiche, A/B-Tests oder wenn Sie die beste Ausgabe auswählen möchten. Teuer, aber der Qualitätsgewinn ist bei kritischen Entscheidungen es wert.
Muster 2: Voting
Voting – kombinieren Sie Ausgaben durch Konsens:
class ModelVoting:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    def vote(self, prompt: str) -> str:
        responses = [self.call_model(model, prompt) for model in self.models]
        from collections import Counter
        votes = Counter(responses)
        return votes.most_common(1)[0][0]
Mehrheitenvoting funktioniert für die Klassifizierung. Für generative Aufgaben ist es schwieriger – Sie benötigen semantische Ähnlichkeit, keine exakten Übereinstimmungen.
Hierarchische Architektur
Verwenden Sie Modelle auf verschiedenen Abstraktionsebenen.
Muster 1: Planner-Executor
Planner-Executor – ein starkes Modell plant, kleinere Modelle führen aus:
class PlannerExecutor:
    def __init__(self):
        self.planner = "qwen3-32b"
        self.executors = {
            "code": "qwen2.5-coder-7b",
            "search": "qwen3-8b",
            "math": "qwen3-8b",
        }

    def process(self, task: str) -> str:
        plan = self.call_model(self.planner, f"Plan: {task}")
        results = []
        for step in self.parse_plan(plan):
            executor = self.executors.get(step["type"], "qwen3-8b")
            result = self.call_model(executor, step["prompt"])
            results.append(result)
        return self.call_model(self.planner, f"Synthesize: {results}")
Der Planner trägt die Hauptlast. Die Executores erledigen spezifische Aufgaben. Dieses Muster funktioniert gut, wenn der Planungsschritt teuer, die Ausführungsschritte aber günstig sind.
Muster 2: Supervisor-Worker
Supervisor-Worker – ein Supervisor delegiert und prüft:
class SupervisorWorker:
    def __init__(self):
        self.supervisor = "qwen3-32b"
        self.workers = ["qwen3-8b", "qwen2.5-coder-7b"]

    def process(self, task: str) -> str:
        assignments = self.call_model(self.supervisor, f"Assign: {task}")
        results = []
        for assignment in self.parse_assignments(assignments):
            result = self.call_model(
                assignment["worker"], assignment["task"]
            )
            results.append(result)
        return self.call_model(self.supervisor, f"Review: {results}")
Der Supervisor ist der Flaschenhals. Er plant, delegiert und prüft. Stellen Sie sicher, dass er schnell genug ist, oder das gesamte System wird verlangsamt.
Ensemble-Architektur
Kombinieren Sie mehrere Modelle für kritische Entscheidungen.
Muster 1: Gewichtetes Ensemble
Gewichtetes Ensemble – bewerten Sie die Ausgabe jedes Modells und wählen Sie die höchste aus:
class WeightedEnsemble:
    def __init__(self):
        self.models = {
            "qwen3-32b": 0.5,
            "claude-sonnet-4": 0.3,
            "qwen3-8b": 0.2,
        }

    def decide(self, prompt: str) -> str:
        responses = {
            model: self.call_model(model, prompt)
            for model in self.models
        }
        scores = {}
        for model, response in responses.items():
            score = self.evaluate(response) * self.models[model]
            scores[response] = scores.get(response, 0) + score
        return max(scores, key=scores.get)
Die Gewichte spiegeln Ihr Vertrauen in jedes Modell wider. Passen Sie sie basierend auf der tatsächlichen Leistung an, nicht auf Benchmarks.
Muster 2: Konsens-Ensemble
Konsens-Ensemble – erfordern Sie Übereinstimmung, skalieren Sie bei keiner Eskalation:
class ConsensusEnsemble:
    def __init__(self, threshold: float = 0.7):
        self.threshold = threshold
        self.models = [
            "qwen3-32b",
            "claude-sonnet-4",
            "qwen3-8b",
        ]

    def decide(self, prompt: str) -> str:
        responses = [
            self.call_model(model, prompt)
            for model in self.models
        ]
        from collections import Counter
        votes = Counter(responses)
        max_votes = max(votes.values())

        if max_votes / len(self.models) >= self.threshold:
            return votes.most_common(1)[0][0]

        return self.call_model("qwen3-32b", prompt)
Der Schwellenwert steuert, wie streng der Konsens ist. 0,7 bedeutet eine Zweidrittel-Mehrheit. Senken Sie ihn für schnellere Entscheidungen, erhöhen Sie ihn für höheres Vertrauen.
Wann Mehrfachmodell-Systeme sinnvoll sind
Mehrfachmodell-Systeme machen Sinn, wenn Sie gemischte Workloads haben, für kritische Entscheidungen eine hohe Qualität benötigen oder auf Kosten oder Latenz optimieren.
Sie machen keinen Sinn, wenn alle Aufgaben eine ähnliche Komplexität haben, Sie im Prototyping sind oder Einfachheit wichtiger ist als Optimierung.
Die Faustregel: Beginnen Sie mit einem Modell. Fügen Sie weitere hinzu, wenn Sie auf eine echte Einschränkung stoßen – Kosten, Latenz oder Qualität. Gestalten Sie keine Komplexität, bevor Sie sie benötigen.
Kompromisse
| Muster | Kosten | Latenz | Qualität | Komplexität |
|---|---|---|---|---|
| Einzeln Modell | Niedrigste | Niedrigste | Variabel | Niedrigste |
| Sequenziell | Mittel | Hoch | Hoch | Mittel |
| Parallell | Hoch | Niedrig | Hoch | Mittel |
| Hierarchisch | Hoch | Hoch | Am höchsten | Hoch |
| Ensemble | Am höchsten | Mittel | Am höchsten | Am höchsten |
Jedes Muster handelt etwas ein. Wählen Sie dasjenige, das Ihren Einschränkungen entspricht.
Verwandt
- Modell-Routierungsstrategien – leistungsbasierte, kostenbewusste, latenzbewusste Routierung
- Kostenoptimierung für LLM-Systeme – Token-Budgetierung, Fallback-Modelle, Caching
- LLM-Wächter in der Praxis – Eingabegültigkeit, Ausgabe-Filterung, Sicherheit
- Entscheidungs-LLMs: Wann ein Modell entscheiden sollte – und wann nicht – welche Entscheidungen ein Modell in einer Orchestrierung treffen darf und wie man sie verifiziert
- LLM-Architektur – Systemdesign-Pfeiler: Routierung, Kosten, Wächter und Orchestrierung
- Mehr-Agenten-Orchestrierungsmuster – unterscheidet sich von der Mehr-Modell-Routierung: dies behandelt, wie mehrere autonome Agenten koordinieren, nicht wie Aufgaben zwischen Modellen geroutet werden
