
Rückblick auf Hermes Agent: Selbst gehostetes Gedächtnis mit lokalen LLMs
Permanenter Hermes-Speicher auf Ihrer eigenen Hardware.
Ein selbst gehosteter KI-Agent benötigt mehr als nur ein langes Kontextfenster. Er braucht einen Weg, nützliche Fakten zu bewahren, frühere Entscheidungen abzurufen und seine Überbestände zu revidieren, während Projekte sich weiterentwickeln.
Hermes Agent wird mit eingebauten Speicherdateien ausgeliefert, aber ein externer Anbieter kann eine viel reicher vernetzte Abfrage über verschiedene Sitzungen hinweg bereitstellen. Hindsight ist eine der interessantesten Optionen in diesem Bereich. Diese Anleitung installiert es für Hermes ohne Cloud-Inferenz, zunächst als alle-in-einem-Docker-Container und dann gegenüber einem vorhandenen PostgreSQL-Server mit separaten lokalen Modellen Endpunkten.
Die Anleitung deckt die Bereitstellung, die Auswahl und Verkabelung lokaler Embedding-, Reranking- und generativer Modelle, die Kontrolle ab, was „Auto-Retain“ in die Bank schreibt, die Verbindung zu Hermes und die operative Ebene: Sicherung, Migration und tägliche Bank-Pflege ab. Die Beispiele verwenden ein bewussten Port-Schema — 8080 für den Haupt-llama.cpp-Server, 8081 für Embeddings, 8082 für Reranking, 11434 für Ollama — ändern Sie diese also in die Ports um, die Sie bereits verwenden, und halten Sie die kleinen Server vom Port des Hauptmodells fern.
Was Hindsight leistet
Hindsight ist eine persistente Agenten-Speicher-Engine mit drei Hauptoperationen: Retain (Bewahren), Recall (Abrufen) und Reflect (Reflektieren). Retain extrahiert und speichert Informationen; Recall kombiniert semantische, stichwortbasierte, grafische und temporale Abfrage; Reflect synthetisiert eine Antwort aus angesammelten Erinnerungen. Hintergrund-Konsolidierung kann überlappende Beobachtungen in eine nützlichere Wissensebene verwandeln.
Es ist nicht einfach nur eine Embeddings-Datenbank. Ein Vektor-Speicher kann ähnliche Passagen lokalisieren, aber ein Speicher-System muss auch Chronologie, Projektgrenzen, widersprüchliche Evidenzen und Änderungen in Entscheidungen bewahren. Diese Fehlerszenarien werden in selbst verstärkende Speicherschleifen untersucht.
Für den breiteren Markt siehe Vergleich von Agenten-Speicher-Anbietern. Hermeas eingebauter MEMORY.md, USER.md und Speicher-Modi werden im Hermes Agent Speicher-System-Leitfaden behandelt, daher geht dieser Artikel davon aus, dass Sie wissen, wie die eingebaute Ebene funktioniert.
Warum man über Mnemosyne hinausgehen sollte
Mnemosyne für Hermes bietet ansprechende lokale Ideen, einschließlich SQLite-Speicher und hybrider Abfrage. In der Praxis können Installationsbeschränkungen, Versionskompatibilität, Schreibgenehmigungsverhalten und schnelle Änderungen um seine 4.0-Vorversionen herum es schwierig machen, es vorhersehbar zu betreiben. Das sind operative Belange, kein Beweis, dass Mnemosynes Speichermodell fundamental fehlerhaft ist.
Hindsight ist auch nicht ohne Abhängigkeiten: sein Docker-Image und lokale Modelle können erheblichen Festplattenspeicher verbrauchen. Die Ausführung seiner API als unabhängiger Dienst, mit Inferenz woanders, hält Upgrades und Fehlerbehebung isoliert vom Agenten selbst.
Eine Bereitstellung wählen
| Komponente | A: Alle-in-einem-Container | B: Vorhandener PostgreSQL-Server |
|---|---|---|
| Hindsight API und UI | Docker-Container | Docker-Container |
| PostgreSQL | Eingebettetes pg0 im Container |
Vorhandener PostgreSQL-Host |
| Generative LLM | Externer llama.cpp | Externer llama.cpp |
| Embeddings | Standard-lokal oder extern | Externer Ollama oder llama.cpp |
| Reranking | Standard-lokal oder extern | Externer Rerank-Server |
| Am besten für | Schnelle Bewertung | Langlaufende, isolierte Installation |
Hier bedeutet „alle-in-einem“, dass Hindsight API, UI und Datenbank in einem Container sind; das Inferenz-LLM wird jedoch weiterhin woanders gehostet. Das ist absichtlich: Das offizielle Hindsight-Docker-Image bündelt keinen sofort einsatzbereiten lokalen generativen llama.cpp-Server.
Verwenden Sie LAN-erreichbare Adressen, nicht localhost, für Dienste, die auf einem anderen Host laufen. Beschränken Sie diese Ports auf vertrauenswürdige Clients; die Beispiel-dummy-Schlüssel sind Kompatibilitätsplatzhalter, keine Authentifizierung.
Option A: Alle-in-einem-Hindsight-Container
Das ist der einfachste Weg, Hindsight zu bewerten, ohne die Hermes-VM mit Python, Torch und lokalen Modell-Abhängigkeiten zu füllen. Der Container führt Hindsight und eingebettetes PostgreSQL, während Ihr Haupt-llama.cpp-LLM die Speicherextraktion und Reflexion übernimmt.
Zwei Image-Tags sind hier wichtig. ghcr.io/vectorize-io/hindsight:latest ist das große Image — ungefähr 9 GB auf AMD64 — weil es einen BGE-Embedder, einen MiniLM-Reranker und eingebettetes PostgreSQL bündelt. latest-slim ist ungefähr 500 MB groß und erwartet, dass diese beiden Modelle woanders liegen, was Sie möchten, sobald Sie Hindsight auf das Embedding- und Reranking-Setup in „Bereitstellen und lokale Modelle verkabeln“ zeigen. Sobald der Health-Check besteht, fixieren Sie ein spezifisches Tag: ein sich bewegendes Tag ist eine schlechte Wahl für eine Datenbank, die Sie behalten möchten.
Erstellen Sie ein Verzeichnis und eine Compose-Datei auf dem Hindsight-Host:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # Memory API
      - "9999:9999"  # Control-plane UI
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Ersetzen Sie WORKSTATION_IP mit dem Host, der llama.cpp ausführt. Auf Linux wird host.docker.internal nur dann aufgelöst, wenn der Container die oben gezeigte host-gateway-Zuordnung deklariert; ohne sie zeigt eine Basis-URL von http://host.docker.internal:8080/v1 nirgendwohin. Die 1-GB-Freigedaten-Speicherreservierung ist besonders nützlich für eingebettete PostgreSQL-Indizes; der kleine Standard-/dev/shm von Docker kann zu Fehlern führen. Ein benannter Volume bewahrt die Datenbank, wenn der Container neu erstellt wird, und eine Bind-Mount-Alternative muss dem uid 1000, dem Benutzer im Image, gehören.
HINDSIGHT_API_WORKER_ID sollte über Neuanlegungen hinweg stabil bleiben — der Docker-Standard ist der Container-Hostname, und eine Aufgabe, die in der Luft hing, als ein Container starb, bleibt unter der alten Worker-ID stecken.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Wenn Ihre installierte Hindsight-Version den Health-Check an einem anderen Pfad aussetzt, inspizieren Sie http://localhost:8888/docs und die Container-Logs. Die Kontrollfläche ist normalerweise unter http://HINDSIGHT_HOST:9999 verfügbar. Sobald die Grundbereitstellung funktioniert, können Sie auch ihre Embedding- und Reranking-Anbieter auf die Konfiguration in „Bereitstellen und lokale Modelle verkabeln“ zeigen, anstatt die Standardmodelle innerhalb des Containers zu laden.
Stellen Sie die Ports 8888 oder 9999 nicht direkt dem Internet aus. Verwenden Sie ein privates Netz oder einen authentifizierten Reverse-Proxy. Eingebettetes PostgreSQL ist für Tests bequem, aber eine extern verwaltete Datenbank ist leichter zu sichern und zu warten.
Option B: Hindsight gegenüber einem vorhandenen PostgreSQL-Server
Für eine langlaufende Installation bevorzuge ich, die Hindsight API, die Datenbank und die Inferenz-Endpunkte getrennt zu halten. Die Hindsight-VM kann klein bleiben, da sie Orchestrierung und HTTP-Dienste ausführt, anstatt schwere Modelle.
PostgreSQL und pgvector vorbereiten
Hindsight benötigt PostgreSQL 14 oder neuer und eine Vektorerweiterung in der hindsight-Datenbank. Die Erweiterung ist pro Datenbank: das Installieren des Pakets auf dem Server tut nichts, bis CREATE EXTENSION dort ausgeführt wird. Auf einem Debian- oder Ubuntu-PostgreSQL-Server installieren Sie das pgvector-Paket, das zur tatsächlichen PostgreSQL-Hauptversion passt; zum Beispiel auf PostgreSQL 16:
sudo apt update
sudo apt install postgresql-16-pgvector
Der Paketname und die Verfügbarkeit hängen von Ihren konfigurierten apt-Repositories ab. Wenn es nicht verfügbar ist, folgen Sie den pgvector-Installationsanweisungen oder installieren Sie ein kompatibles Paket aus dem PostgreSQL PGDG-Repository. Ändern Sie nicht blind die PostgreSQL-Hauptversion auf einem geteilten Server.
Erstellen Sie eine dedizierte Rolle und Datenbank als PostgreSQL-Administrator:
CREATE ROLE hindsight LOGIN PASSWORD 'REPLACE_WITH_LONG_PASSWORD';
CREATE DATABASE hindsight OWNER hindsight;
Verbinden Sie sich mit der neuen Datenbank und aktivieren Sie die Erweiterung:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname = 'vector';"
Die Erweiterung benötigt normalerweise erhöhte Privilegien zur Installation; die Anwendungsrolle muss kein Superuser sein. Hindsight verwendet standardmäßig pgvector und verlangt 0.8.0 oder neuer für iterative ANN-Scans; ältere Server lehnen diese Einstellung ab. HINDSIGHT_API_VECTOR_EXTENSION kann alternativ pgvectorscale (eine DiskANN-Option, die Hindsight für sehr große Banken dokumentiert) oder vchord auswählen, beides benötigt zusätzliche Pakete für diesen exakten PostgreSQL-Build. Das Wechseln der Algorithmen, nachdem Erinnerungen existieren, stoppt den Start und verlangt eine Migration, wählen Sie also vor dem ersten Retain. Für eine persönliche Hermes-Bank ist pgvector das, was Sie installieren und dann vergessen sollten.
Erlauben Sie nur dem Hindsight-Host den Durchgang durch pg_hba.conf, zum Beispiel:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Setzen Sie PostgreSQL listen_addresses entsprechend ein und verwenden Sie TLS oder ein vertrauenswürdiges privates Netz für zwischen-Host-Verbindungen. Sichern Sie diese Datenbank unabhängig vom Hindsight-Docker-Container. Wenn der Server mit anderen Anwendungen geteilt wird, halten Sie Hindsight in seiner eigenen Datenbank, oder setzen Sie HINDSIGHT_API_DATABASE_SCHEMA auf ein Schema, das Sie besitzen; das Standard-Schema ist public.
Hindsight gegen PostgreSQL ausführen
Erstellen Sie compose.yaml auf der Hindsight-VM. Diese Version startet PostgreSQL absichtlich nicht lokal:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Speichern Sie die externe Datenbank-URL in einer Datei namens .env:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:YOUR_PASSWORD@POSTGRES_IP:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Wenn Ihr Passwort @, :, / oder andere reservierte URL-Zeichen enthält, kodieren Sie es in der URL, bevor Sie es in die Verbindungszeichenkette setzen. Testen Sie, dass die Hindsight-VM den PostgreSQL-Port 5432 erreichen kann und dass pg_hba.conf den Hindsight-Host erlaubt — ein Server, der nur an 127.0.0.1 gebunden ist, verweigert die Verbindung, selbst wenn die URL richtig aussieht. Erlauben Sie dem ersten Start, Datenbank-Migrationen auszuführen; Migrationen laufen beim Start, es sei denn, Sie setzen HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Mit API und Datenbank aktiv, fahren Sie mit Modelle für Hindsight wählen und Lokale Modelle bereitstellen und verkabeln fort, bevor Sie Hermes verbinden.
Modelle für Hindsight wählen
Die Bereitstellung stellt API und Datenbank ins Netz. Die nächste Entscheidung ist, welche Modelle die drei Inferenz-Rollen füllen: Embeddings für Recall-Kandidaten, ein Reranker, um sie neu zu ordnen, und ein generatives LLM für Retain, Reflect und Konsolidierung. Ein praktischer Standard für einen CPU-Hindsight-Host, dessen GPU bereits mit Konversation beschäftigt ist, ist in-process Qwen/Qwen3-Embedding-0.6B, in-process BAAI/bge-reranker-v2-m3 und ein geteilter llama.cpp-Chat-Modell für generative Arbeit.
Embedding-Modelle
Hindsight liest die Embedding-Dimension beim Start ein und dimensioniert die Bank entsprechend, also ist das Modell, das Sie beim ersten Retain wählen, das Modell, das die Bank behält, bis Sie sie neu aufbauen. Dimensionalität und Anweisungsverhalten sind wichtiger als Leaderboard-Ränge: ein stärkerer 8B-Embedder ist keine Migration wert, wenn die Bank bereits eine 384- oder 1024-dimensionale ist. Die Zeilen unten sind von leichtesten zu schwersten sortiert; RAM-Zahlen sind angenäherte geladene Fußabdruck auf CPU (FP16 / typische lokale Beladung), nicht GGUF-Dateigröße.
| Modell | Parameter | Dim | Kontext | Geladen | Läuft auf | Anmerkungen |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Hindsight-Standard; in hindsight:latest enthalten. Schnellster lokaler Weg. Die Score-Verteilung kalibriert noch viele recall_min_scores-Standards, nachdem Sie ihn verlassen haben. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | Mittelklasse-Englisch-BGE; sperrt eine 768-dim Bank. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | Hindsight-dokumentierter mehrsprachiger MiniLM; 50+ Sprachen bei gleicher 384-dim-Bank-Breite wie BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | Standard für den onnx-Anbieter; leichter mehrsprachiger CPU-Weg, wenn Sie einen ONNX-Export haben. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | Häufiger Ollama-Embedder; längerer Kontext als klassisches BGE, immer noch Englisch-zentriert. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 nur Text (Vision/Audio-Türme deaktivieren). 100+ Sprachen + Code; MRL trunciert zu 512/256/128; Anweisungspräfixe für Suche vs. Dokument. Volle Multimodal-Beladung ist 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPU oder GPU | Starker mehrsprachiger Dual-Encoder; gleiche Breite wie Qwen3-0.6B, also braucht ein gleich-dimensionaler Tausch immer noch ein vollständiges Re-Embedding. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | Standard dieses Leitfadens. Anweisungs-bewusst (Suchanweisung auf der Query-Seite); bequem auf CPU. Lokaler Anbieter wendet die Anweisung automatisch an; OpenAI-kompatible Server benötigen HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB quant | GPU | Qwen3-Qualitätsstufe; sperrt eine 2560-dim Bank. Nicht machbar, wenn die konversationelle GPU bereits gesättigt ist. |
Wie das Modell ausgeführt wird, ist die andere Hälfte der Wahl. Hindsights Embedding-Anbieter, vom einfachsten zu den meisten beweglichen Teilen:
| Anbieter | Wie es läuft | Am besten, wenn | Anmerkungen |
|---|---|---|---|
local |
In-process SentenceTransformers; kein Sidecar | Einzelner Hindsight-Host, CPU-Embedder | Standardweg. Setzen Sie HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Kein llama.cpp, Ollama oder TEI. |
onnx |
In-process ONNX Runtime | Leichter als Torch auf CPU; Sie haben bereits einen ONNX-Export | Benötigt hindsight-api-slim[local-onnx] und HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Externer OpenAI-kompatibler oder HF TEI Endpunkt | Embeddings weg vom API-Prozess; geteilter GPU/CPU-Host | Was „Lokale Modelle bereitstellen und verkabeln“ für Ollama / llama.cpp / TEI konfiguriert. Nur wert den Sidecar, wenn Sie Isolation oder einen anderen Host wollen. |
Qwen3-Embedding-0.6B benötigt keinen externen Embedding-Dienst. Auf einem CPU-Hindsight-Host lädt es innerhalb des API-Prozesses mit dem local-Anbieter — Hugging Face lädt die Gewichte beim ersten Start herunter, und der Anbieter wendet die Suchanweisung des Modells selbst an:
# Compose environment (or equivalent .env keys)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Verwenden Sie einen externen OpenAI-kompatiblen Endpunkt nur, wenn Sie den Embedder auf einem anderen Host oder weg vom API-Prozess wollen. Ollama ist ein solcher Host:
# Embeddings: Qwen3-Embedding-0.6B on Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Ersetzen Sie Host, Port und Tag mit dem, was ollama list auf Ihrem Inferenz-Host zeigt.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX hängt vom Anbieter ab:
| Pfad | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Leer lassen / leer — der in-process-Anbieter wendet Qwens Suchanweisung selbst an | Leer lassen / leer |
| Externer Ollama / llama.cpp / OpenAI-kompatibel | Offizielle Qwen3-Retrieval-Anweisung (echter Zeilenumbruch vor Query:) |
Leer lassen — gespeicherte Erinnerungen bleiben roher Text |
| Server kapselt Eingaben bereits in Qwens Vorlage | Beide leer lassen — sonst wird die Anweisung doppelt angewendet | Leer lassen |
Für den externen Pfad setzen Sie:
# Real newline before Query:. Bash $'...' is the reliable way to pass it.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
In Compose YAML benötigt derselbe String einen expliziten \n (oder einen wörtlichen Multi-Zeilen-Wert). Setzen Sie die Präfixe vor dem ersten Retain: spätere Änderungen bedeuten, dass alte Vektoren und neue Queries nicht länger im selben Raum sitzen.
Zwei Eigenschaften entscheiden mehr als die Leaderboard-Position. Anweisungs-Empfindlichkeit: Qwen3-Embeddings wenden eine Suchanweisung auf der Query-Seite an; ohne das passende Präfix auf einem OpenAI-kompatiblen Server hören die gespeicherte Seite und die Query-Seite auf, im selben Raum zu sitzen. Dimensions-Sperre: weil die Breite einmal beim Start gelesen wird, ist ein Wechsel von 0.6B auf 4B später eine Bank-Migration, keine Konfigurationsänderung — und sogar ein gleich-dimensionaler Tausch (BGE-M3 ↔ Qwen3-0.6B, oder EmbeddingGemma 2 ↔ nomic bei 768) ändert den Vektorraum, also werden Bank-Vektoren nicht automatisch neu berechnet. Planen Sie eine neue Bank oder ein manuelles Re-Embedding/Re-Indexieren; siehe Exportieren, Importieren und Migrieren der Speicherbank. Nach dem Verlassen von BGE-small, prüfen Sie recall_min_scores gegen die neue Score-Verteilung — Schwellenwerte, die auf BGE-small kalibriert wurden, können für Qwen3-0.6B zu eng sein und den Reranker um Kandidaten bringen. Für Benchmarks und GGUF/Ollama-Hintergrund zur Qwen3-Familie, siehe Qwen3 Embedding und Reranker Modelle auf Ollama.
Reranking-Modelle
Embeddings rufen einen Kandidatensatz ab; der Reranker bewertet jedes Query/Passage-Paar und ordnet es neu, bevor Hindsight es injiziert. Mit dem local-Anbieter lädt Hindsight einen SentenceTransformers-Cross-Encoder (oder einen generativen Reranker, wo unterstützt). Mit einem externen Cohere-kompatiblen Endpunkt postet es den vollen Cohere-Style-Körper an HINDSIGHT_API_RERANKER_COHERE_BASE_URL. Der Reranker ist optional, aber sobald der Embedder festgelegt ist, ist er normalerweise der größte Recall-Qualitäts-Hebel — und auf CPU oft der größte Teil der Recall-Wand-Uhr. Zeilen sind von leichtesten zu schwersten sortiert.
| Modell | Parameter | Typ | Kontext | Läuft auf | Anmerkungen |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Cross-Encoder | 128 | CPU | Hindsight-Standard; in hindsight:latest enthalten. Sub-Sekunden für ~20 Kandidaten. Als benannter Fallback behalten, wenn ein schwereres BGE-Modell zu langsam ist. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Cross-Encoder | 512 | CPU | Gleiche Familie, höhere Genauigkeit; immer noch Englisch-lastiges MS MARCO. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Cross-Encoder | 512 | CPU | Hindsight-dokumentierter mehrsprachiger MiniLM-Reranker. |
BAAI/bge-reranker-base |
278M | Cross-Encoder | 512 | CPU | Mäßiges Upgrade gegenüber MiniLM; en/zh. Oft diskutiert; übersprungen, wenn v2-m3 bereits ins Latenz-Budget passt. |
BAAI/bge-reranker-v2-m3 |
568M | Cross-Encoder | 8k | CPU oder GPU | Praktischer mehrsprachiger Standard auf CPU. Auf einer ~500-Speicher-Bank, ~2.6–2.8 s pro Recall bei einem 20-Kandidaten-Unterboden (~140 ms/Kandidat; ~93–99% der Recall-Zeit). Kandidaten-Caps 20/40/80; Senken des Unterbodens von 20 → 10 halbiert die Rerank-Kosten ungefähr. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Generativ (yes-token) | 32k | GPU bevorzugt | Anweisungs-bewusst, langer Kontext. Kein Drop-in-Cross-Encoder: benötigt aktuelle SentenceTransformers-generative-Reranker-Unterstützung, und llama.cpp /rerank Scoring hat bekannte falsche-Score-Bugs (hindsight-benchmarks#11). Validieren, bevor es adoptiert wird. |
BAAI/bge-reranker-v2-gemma |
2.5B | Cross-Encoder | 8k | GPU bevorzugt | Starke mehrsprachige Qualität; übertrieben für eine persönliche Bank mit wenigen hundert Erinnerungen, wenn die GPU bereits voll ist. |
Qwen/Qwen3-Reranker-4B |
4B | Generativ | 32k | GPU | Höherwertiger Qwen-Kandidat; nicht machbar ohne dedizierte VRAM. |
Qwen/Qwen3-Reranker-8B |
8B | Generativ | 32k | GPU | Familien-Oberstufe; gleiche generative Scoring-Vorsicht, noch größer. |
Cloud-API-Reranker (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe, und ähnlich) funktionieren in Hindsight, senden aber Speichertext aus dem Gerät. Für eine nur lokale Cross-Domain-Anordnung sind sie außerhalb des Rahmens.
Zwei operative Einschränkungen dominieren die Wahl. VRAM: wenn das konversationelle Modell die GPU bereits sättigt (zum Beispiel ein Qwen3.8-27B Q5 auf einer 16-GB-Karte ohne Spielraum), sind alle „GPU bevorzugt“-Zeilen aus dem Rennen und die Live-Wahl kollabiert zu MiniLM oder BGE-v2-m3 auf CPU. Kandidatenanzahl: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 im externen Endpunkt-Beispiel unten) begrenzt, wie viele Passagen das Modell neu bewertet; jeder Kandidat ist ein vollständiger Vorwärts-Durchlauf, also schneiden Sie den Unterboden, bevor Sie eine Modell-Stufe springen. Für Qwen3 über llama.cpp muss die GGUF den Ranking-Head behalten — ein altes convert_hf_to_gguf.py, das ihn verwirft, bewertet jede Passage nahe Null — und selbst eine korrekte Konversion benötigt weiterhin einen bekannten guten/known-bad Passage-Test, bis der generative Scoring-Pfad bestätigt ist.
Generative LLM-Stufen
Embedding- und Reranking-Modelle sind keine Ersatz für das generative LLM, das verwendet wird, um Erinnerungen zu extrahieren und darüber nachzudenken. Hindsight unterstützt ein Standard-LLM und operationsspezifische Overrides, die denselben llama.cpp-Server oder unabhängige Endpunkte targeten können.
| Hindsight-Operation | Zweck | Praktische Modellstufe | Qwen-Beispiele |
|---|---|---|---|
| Retain | Extrahieren von Fakten, Entitäten, Entscheidungen und Chronologie | 4B Minimum für Tests; 9B bevorzugt | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Semantische, stichwortbasierte, grafische und temporale Abfrage | Kein generatives LLM erforderlich | Qwen3-Embedding-0.6B + Reranker |
| Reflect | Fragen beantworten, indem abgerufene Erinnerungen synthetisiert werden | 9B bis 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Konsolidierung | Verwandte Fakten ausgleichen und komprimieren | 9B bevorzugt | Qwen3.5-9B / Qwen3.8-27B |
| Mentales Modell aktualisieren | Langlebigeres synthetisiertes Verständnis aktualisieren | 9B bis 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Das sind operative Empfehlungen, keine offiziellen Hindsight-Minimalparameterzahlen. Ein kleines Modell kann eine Portnummer korrekt extrahieren, aber verfehlen, dass eine frühere architektonische Entscheidung ersetzt wurde. Zuverlässigkeit strukturierter Ausgabe und treue Behandlung von Verneinung sind wichtiger als die nominelle Parameterzahl allein. Hindsights eigene Temperatur-Standards sind es wert, unangetastet zu bleiben — 0.1 für Retain, 0.0 für Konsolidierung, 0.9 für Reflect — und für Retain und Konsolidierung ist der nicht-denkende Alias es wert, bedient zu werden, wenn Ihr llama.cpp-Build einen hat, weil die kleinen Qwen3.5-Checkpoints viele Tokens im Denkmodus verbringen.
Für eine Bereitstellung mit einem vorhandenen Qwen3.8-27B llama.cpp Endpunkt, fangen Sie an, ihn über generative Hindsight-Aufgaben mit niedriger Konvergenz zu teilen:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
Später, leiten Sie routinemäßige Extraktion zu einem unabhängigen 9B-Modell und reservieren Sie das 27B für schwierige Reflexion:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://MEMORY_LLM_HOST:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
Das kleinere 4B-Modell ist wirtschaftlich, aber braucht Tests; 9B ist ein sinnvoller Kompromiss aus Qualität/Leistung. Wenn Retain und Konsolidierung ein kleines Modell teilen, senken Sie HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE auf 2 — der Standard-Batch von 8 ist ein langer Prompt für ein kleines Kontextfenster. Qwen3.6-35B-A3B ist attraktiv für einen separaten gut provisionierten Inferenz-Server (es ist ein Mixture-of-Experts-Modell mit etwa 3 Milliarden aktiven Parametern, also budgetieren Sie es als kleines aktives Modell), während ein 27B-dichtes Modell normalerweise für jedes routinemäßige Retain-Event nicht erforderlich ist. Das Begrenzen der Hintergrund-Konvergenz schützt das Hermes-Konversationsmodell vor Speicher-Pflege-Spitzen.
Lokale Modelle bereitstellen und verkabeln
Wenn die in-process local Embedding- und Reranker-Einstellungen in „Modelle wählen“ ausreichen, können Sie die externen Ollama- und llama.cpp-Untersektionen überspringen und zum Verkabeln springen — oder Compose auf den local-Standards belassen, die dort gezeigt werden. Externe Endpunkte sind wichtig, wenn der Embedder oder Reranker auf einem anderen Host leben sollte.
Externe Embeddings: Ollama oder llama.cpp
Externe Embeddings sind für den Fall, dass Sie Qwen3-Embedding-0.6B (oder ein anderes Modell) auf einem separaten Host wollen. Zwei praktische Optionen sind Ollama, das Modellbeschaffung und Servier mit wenig Konfiguration handhabt, und llama.cpp, das präzise Kontrolle über GGUF-Quantisierung, CPU-Threads, Geräteplatzierung und Batching gibt. Modellhintergrund und Benchmarks für beide Qwen3-Modelle sind in Qwen3 Embedding und Reranker Modelle auf Ollama.
Qwen3-Embedding-0.6B liefert 1024-dimensionale Vektoren, und Hindsight liest diese Breite beim Start ein und dimensioniert die Datenbank entsprechend. Eine Bank, die mit dem gebündelten 384-dimensionalen BGE-Modell erstellt wurde, kann dieses Modell nicht aufnehmen — starten Sie von einer leeren Datenbank oder einem Volume und entscheiden Sie das Embedding-Modell vor dem ersten Retain. Ein späterer Wechsel des Embedding-Anbieters erfordert das Re-Embedding gespeicherter Datensätze, selbst wenn beide Modelle die gleiche Dimensionalität verwenden.
Option 1: Ollama für Qwen3-Embedding-0.6B
Installieren Sie Ollama auf dem Inferenz-Host, indem Sie seine offizielle Linux-Installationsdokumentation verwenden, und starten Sie dann das Embedding-Modell:
ollama pull qwen3-embedding:0.6b
ollama serve
Für Fernzugriff konfiguriert Sie Ollamas OLLAMA_HOST=0.0.0.0:11434 in seiner Service-Umgebung, starten Sie den Service neu und firewallen Sie ihn auf die Hindsight-VM — das Verfahren wird in Ollama Fernzugriff abgedeckt. Ein Daemon, der nur an 127.0.0.1 gebunden ist, ist für den Hindsight-Container unsichtbar. Prüfen Sie zuerst den Modellnamen mit ollama list und testen Sie den standardmäßigen Embedding-Endpunkt:
curl http://EMBED_HOST:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
Hindsights OpenAI-Embedding-Anbieter ruft stattdessen Ollamas OpenAI-kompatiblen /v1/embeddings-Endpunkt auf. Stellen Sie sicher, dass dieser Endpunkt mit Ihrer Ollama-Version funktioniert, bevor Sie Hindsight konfigurieren. Ollama ist straightforward für Embeddings; nehmen Sie nicht an, dass seine API einen kompatiblen Reranking-Endpunkt anbietet. Für Reranking, bevorzugen Sie den in-process local BGE-Weg unten, oder einen separaten llama.cpp / TEI-Endpunkt, nachdem Sie Scores validiert haben.
Option 2: llama.cpp für Qwen3-Embedding-0.6B
Laden Sie eine verifizierte Qwen3-Embedding-0.6B GGUF-Konversion herunter. Verwenden Sie den GGUF-Dateinamen, den Sie tatsächlich heruntergeladen haben:
#!/bin/sh
# start-embedding.sh - CPU-only embedding server
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Qwen3-Embeddings verwenden last-token-Pooling, im Gegensatz zum CLS-Pooling, das von einigen BGE-Modellen verwendet wird. Ein nur CPU-llama.cpp-Build ist vorzuziehen, wenn Sie absolut keine CUDA-Initialisierung auf einer Workstation wollen, deren GPU von einem großen Konversationsmodell besetzt ist. Aktivieren Sie --reranking nicht auf diesem Embedding-Server: diese Kombination ist ein bekannter Weg, einen Vektor von Nullen zu erhalten.
curl -s http://EMBED_HOST:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
Eine volle Dimensions-Qwen3-Embedding-0.6B-Ausgabe sollte 1024 Floats enthalten. Prüfen Sie, dass die GGUF-Konversion und Ihre Hindsight-Query/Dokument-Anweisungsverarbeitung kompatibel sind; anweisungs-empfindliche Embedding-Modelle können Genauigkeit verlieren, wenn sie falsch abgefragt werden.
Reranker: lokales BGE oder Qwen3 über llama.cpp
Reranking ist anders als Embeddings: das Modell bewertet jedes Query/Dokument-Paar und gibt einen Relevanz-Score zurück. Auf einem nur CPU-Hindsight-Host — oder wann immer die konversationelle GPU keinen VRAM-Spielraum hat — ist der praktische Weg Hindsights local-Anbieter mit BAAI/bge-reranker-v2-m3 (oder dem leichteren MiniLM-Standard). Kein Sidecar ist erforderlich:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B ist ein generativer yes-Token-Score, kein klassischer Cross-Encoder. Es kann über llama.cpp mit einer GGUF-Konversion für Ranking bedient werden, aber behandeln Sie diesen Pfad als experimentell, bis Sie Scores auf einem bekannten guten/bekannten schlechten Paar bestätigen: ein altes convert_hf_to_gguf.py, das den Ranking-Head verwirft, bewertet jede Passage nahe Null, und llama.cpps nativer /rerank-Pfad hat bekannte falsche Score-Berichte für diese Familie.
#!/bin/sh
# start-reranker.sh - GPU or CPU as selected by --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Setzen Sie --n-gpu-layers 0, um es auf CPU auszuführen. Die GPU-Version benötigt zusätzlichen VRAM für Berechnungspuffer und Kontext, nicht nur Modellgewichte; nehmen Sie nicht an, dass die Dateigröße die gesamte GPU-Zuweisung ist.
curl -s http://RERANK_HOST:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
Das PostgreSQL-Dokument sollte über dem irrelevanten Dokument rangieren; alle Nullen-Relevanz-Scores bedeuten, dass die GGUF die falsche Konversion ist, und Recall wird zufällig aussehen, auch wenn die Fakten gespeichert sind. Prüfen Sie die genaue results[].index und results[].relevance_score-Form: Hindsight erwartet eine Cohere-kompatible Rerank-Antwort, und llama.cpp-Kompatibilität kann sich zwischen Builds unterscheiden.
Endpunkte in Hindsight verkabeln
Fügen Sie die folgenden Umgebungseinstellungen dem Hindsight-Compose-Service hinzu oder speichern Sie sie in seiner .env-Datei. Wählen Sie einen Embedding-Weg — in-process local, Ollama oder llama.cpp — nie zwei gleichzeitig.
# Option A: in-process Qwen3 on the Hindsight host (CPU; no sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Option B: llama.cpp embedding service
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://EMBED_HOST:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option C: Ollama on another host
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option: local BGE reranker (no sidecar; preferred on CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Option: llama.cpp Cohere-compatible rerank endpoint (validate Qwen3 scores first)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://RERANK_HOST:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
Die Variablennamen sind anbieter-spezifisch, und ein knappes Versagen ist stumm: HINDSIGHT_API_EMBEDDINGS_BASE_URL ist der falsche Schlüssel, und Hindsight zielt still auf OpenAIs eigenen Embedding-Endpunkt statt auf Ihren lokalen Server. Verwenden Sie HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. Mit dem Cohere-kompatiblen Reranker-Weg postet Hindsight den vollen Cohere-Style-Körper an HINDSIGHT_API_RERANKER_COHERE_BASE_URL; wenn das Container-Log einen 404 für /v1/rerank/rerank zeigt, hängt Ihr Build /rerank selbst an und der Wert sollte bei /v1 enden.
Für Optionen B und C, verwenden Sie den HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX-Wert aus Embedding-Modelle (Option A lässt es ungesetzt). Testen Sie Query-zu-Passage-Abfrage auf Ihren tatsächlichen Erinnerungen nach dem ersten Retain.
Kontrolle, was erinnert wird
Mit dem laufenden Stack ist der nächste Fehlerszenario normalerweise der Schreibpfad: Hermes standardmäßig auf auto_retain: true, also kann jeder Gesprächs-Round in die Bank extrahiert werden. Falsche Vermutungen, verworfene Pläne und exploratorische Aussagen werden zu durchsuchbaren Fakten, und späterer Recall behandelt sie als Evidenz — die Schleife, die in selbst verstärkende Speicherschleifen beschrieben wird. Die Erfassungs-Policy für Hindsight unter anderen Anbietern wird zusammengefasst in Vergleich von Agenten-Speicher-Anbietern.
Erfassungs-Modi, die heute existieren
| Modus | Hermes / Hindsight Einstellungen | Was Sie bekommen |
|---|---|---|
| Kontinuierlich | auto_retain: true, retain_every_n_turns: 1 |
Jeder Round wird bewahrt und extrahiert |
| Batch-Auto | auto_retain: true, erhöhen von retain_every_n_turns |
Weniger, größere Retain-Loads — immer noch automatisch, keine Prüfungs-Queue |
| Nur explizit | auto_retain: false + Tool hindsight_retain |
Speicherung nur, wenn der Agent das Tool aufruft (zum Beispiel nach „merke dir das“) |
| Sitzungs-Synthese | End-of-Session hindsight_retain einer Zusammenfassung, oder Bank reflect / Konsolidierung |
Ein kuratiertes Schreiben, wenn Sie oder der Agent den Aufruf disziplinieren — kein eingebauter Flush-for-Approval |
auto_retain auf false zu setzen deaktiviert die automatische Speicherung. Es fügt nicht einen menschlichen Genehmigungsdialog vor jedem Schreiben hinzu. Der Agent kann immer noch hindsight_retain aufrufen, wann immer seine Tools es erlauben; behandeln Sie explizites Retain als bewusste Erfassung, nicht als anhängende Queue.
Die Genehmigungs-Queue-Lücke
Ein häufiger Wunsch ist eine anhängende Queue von Kandidaten-Erinnerungen, die Sie prüfen und genehmigen, bevor sie in die Bank einfließen. Hindsight unter Hermes stellt diesen Vertrag heute nicht bereit. Mnemosyne für Hermes implementiert in einigen Versionen anbieter-spezifische gestufte Schreiben; dieser Pfad ist kein geteilter Hermes-Standard und gilt nicht für das Hindsight-Plugin. Bis ein Upstream-Genehmigungsfluss existiert, ist das machbare Muster auto_retain: false, bewusste hindsight_retain und Inspektion oder Löschung in der Hindsight-Kontrollflächen-UI, bevor die nächste Sitzung auf einer schlechten Tatsache verlässt. Es gibt keinen fehlenden write_approval-Schlüssel für Hindsight, den Sie in config.json suchen müssten.
Bank-Steuerung (Missions, Labels, Direktiven, mentale Modelle)
Menschen nennen die nächste Ebene oft „Fine-Tuning“. In Hindsight ist es meistens Bank-Konfiguration, nicht nur Hermeas config.json: Missions und Extraktionseinstellungen lenken, was Retain behält; Labels strukturieren Entitäten; Direktiven und mentale Modelle formen spätere Synthesen.
| Kontrolle | Wo sie lebt | Wie sie hilft |
|---|---|---|
Retain-Mission (retain_mission / Hermes bank_retain_mission) |
Bank-Konfiguration | Klarsprachige „Achte auf X, ignoriere Y“ in Extraktion injiziert |
Extraktionsmodus (concise, verbose, custom, …) |
Bank-Konfiguration | concise (Standard) behält langfristig wertvolle Fakten; custom ersetzt eingebaute Regeln via retain_custom_instructions |
| Entitäts-Labels | Bank-Konfiguration | Kontrolliertes key:value-Vokabular zur Retain-Zeit → Grafik-Links und optionale Tags; verbessert Abfrage-Struktur, lehnt falsch Aussagen nicht von selbst ab |
| Direktiven („harte Regeln“) | Bank-Direktiven-API | Explizite Anweisungen, die während Reflect durchgesetzt werden (Tag-scope); beschränken Synthese, keine Schreibgenehmigungs-Gate |
| Mentale Modelle | Bank-mentales-Modell-API | Laufende Antworten auf wiederkehrende Fragen, aktualisiert via Reflect aus passenden Erinnerungen; abgeleitet, also vergiften schlechte Quellfakten sie immer noch |
| Reflect / Beobachtungs-Mission | Bank-Konfiguration | Lenkt Synthese und Konsolidierung, nicht den rohen Retain-Feuerhose |
Missions, präzise Extraktion und Labels reduzieren Rauschen und verbessern die Abfrage. Sie ersetzen nicht das Ausschalten von Auto-Retain, wenn Genauigkeit wichtiger ist als Vollständigkeit. Bevorzugen Sie eine kurze Retain-Mission, die dauerhafte Projektentscheidungen benennt und Chat-Logistik ignoriert; fügen Sie Entitäts-Labels nur hinzu, wenn Sie eine echte Taxonomie haben; fügen Sie mentale Modelle für zwei oder drei wiederkehrende Fragen hinzu, nachdem die Bank bereits saubere Fakten hält.
Empfohlenes Hygiene-Profil
Ein konkreter Startpunkt für eine persönliche Hermes-Bank:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
Auf der Bank, setzen Sie eine Retain-Mission und lassen Sie die Extraktion im concise-Modus (über die Kontrollfläche oder Banks-API). Nach einem expliziten Retain, öffnen Sie die UI, bestätigen Sie die Beobachtung und löschen Sie Fehler, bevor Konsolidierung oder mentales-Modell-Aktualisierung läuft. Lassen Sie recall_prefetch_method bei recall — reflect gibt einen Chat-Modell-Aufruf vor jedem Round aus und injiziert Synthese statt der zugrunde liegenden Fakten.
Hermes Agent mit Hindsight verbinden
Auf der Hermes VM, installieren Sie das Katalog-Plugin, und führen Sie dann den Setup-Assistenten aus. Wählen Sie Hindsight und den local_external-Modus; das Plugin muss kein eingebettetes PostgreSQL starten oder den Hindsight-Modell-Stack lokal ausführen, und local_embedded würde einen zweiten Hindsight-Daemon neben dem Container starten, den Sie gerade ausgeführt haben.
hermes plugins install hindsight
hermes memory setup hindsight
Es wird eine Interessante Menge von Optionen für die Agentenrolle mit Hindsight geben.
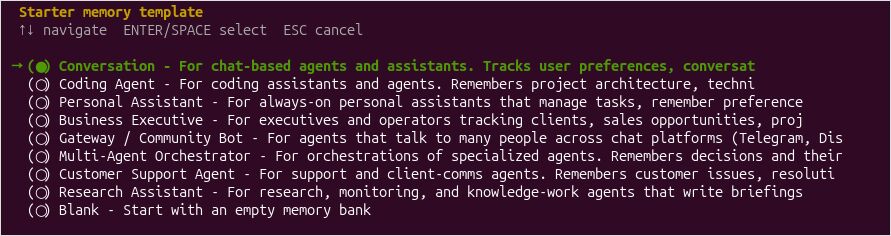
hermes memory status
Die externe Hindsight-Verbindung lebt in ~/.hermes/hindsight/config.json. Eine illustrative Konfiguration, die kontinuierliche Erfassung (Hermes-Standards) behält, ist:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Für nur explizites Retain und Bank-Steuerung, verwenden Sie das Hygiene-Profil in Kontrolle, was erinnert wird, anstatt auto_retain aktiv zu lassen. recall_sync: false priorisiert interaktive Reaktionsfähigkeit, kann aber erinnerungskontext auf dem folgenden Round injizieren. Verwenden Sie synchronen Recall, wenn die aktuelle Anfrage die neuesten Erinnerungen einbeziehen muss, bevor das Modell mit dem Antworten beginnt. retain_async: true verhindert das Blockieren gewöhnlicher Antworten, während Erinnerungen verarbeitet werden.
Der Standard-Recall des Plugins ist nur Beobachtungen; rohe Welt- und Erfahrungsfakten bleiben in der Bank und aus dem Prompt, bis Konsolidierung eine Beobachtung geschrieben hat, oder bis Sie recall_types auf observation,world,experience erweitern. Das Erweitern für die erste Woche und das Beobachten der Kontrollfläche, dann das Verengen, ist eine sinnvolle Reihenfolge.
Eingebautes Hermes-Speicher bleibt neben dem Anbieter aktiv; das Behalten von MEMORY.md und USER.md aktiv, während Sie lernen, was Hindsight hinzufügt, ist in Ordnung, und der Speicher-System-Artikel ist der Ort, um zu entscheiden, ob die flachen Dateien bleiben sollten.
Starten Sie das Gateway neu, wenn es bereits läuft:
hermes gateway restart
hermes memory status
Der Status sollte Hindsight als aktiven Anbieter identifizieren. Für einen breiteren Befehlsreferenz, einschließlich Hermeas TUI und Plugin-Befehle, siehe das Hermes Agent CLI Spickzettel.
Speicher validieren, nicht nur Installation
Fragen Sie Hermes, eine wegwerfbare Tatsache über ein Testprojekt zu merken, starten Sie eine andere Sitzung und fragen Sie nach dieser Tatsache erneut. Bewahren ist asynchron standardmäßig und Extraktion wartet auf das Chat-Modell, also geben Sie dem Haupt-llama.cpp-Server einen Moment, bevor Sie urteilen. Dann testen Sie einen härteren Fall: sagen Sie Hermes, dass eine frühere Entscheidung sich geändert hat und fragen Sie, welche Entscheidung aktuell ist und warum. Prüfen Sie Hindsights UI und gespeicherte Beobachtungen, anstatt anzunehmen, dass memory status beweist, dass Ingestion und Recall korrekt sind.
Wenn die Antwort leer zurückkommt, inspizieren Sie die Kontrollfläche, bevor Sie Modelle ändern. Ein Retain kann erfolgreich sein und immer noch für Recall unsichtbar, während recall_types nur Beobachtungen ist und Konsolidierung nicht gelaufen ist — das Erweitern von recall_types ist der erste Check. Ein Connection Refused im Embedding-Server-Log bedeutet, dass der Container den Embedding-Port nicht erreichen kann, und alle Nullen-Reranker-Scores bedeuten, dass die GGUF die falsche Konversion ist.
Schreibpfad-Wahlen (auto_retain, Missions, Genehmigungs-Lücke) werden in Kontrolle, was erinnert wird abgedeckt.
Fehlerbehebung und operative Hinweise
| Symptom | Wahrscheinliche Ursache | Erster Check |
|---|---|---|
| Hermes sagt Anbieter nicht verfügbar | Falsche local_external URL oder Netzwerkregel |
curl http://HINDSIGHT_VM_IP:8888/health |
| Docker startet, PostgreSQL-Fehler | Fehlende Erweiterung, falsche Anmeldedaten oder unzureichender Freigedaten-Speicher | Container-Logs und pg_extension |
| Embeddings geben 401 oder 404 zurück | Falsche OpenAI-kompatible URL, falscher Umgebungsvariablenname oder Modell-Alias-Unstimmigkeit | Direkter /v1/embeddings-Test und Variablennamen |
| Reranking schlägt fehl | Endpunkt- oder Antwortformat-Unstimmigkeit, einschließlich doppelter /rerank-Pfad |
Direkter /v1/rerank-Test und Container-Log |
| Recall liefert nichts Brauchbares | recall_types auf Beobachtungen beschränkt oder Nullen-Reranker-Scores |
Kontrollfläche, dann recall_types, dann Reranker-Konversion |
| Vorhandene Bank meldet Dimensions-Unstimmigkeit | Embedding-Modell geändert | Vektoren neu aufbauen/Reimportieren mit einem konsistenten Modell |
| Hermes-Antworten verlangsamen sich | Synchoner Recall oder geteilter LLM-Konflikt | Synchronen Recall ausschalten; Retain-Konvergenz begrenzen |
| Irrelevante Erinnerungen wiederholen sich | Schwache Extraktion, rauschige Abfrage oder unzureichende Konsolidierung | Beobachtungen und Relevanz-Scores inspizieren |
Eine praktische kleine Bereitstellung ist 2-4 vCPUs und 4-6 GB RAM für die Hindsight-API-VM, wenn PostgreSQL und alle Inferenz extern sind. Die Festplatten-Zuweisung hängt immer noch vom gewählten Docker-Image und beibehaltenen Image-Schichten ab; weisen Sie ungefähr 30-40 GB initial mit Raum zum Erweitern zu. Dimensionieren Sie den PostgreSQL-Host basierend auf tatsächlicher Speichergröße, Speicherleistung und den anderen Datenbanken, die er bedient.
Sicherung und Wiederherstellung der Hindsight-Bank
Die Speicherbank ist der einzige Zustand, der wichtig ist, und sie lebt in PostgreSQL. In Option B ist das eine Datenbank, die Sie verwalten; in Option A ist es das eingebettete pg0 benannte Volume innerhalb des Containers. Sichern Sie es unabhängig vom Hindsight-Container — das Neu-erstellen des Containers, ohne zuerst das Volume oder die Datenbank zu erfassen, verwirft die Bank, und hermes backup erreicht keine Bank, die in einem separaten Dienst läuft.
Option B — externes PostgreSQL. Dumpen Sie die hindsight-Datenbank im Custom-Format und wiederherstellen Sie sie in eine Scratch-Datenbank, um das Archiv zu verifizieren, bevor Sie ihm vertrauen:
pg_dump -h POSTGRES_IP -U hindsight -Fc hindsight > hindsight-bank.dump

# restore into a scratch database to prove the dump is usable
createdb -h POSTGRES_IP -U postgres hindsight-verify
pg_restore -h POSTGRES_IP -U postgres -d hindsight-verify hindsight-bank.dump
Bestätigen Sie die pgvector-Erweiterung und eine Beispiel-Recall in der wiederhergestellten Kopie, bevor Sie das ursprüngliche Dump-Ziel löschen. Bewahren Sie das Dump auf einem anderen Host als der Hindsight-VM auf und führen Sie dies als PostgreSQL-Administrator (eine Rolle, die Datenbanken erstellen kann) aus, nicht als Anwendungsrolle.
Option A — alle-in-einem-Container. Die eingebettete Datenbank ist ein benanntes Volume, also stoppen Sie den Container und packen Sie das Volume über ein Wegwerf-Image:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
Der Mount-Punkt innerhalb des tar-Containers (/data) ist willkürlich; er aliasiert einfach das benannte Volume, damit tar es lesen kann. Zum Wiederherstellen, stoppen Sie den Container, leeren Sie das Volume und entpacken Sie das Archiv zurück hinein, oder zeigen Sie den Container auf die externe PostgreSQL-Wiederherstellung aus Option B.
Nehmen Sie einen Snapshot in drei Momenten, anstatt auf einem Kalenderplan: bevor Sie das Embedding-Modell ändern, vor einem großen Hindsight- oder PostgreSQL-Upgrade und vor einem reflect- oder Konsolidierungsdurchgang, der die Bank umschreibt. Eine Sicherung, die Sie in eine Scratch-Bank wiederhergestellt haben, ist mehr wert als eine, die Sie nur geschrieben haben.
Exportieren, Importieren und Migrieren der Speicherbank
Sicherung und Wiederherstellung schützen die Bank vor Ort. Export/Import bewegt sie zwischen Hindsight-Instanzen, und das ist, was eine Modelländerung tatsächlich zwingt zu tun.
Das Ändern des Embedding-Modells ist keine Konfigurationsbearbeitung. Die Vektoren in der Bank wurden mit dem alten Modell berechnet, und ein anderes Modell — zum Beispiel der gebündelte 384-dimensionale BGE-Embedder gegenüber 1024-dimensionalem Qwen3-Embedding-0.6B — schreibt in einen anderen Raum und normalerweise eine andere Breite. Sie können die vorhandene Instanz nicht neu auf den neuen Embedder zeigen lassen und die alten Vektoren behalten; die Dimensionen müssen durch Re-Embedding jeder Erinnerung mit dem neuen Embedding-Modell neu berechnet werden.
Weil der Embedder und seine Konfiguration pro Hindsight-Instanz gesetzt sind, ist der saubere Weg, eine neue Instanz mit der neuen Embedding-Konfiguration aufzubauen und die Bank in sie zu migrieren, anstatt Vektoren innerhalb der bereits Recall bereitstellenden neu aufzubauen. Die Hindsight-API kann die Bank auch bewegen, aber für eine einmalige Änderung ist Export/Import der einfachere und besser inspizierbare Weg:
# export the bank from the old instance
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# import the bank into the new instance
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t verifiziert das Archiv, bevor Sie es zur neuen Instanz schicken. Nach dem Import, zeigen Sie Hermes neu auf die api_url der neuen Instanz in ~/.hermes/hindsight/config.json, starten Sie das Gateway neu und führen Sie die Speicher-Validierung von früher aus: eine bewahrte Tatsache sollte durch den neuen Embedder erinnert werden. Lassen Sie die alte Bank und ihre Vektoren in der alten Instanz, bis die neue funktioniert, so dass Sie immer noch einen funktionierenden Fallback haben.
Überwachen, beschneiden und die Bank stabil halten
Mit der laufenden Bank ist die tägliche Arbeit, zu beobachten, was das Extraktionsmodell zum Speichern entschieden hat, und abgeleitete Zustände im Griff zu halten. Verwenden Sie die Kontrollflächen-UI (hindsight-embed -p hermes ui start), um Beobachtungen, Relevanz-Scores und Konsolidierungsoutput zu inspizieren, anstatt anzunehmen, dass memory status beweist, dass Ingestion und Recall korrekt sind. Duplizierte oder veraltete Erinnerungen sind normalerweise eine schwache Extraktion oder eine unterlaufenen Konsolidierung, also beheben Sie die Extraktionsebene oder die Konsolidierungsfrequenz, bevor Sie die Abfrage erweitern.
Zwei Wartungsfallen sind es wert, getestet zu werden, bevor Sie sich auf die Bank verlassen. Erstens, das Löschen einer Beobachtung garantiert nicht, dass jede abgeleitete Darstellung damit verschwindet — ein reflect-Fakt oder eine Grafik-Kante, die daraus gebaut wurde, kann das Löschen überleben, also verifizieren Sie das Löschen von Ende zu Ende, dasselbe Provenienz-Bedenken, das in selbst verstärkende Speicherschleifen abgedeckt wird. Zweitens, halten Sie HINDSIGHT_API_WORKER_ID über Neuanlegungen hinweg stabil und fixieren Sie ein spezifisches Image-Tag: eine Aufgabe, die in der Luft hing, als der Container starb, bleibt unter der alten Worker-ID stecken, und ein sich bewegendes Tag ist eine schlechte Wahl für eine Datenbank, die Sie behalten möchten.
