Hardware

KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

Warum 128K Kontext auf 16 GB scheitert

Ein Modell kann einen 128K-Kontextfenster bewerben und trotzdem bei 40K Tokens auf einer 16-GB-GPU scheitern. Die architektonische Obergrenze hat nie versprochen, dass Modellgewichte, KV-Cache, Rechenspeicher und der Desktop-Compositor gleichzeitig auf Ihrer Grafikkarte Platz finden würden.
Datengravitation: Die echten Kosten der API-first-KI

Datengravitation: Die echten Kosten der API-first-KI

Warum Ihr KI-Stack jeden Monat klebriger wird.

Jeder API-Aufruf fühlt sich wie eine simple Transaktion an – bis genug von ihnen akkumuliert sind, sodass Ihre Feinabstimmungsdaten, Bewertungsumgebungen und Tool-Schemata alle um einen einzigen Anbieter herum geformt werden, und der Wechsel keine bloße Routing-Änderung mehr ist.

GPUs für KI im Jahr 2026: NVIDIA, AMD und Intel im Vergleich

GPUs für KI im Jahr 2026: NVIDIA, AMD und Intel im Vergleich

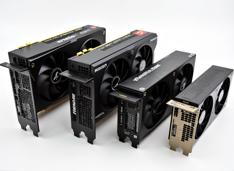
Vergleich von AI-GPUs dreier Anbieter

Die Landschaft der KI-Hardware hat sich 2026 erheblich verändert. NVIDIA, AMD und Intel konkurrieren alle um Entwickler, die GPUs benötigen, die in der Lage sind, lokale Large Language Models (LLMs) und KI-Inferenz-Arbeitslasten auszuführen.