LLM Hosting

Datengravitation: Die echten Kosten der API-first-KI

Datengravitation: Die echten Kosten der API-first-KI

Warum Ihr KI-Stack jeden Monat klebriger wird.

Jeder API-Aufruf fühlt sich wie eine simple Transaktion an – bis genug von ihnen akkumuliert sind, sodass Ihre Feinabstimmungsdaten, Bewertungsumgebungen und Tool-Schemata alle um einen einzigen Anbieter herum geformt werden, und der Wechsel keine bloße Routing-Änderung mehr ist.

Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

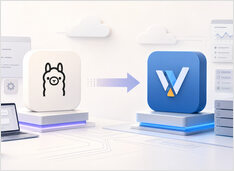
Wann von Ollama auf vLLM wechseln

Ollama ist einer der einfachsten Wege, ein lokales Sprachmodell auszuführen, aber die Bequemlichkeit kann den Moment verbergen, in dem ein lokales Experiment zu einem gemeinsamen Inferenzdienst wird, der eine bessere Planung und Beobachtbarkeit benötigt.

Vane (Perplexica 2.0) Quickstart mit Ollama und llama.cpp

Vane (Perplexica 2.0) Quickstart mit Ollama und llama.cpp

Selbst gehostete KI-Suche mit lokalen LLMs

Vane ist einer der pragmatischeren Vertreter im Bereich „KI-Suche mit Quellenangaben": eine selbst gehostete Antwort-Engine, die die Live-Webrecherche mit lokalen oder Cloud-LLMs kombiniert, während der gesamte Stack unter Ihrer Kontrolle bleibt.

Ollama in Docker Compose mit GPU und persistenter Model-Speicherung

Ollama in Docker Compose mit GPU und persistenter Model-Speicherung

Compose-first Ollama-Server mit GPU und Persistenz.

Ollama läuft hervorragend auf Bare-Metal-Systemen. Es wird noch interessanter, wenn man es wie einen Dienst behandelt: mit einem stabilen Endpunkt, festgelegten Versionen, persistentem Speicher und einer GPU, die entweder verfügbar ist oder eben nicht.

llama.swap Modellumschalter: Schnelleinstieg für OpenAI-kompatible lokale LLMs

llama.swap Modellumschalter: Schnelleinstieg für OpenAI-kompatible lokale LLMs

Lokale LLMs per Hot-Swap austauschen, ohne die Clients anzupassen.

Bald jonglierst du mit vLLM, llama.cpp und weiteren – jeder Stack auf seinem eigenen Port. Alles, was downstream liegt, erwartet weiterhin eine einzige /v1-Basis-URL; andernfalls musst du ständig Ports, Profile und Einmalskripte umstellen. llama-swap ist die /v1-Proxy-Schicht vor diesen Stacks.

LocalAI QuickStart: OpenAI-kompatible LLMs lokal ausführen

LocalAI QuickStart: OpenAI-kompatible LLMs lokal ausführen

Bereitstellen von OpenAI-kompatiblen APIs mit LocalAI in wenigen Minuten auf dem eigenen Server.

LocalAI ist ein selbstgehosteter, lokal-first Inferenzserver, der sich wie eine Drop-in OpenAI API verhält, um KI-Arbeitslasten auf Ihrer eigenen Hardware (Laptop, Workstation oder lokaler Server) auszuführen.

Schnellstart von llama.cpp mit CLI und Server

Schnellstart von llama.cpp mit CLI und Server

GGUF-Modelle mit der CLI und dem Server ausführen

llama.cpp ist eine C/C++-Inferenz-Engine für GGUF-Modelle: llama-cli für interaktive Chats, llama-completion für skriptgesteuerte Prompts und llama-server für eine OpenAI-kompatible HTTP-API.