
비교: Qwen3:30b와 GPT-OSS:20b
두 모델의 속도, 파라미터 및 성능 비교
다음은 Qwen3:30b와 GPT-OSS:20b 비교 내용입니다. 지시 따름 능력(instruction following)과 성능 파라미터, 사양 및 속도에 초점을 맞추었습니다.
두 모델의 속도, 파라미터 및 성능 비교
다음은 Qwen3:30b와 GPT-OSS:20b 비교 내용입니다. 지시 따름 능력(instruction following)과 성능 파라미터, 사양 및 속도에 초점을 맞추었습니다.
+ 사고형 LLM을 사용한 구체적인 예시
이 포스트에서는 Python 애플리케이션을 Ollama에 연결하는 방법에 대해 두 가지 방법을 소개합니다: 1. HTTP REST API를 통해; 2. 공식 Ollama Python 라이브러리를 통해.
매우 좋지 않다.
Ollama의 GPT-OSS 모델은 특히 LangChain, OpenAI SDK, vllm과 같은 프레임워크와 함께 사용될 때 구조화된 출력을 처리하는 데 반복적으로 문제가 발생합니다.
Ollama에서 구조화된 출력을 받는 몇 가지 방법
대규모 언어 모델(LLM) 은 강력하지만, 프로덕션 환경에서는 자유형식(paragraph) 응답을 원하는 경우가 드뭅니다. 대신, 애플리케이션에 직접 입력할 수 있는 예측 가능한 데이터, 즉 속성, 사실 또는 구조화되어 객체를 원합니다. 이것이 바로 LLM 구조화 출력입니다.
내가 직접 수행한 ollama 모델 스케줄링 테스트
여기에서 저는 새로운 버전의 Ollama가 모델에 얼마나 많은 VRAM을 할당하는지와 이전 버전의 Ollama를 비교하고 있습니다. 새로운 버전은 오히려 더 나빠졌습니다.
Ollama 개발의 현재 상태에 대한 나의 견해
Ollama은 로컬에서 LLM을 실행하는 도구 중 하나인 가장 인기 있는 도구로 빠르게 부상했습니다. 그것의 단순한 CLI, 그리고 세련된 모델 관리 기능은 클라우드 밖에서 AI 모델로 작업하려는 개발자들에게 필수적인 옵션으로 만들었습니다.
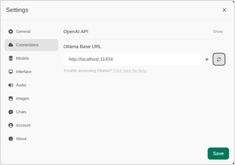
2025년 Ollama의 가장 주목받는 UI에 대한 간략한 개요
로컬에서 호스팅된 Ollama는 자신의 기계에서 대규모 언어 모델을 실행할 수 있게 해주지만, 명령줄을 통해 사용하는 것은 사용자 친화적이지 않습니다.
다음은 로컬 Ollama에 연결되는 **ChatGPT 스타일 인터페이스**를 제공하는 여러 오픈소스 프로젝트입니다.
RAG 구현 중이신가요? 여기 Go 코드 조각이 있습니다 - 2...
표준 Ollama 에는 직접적인 rerank API 가 없으므로, 쿼리 - 문서 쌍에 대한 임베딩을 생성하고 점수를 매기는 방식으로 GO 에서 Qwen3 Reranker 를 사용한 재순위 지정 을 구현해야 합니다.
qwen3 8b, 14b 및 30b, devstral 24b, mistral small 24b
이 테스트에서는 Ollama에 호스팅된 다양한 LLM이 Hugo 페이지를 영어에서 독일어로 번역하는 방식을 비교하고 있습니다. 다른 LLM이 호스팅된 Ollama에서 Hugo 페이지를 영어에서 독일어로 번역하는 방식 비교.
RAG 구현 중이신가요? Golang 코드 스니펫을 소개합니다.
이 작은 Go 코드 예시는 쿼리와 각 후보 문서에 대해 임베딩을 생성하기 위해 Ollama 를 호출합니다 그리고 코사인 유사도 기준으로 내림차순으로 정렬합니다.

Ollama 에서 제공되는 새로운 놀라운 LLM 들
Qwen3 임베딩 및 리랭커 모델 은 Qwen 시리즈의 최신 릴리스로, 고급 텍스트 임베딩, 검색 및 재랭킹 작업을 위해 특별히 설계되었습니다.
LLM을 위해 GPU를 하나 더 설치할 계획이 있으신가요?
PCIe 레인이 LLM 성능에 미치는 영향? 작업에 따라 다릅니다. 학습 및 멀티 GPU 추론의 경우 성능 저하가 상당합니다.
LLM을 사용하여 HTML에서 텍스트 추출...
Ollama 모델 라이브러리에는 HTML 콘텐츠를 Markdown으로 변환할 수 있는 모델이 포함되어 있습니다. 이는 콘텐츠 변환 작업에 유용합니다. 이 가이드는 우리의 2026년 문서화 도구: Markdown, LaTeX, PDF 및 인쇄 워크플로우 허브의 일부입니다.
Cursor AI vs GitHub Copilot vs Cline AI vs...
여기에는 AI 보조 코딩 도구 및 AI 코딩 어시스턴트와 그 장점들을 나열하겠습니다.
인텔 CPU의 효율성 코어 vs 성능 코어에서의 Ollama
제가 테스트하고 싶은 이론은, 인텔 CPU에서 모든 코어를 사용하면 LLM의 속도가 빨라질까?입니다.
새로운 gemma3 27비트 모델(gemma3:27b, ollama에서 17GB)이 제 GPU의 16GB VRAM에 맞지 않아, 부분적으로 CPU에서 실행되고 있다는 점이 제게 짜증을 주고 있습니다.
Ollama의 동시성, 대기열 처리 방식, 그리고 안정적이고 병렬적인 요청을 위해 OLLAMA_NUM_PARALLEL을 조정하는 방법을 이해하세요.
이 가이드는 Ollama가 병렬 요청을 처리하는 방법(동시성, 대기열, 자원 제한)과 OLLAMA_NUM_PARALLEL 환경 변수(및 관련 설정 항목)를 사용하여 이를 조정하는 방법을 설명합니다.