
지식 관리를 위한 AI: 견고한 실제 워크플로우
AI는 지식 관리의 목적을 바꾸는 것이 아니라, 지식 관리 방식을 변화시킵니다.
AI는 지식 관리를 대체하지 않습니다. 대신 개인과 팀 모두에게 지식 관리의 형태를 변화시키고 있습니다.
AI는 지식 관리의 목적을 바꾸는 것이 아니라, 지식 관리 방식을 변화시킵니다.
AI는 지식 관리를 대체하지 않습니다. 대신 개인과 팀 모두에게 지식 관리의 형태를 변화시키고 있습니다.
스타, 토큰, 다운로드 수 — 과연 누가 실제 승자인가?
GitHub에서 오픈소스 AI 에이전트 프레임워크의 인기가 폭발적으로 증가하고 있습니다. 셀프호스팅 AI 시스템 생태계의 핵심에 있는 두 프로젝트인 OpenClaw와 Hermes Agent는 나머지 분야와의 격차를 크게 벌려 두었으며, 나머지 프로젝트들은 멀리 떨어진 3위를 놓고 경쟁하고 있습니다.
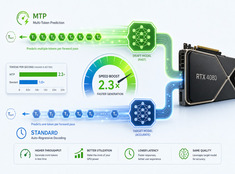
RTX 4080에서 MTP와 표준 디코딩 비교 — 실제 벤치마크
Qwen 3.6 27B와 35B 모델에서 RTX 4080 16 GB VRAM 환경의 스펡추레이티브 디코딩(Speculative decoding, Multi-Token Prediction, MTP) 성능을 테스트했습니다.
llama-server를 종료하지 않고도 VRAM을 확보하는 방법
llama.cpp 라우터 모드는 수년 동안 llama-server에 도입된 변화 중 가장 유용한 변화 중 하나입니다. 이는 로컬 LLM 운영자에게 Ollama에서 기대하는 모델 관리 경험에 가까운 기능을 제공하면서도, llama.cpp를 처음부터 사용하게 만드는 원시 성능과 저레벨 제어를 그대로 유지합니다.
AI 시스템을 위한 컴파일된 지식
전제는 간단합니다. 컴파일된 지식은 검색된 단편보다 재사용성이 높습니다. RAG는 직관적인 질문—LLM에게 외부 지식을 어떻게 접근하게 할 것인가?—에 대한 기본 답변이 되었습니다.
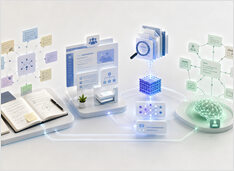
현대 지식 시스템의 지도
PKM, RAG, 위키, AI 메모리 시스템, 그리고 최근 실용적인 AI 지원 워크플로우가 종종 동일한 문제를 해결하는 것처럼 논의됩니다. 하지만 그렇지 않습니다. 이들은 모두 지식과 관련되어 있지만, 서로 다른 계층에서 작동합니다:
느낌에 의존한 해석을 중단하고, 계약서를 검증하십시오.
대부분의 대규모 언어 모델(LLM) ‘구조화된 출력(structured output)’ 튜토리얼은 진지하지 않습니다. 이들은 사용자에게 정중하게 JSON을 요청한 후 모델이 잘 작동하기를 바라고 만듭니다. 그것은 검증(validation)이 아닙니다. 그것은 중괄호를 사용한 낙관주의에 불과합니다.
에이전틱 LLM 튜닝 참고 자료
이 페이지는 에이전트형 LLM 추론 튜닝에 대한 실용적인 참고 자료입니다(temperature, top_p, top_k, penalties 및 다단계 및 도구 중심 워크플로우에서의 상호 작용 방식).
전화기에서 헤르메스와 대화하세요
이미 스마트폰으로 텍스트를 통해 헤르메스 에이전트(Hermes Agent)와 대화를 나누고 계실텐데요. 이제 직접 말로 소통하고 음성으로 답변을 받아보시는 게 좋습니다. 특히 헤르메스를 영구적인 자체 호스팅 어시스턴트로 사용하고 계신다면 이는 가장 올바른 선택입니다. 작은 화면에서 긴 프롬프트를 입력하는 것은 느리고 실수가 발생하기 쉽기 때문입니다.
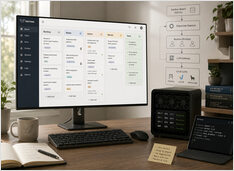
자체 호스팅 LLM에서 Hermes 카んばん 부하를 제어하세요.
Hermes Agent는 칸반 스타일의 보드와 Hermes Gateway를 함께 제공하며, 너무 많은 작업이 한 번에 배포되면 자체 호스팅 LLM을 포화 상태로 만들 수 있습니다.
저자 헤르메스 - 빠르게 로드되고 신뢰성 있게 작동하는 스킬
Hermes Agent는 반복 가능한 워크플로우를 가르치는 기본 방법으로 스킬을 취급합니다. 공식 문서는 스킬을 agentskills.io의 오픈 형식과 일치하는 온디맨드 지식 문서로 설명하며, 모델이 먼저 작은 인덱스를 보고 작업이 실제로 필요할 때만 전체 지침을 가져오도록 점진적 공개를 통해 로드됩니다.
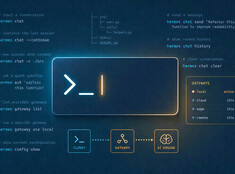
셀프 호스팅된 Hermes 에이전트를 위한 셸 및 TUI 명령어
Nous Research의 Hermes Agent는 모델에 구애받지 않고, 도구를 활용하는 로컬 또는 VPS에서 실행할 수 있는 어시스턴트입니다.
NemoClaw을 사용하여 OpenClaw를 안전하게 실행하세요
대부분의 AI 에이전트 스택은 보안 문제를 데모 이후의 수정 사항으로 취급합니다. NemoClaw은 정반대의 가정에서 출발하며, 격리, 정책 및 라우팅을 초기부터 기본값으로 설정합니다.
단일 채팅 스레드를 넘어 지속되는 지식
이 섹션은 AI 시스템의 영속적 지식과 기억에 대한 가이드를 모아놓은 곳입니다 — 어시스턴트가 모든 토큰을 하나의 프롬프트에 집어넣지 않고도 세션 간에 사실, 선호 사항, 정제된 맥락을 유지하는 방법을 다룹니다. 여기에서 기억은 GPU RAM이나 모델 가중치가 아니라, 의도적인 보존(사용자 사실, 요약, 플러그인 기반 스토어)을 의미합니다.
캐처 정책이 리콜과 같은 중요성을 가지게 되었다.
2026년 9월 업데이트: Mnemosyne 및 Memori 추가, Honcho와 Hindsight 설정 확장, 기존 인프라 표와 함께 캡처 정책 비교표 추가.
메모리는 도구가 아닌 파트너를 만드는 차이점입니다.
AI 에이전트와 채팅을 시작하고, 프로젝트를 설명하고, 선호 사항을 공유하고, 작업을 마친 후 탭을 닫는 장면을 익히 보셨을 것입니다. 일주일 후 다시 돌아오면 마치 처음 만난 사람과 대화하듯 모든 컨텍스트가 사라지고, 모든 선호 사항이 잊혀 있으며, 프로젝트가 처음부터 다시 설명되어야 하는 상황이 됩니다.