Installa Oh My Opencode e rilascia più velocemente.
Oh My Opencode trasforma OpenCode in un harness per la programmazione multi-agente: un orchestratore assegna il lavoro ad agenti specializzati che si eseguono in parallelo.
Test di OpenCode LLM — statistiche su codifica e accuratezza
Ho testato come funziona OpenCode con diversi LLM ospitati localmente su Ollama e llama.cpp, e per confronto ho aggiunto alcuni modelli gratuiti da OpenCode Zen.
OpenHands è una piattaforma open-source, agnostica rispetto al modello, per agenti di sviluppo software guidati dall’IA.
Permette a un agente di comportarsi più come un partner di programmazione che come un semplice strumento di autocompletamento.
Esegui API compatibili con OpenAI in locale con LocalAI in pochi minuti.
LocalAI è un server di inferenza self-hosted e local-first progettato per comportarsi come un’API OpenAI plug-and-play per eseguire carichi di lavoro di IA sull’hardware proprio (laptop, workstation o server in locale).
llama.cpp è un motore di inferenza in C/C++ per modelli GGUF: llama-cli per la chat interattiva, llama-completion per prompt scriptizzati e llama-server per un’API HTTP compatibile con OpenAI.
L’Intelligenza Artificiale sta ridisegnando il modo in cui il software viene scritto, revisionato, implementato e mantenuto. Dagli assistenti di coding AI all’automazione GitOps e ai workflow DevOps, gli sviluppatori fanno ormai affidamento su strumenti alimentati dall’AI in tutte le fasi del ciclo di vita del software.
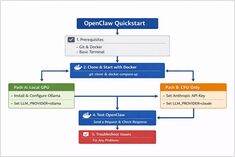
Come installare, configurare e utilizzare OpenCode
OpenCode è un agente di coding AI open source che puoi eseguire nel terminale (TUI + CLI), con interfacce desktop e IDE opzionali. Questa è la Guida rapida di OpenCode: installazione, verifica, connessione a un modello/provider ed esecuzione di flussi di lavoro reali (CLI + API).
L’inferenza LLM sembra “un altro API” — fino a quando i picchi di latenza, le code si ingorgano e le tue GPU rimangono al 95% di memoria senza una spiegazione ovvia.
Temporal è un motore di workflow open-source di livello enterprise che consente agli sviluppatori di creare applicazioni di workflow durevoli, scalabili e tolleranti ai guasti utilizzando linguaggi di programmazione familiari come Go.
Strategia di osservabilità end-to-end per l'inferenza dei modelli linguistici di grandi dimensioni (LLM) e le applicazioni basate su LLM
I sistemi LLM falliscono in modi che il monitoraggio tradizionale delle API non riesce a rilevare: le code si riempiono in silenzio, la memoria GPU si satura molto prima che la CPU appaia occupata e la latenza esplode a livello di batching anziché a livello dell’applicazione.
Metriche, dashboard, log e allarmi per sistemi di produzione — Prometheus, Grafana, Kubernetes e workload AI.
Osservabilità è la base dei sistemi di produzione affidabili.
Senza metriche, dashboard e allarmi, i cluster Kubernetes si degradano silenziosamente, i carichi di lavoro AI falliscono in silenzio e le regressioni di latenza passano inosservate fino a quando gli utenti non si lamentano.
Dal RAG di base alla produzione: chunking, ricerca vettoriale, reranking e valutazione in un'unica guida.
Production-focused guide to building RAG systems: chunking, vector stores, hybrid retrieval, reranking, evaluation, and when to choose RAG over fine-tuning.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.