Security

Cicli di memoria auto-rinforzanti negli agenti IA: cause e soluzioni

Cicli di memoria auto-rinforzanti negli agenti IA: cause e soluzioni

Quando le conclusioni ricordate diventano nuove prove.

La memoria persistente trasforma un agente da uno strumento che va spiegato ogni volta in uno che porta avanti il contesto — ma apre a una modalità di fallimento evitata dalla chat senza stato: un’interpretazione può diventare memoria, essere recuperata come fatto e giustificare una versione più forte di sé stessa.
Data Gravity: il vero costo della AI API-First

Data Gravity: il vero costo della AI API-First

Perché il vostro stack AI diventa sempre più appiccicoso ogni mese.

Ogni chiamata API sembra una semplice transazione - finché non si accumulano abbastanza da far sì che i dati di fine-tuning, gli harness di valutazione e gli schemi degli strumenti siano tutti modellati attorno a un singolo vendor, e cambiare diventi altro che una modifica al routing.

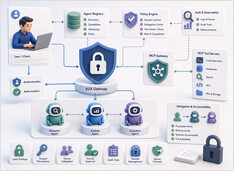
Sicurezza degli agenti A2A e MCP: identità, delega e audit trail

Sicurezza degli agenti A2A e MCP: identità, delega e audit trail

La sicurezza del protocollo riguarda chi può agire, non il modello.

L’iniezione di prompt riceve la maggior parte dell’attenzione in termini di sicurezza nei sistemi LLM e merita attenzione, ma non è l’unico problema una volta che gli agenti iniziano a chiamare strumenti e a delegare il lavoro ad altri agenti.

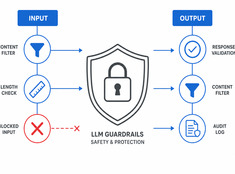
Guard-rails per LLM nella Pratica: Cosa Funziona Davvero

Guard-rails per LLM nella Pratica: Cosa Funziona Davvero

Controlla il rischio, non solo il modello.

I LLM sono imprevedibili. Hallucinate, perdono dati, generano contenuti dannosi o rifiutano richieste legittime. I guardrails (meccanismi di sicurezza) vincolano il comportamento del modello senza sacrificare le sue capacità.