I plugins SEO per WordPress aggiungono metadati, mappe del sito, schema e un livello AI sopra il core di WordPress, e nel 2026 quel livello include plugin che eseguono inferenza sul proprio hardware.
Le piattaforme SEO self-hosted coprono ora crawler, dashboard di Search Console, strumenti di monitoraggio delle posizioni, server MCP e IA locale. Questa guida confronta le principali piattaforme open source e quali funzionalità sono disponibili senza API SEO a pagamento.
Deep Research è diventato una categoria software a sé stante, e non è più soltanto un modello indirizzato verso una casella di ricerca. Questo articolo confronta dodici sistemi self-hosted e le architetture di ricerca che li sottendono.
Ollama e llama.cpp vengono spesso confrontati come se fossero motori di inferenza rivali. La scelta reale è tra un servizio di modelli gestito e un toolkit che si opera direttamente.
ROCm e Vulkan accelerano entrambe le GPU AMD per l’hosting locale di LLM, ma non sono intercambiabili. La scelta giusta dipende dal motore, dalla GPU e dal carico di lavoro.
Un modello può pubblicizzare una finestra di contesto da 128K eppure fallire a 40K token su una GPU da 16 GB. Il limite architetturale non ha mai promesso che pesi, KV cache, buffer di calcolo e il compositor desktop potessero coesistere sulla stessa scheda.
Perché il vostro stack AI diventa sempre più appiccicoso ogni mese.
Ogni chiamata API sembra una semplice transazione - finché non si accumulano abbastanza da far sì che i dati di fine-tuning, gli harness di valutazione e gli schemi degli strumenti siano tutti modellati attorno a un singolo vendor, e cambiare diventi altro che una modifica al routing.
Ollama è uno dei modi più semplici per eseguire un modello linguistico locale, ma la praticità può nascondere il momento in cui un esperimento locale diventa un servizio di inferenza condiviso che richiede una migliore pianificazione e osservabilità.
Vane è una delle opzioni più pragmatiche nell’ambito della “ricerca AI con citazioni”: un motore di risposta self-hosted che combina il recupero live dal web con LLM locali o cloud, mantenendo l’intero stack sotto il vostro controllo.
Ollama è al suo meglio quando viene trattato come un demone locale: la CLI e le tue applicazioni comunicano con un’API HTTP su loopback, e il resto della rete non viene a sapere della sua esistenza.
Server Ollama con priorità alla configurazione, GPU e persistenza.
Ollama funziona egregiamente su hardware nativo. Diventa ancora più interessante quando lo si tratta come un servizio: un endpoint stabile, versioni bloccate, storage persistente e una GPU che o è disponibile o non lo è.
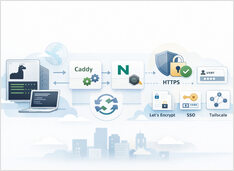
HTTPS per Ollama senza interrompere le risposte in streaming.
Eseguire Ollama dietro un proxy inverso è il modo più semplice per ottenere HTTPS, un controllo degli accessi opzionale e un comportamento di streaming prevedibile.
Se stai approfondendo la generazione potenziata dal recupero (RAG), questa sezione illustra le embeddings testuali in termini semplici: cosa sono, come si integrano nella ricerca e nel recupero, e come invocare due configurazioni locali comuni da Python utilizzando Ollama o un’API HTTP compatibile con OpenAI (come espongono molti server basati su llama.cpp).
Test di OpenCode LLM — statistiche su codifica e accuratezza
Ho testato come funziona OpenCode con diversi LLM ospitati localmente su Ollama e llama.cpp, e per confronto ho aggiunto alcuni modelli gratuiti da OpenCode Zen.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.