API

Web Framework Go nel 2026: confronto tra net/http, chi, Gin, Echo e Fiber

Web Framework Go nel 2026: confronto tra net/http, chi, Gin, Echo e Fiber

Cinque stack Go HTTP, un unico banco di prova, numeri reali.

Go include un server HTTP di livello production nella sua libreria standard, e dal Go 1.22 il router integrato gestisce da solo l’abbinamento dei metodi e i parametri del percorso. La questione relativa ai framework non è scomparsa, ma si è ristretta.

Da Ollama a vLLM: quando migrare il proprio server LLM locale

Da Ollama a vLLM: quando migrare il proprio server LLM locale

Quando passare da Ollama a vLLM

Ollama è uno dei modi più semplici per eseguire un modello linguistico locale, ma la praticità può nascondere il momento in cui un esperimento locale diventa un servizio di inferenza condiviso che richiede una migliore pianificazione e osservabilità.

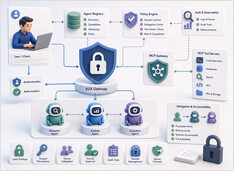
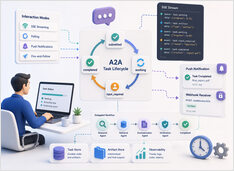
Sicurezza degli agenti A2A e MCP: identità, delega e audit trail

Sicurezza degli agenti A2A e MCP: identità, delega e audit trail

La sicurezza del protocollo riguarda chi può agire, non il modello.

L’iniezione di prompt riceve la maggior parte dell’attenzione in termini di sicurezza nei sistemi LLM e merita attenzione, ma non è l’unico problema una volta che gli agenti iniziano a chiamare strumenti e a delegare il lavoro ad altri agenti.

L'idempotenza nei sistemi distribuiti che funziona davvero

L'idempotenza nei sistemi distribuiti che funziona davvero

Evita effetti collaterali duplicati

L’idempotenza nei sistemi distribuiti è la proprietà che ti salva quando la rete mente, la coda ritenta, il client va in panico e l’operatore preme “ripeti”. Nei sistemi di produzione, la consegna duplicata è la norma. Gli effetti collaterali duplicati sono il bug.

Vane (Perplexica 2.0) Guida introduttiva con Ollama e llama.cpp

Vane (Perplexica 2.0) Guida introduttiva con Ollama e llama.cpp

Ricerca AI self-hosted con LLM locali

Vane è una delle opzioni più pragmatiche nell’ambito della “ricerca AI con citazioni”: un motore di risposta self-hosted che combina il recupero live dal web con LLM locali o cloud, mantenendo l’intero stack sotto il vostro controllo.

llama.cpp: avvio rapido con CLI e Server

llama.cpp: avvio rapido con CLI e Server

Come installare, configurare e utilizzare OpenCode

Continuo a tornare a llama.cpp per l’inferenza locale: offre un livello di controllo che Ollama e altri strumenti astraggono, e funziona semplicemente. È facile eseguire modelli GGUF in modo interattivo con llama-cli o esporre un’API HTTP compatibile con OpenAI con llama-server.

Airtable per sviluppatori e DevOps - Piani, API, Webhook e esempi in Go/Python

Airtable per sviluppatori e DevOps - Piani, API, Webhook e esempi in Go/Python

Airtable - Limiti del piano gratuito, API, webhooks, Go & Python.

Airtable è meglio considerata come una piattaforma low-code costruita intorno a un’interfaccia collaborativa “simile a un foglio di calcolo” - ideale per creare rapidamente strumenti operativi (tracciatori interni, CRM leggeri, pipeline di contenuti, code di valutazione AI) dove gli sviluppatori non devono un’interfaccia amichevole, ma gli sviluppatori necessitano anche di un’API per l’automazione e l’integrazione.