
Hindsight per Hermes Agent: memoria self-hosted con LLM locali
Memoria persistente di Hermes sul tuo hardware.
Un agente AI self-hosted ha bisogno di più di una finestra di contesto lunga. Ha bisogno di un modo per ritenere fatti utili, recuperare decisioni precedenti e rivedere ciò che crede di sapere man mano che i progetti evolvono.
Hermes Agent include file di memoria integrati, ma un provider esterno può fornire un recupero molto più ricco tra le sessioni. Hindsight è una delle opzioni più interessanti in questo ambito. Questa guida lo installa per Hermes senza inferenza cloud, prima come contenitore Docker tutto-in-uno e quindi contro un server PostgreSQL esistente con endpoint di modelli locali separati.
La guida copre il deploy, la scelta e il collegamento di modelli locali per embedding, reranking e generazione, il controllo di ciò che auto-retain scrive nella banca dati, il collegamento di Hermes e il livello operativo: backup, migrazione e manutenzione quotidiana della banca. Gli esempi usano una schema di porte deliberata — 8080 per il principale server llama.cpp, 8081 per gli embedding, 8082 per il reranking, 11434 per Ollama — quindi cambia questi valori con le porte che utilizzi già e tieni i piccoli server lontani dalla porta del modello principale.
Cosa fa Hindsight
Hindsight è un motore di memoria persistente per agenti con tre operazioni principali: retain, recall e reflect. Retain estrae e memorizza informazioni; recall combina recupero semantico, per parole chiave, a grafo e temporale; reflect sintetizza una risposta dalle memorie accumulate. La consolidazione in background può trasformare osservazioni sovrapposte in un livello di conoscenza più utile.
Non è solo un database di embedding. Un vettore store può localizzare passaggi simili, ma un sistema di memoria deve anche preservare la cronologia, i confini dei progetti, le prove contraddittorie e i cambiamenti nelle decisioni. Queste modalità di guasto sono esplorate in cicli di memoria auto-rafforzanti.
Per il mercato più ampio, vedi provider di memoria per agenti confrontati. La MEMORY.md, USER.md e le modalità di memoria integrate di Hermes sono coperte nella guida del Sistema di memoria dell’agente Hermes, quindi questo articolo presuppone che tu sappia come funziona il livello integrato.
Perché andare oltre Mnemosyne
Mnemosyne per Hermes offre idee locali prima di tutto interessanti, incluso lo storage SQLite e il recupero ibrido. Nella pratica, vincoli di installazione, compatibilità delle versioni, comportamento di approvazione della scrittura e rapidi cambiamenti intorno alle prerelease 4.0 possono renderlo difficile da gestire in modo prevedibile. Queste sono preoccupazioni operative, non la prova che il modello di memoria di Mnemosyne sia fondamentalmente difettoso.
Hindsight non è privo di dipendenze: la sua immagine Docker e i modelli locali possono consumare molto spazio su disco. Eseguire la sua API come servizio indipendente, con l’inferenza altrove, mantiene aggiornamenti e risoluzione dei problemi isolati dall’agente stesso.
Scegli un Deploy
| Componente | A: Contenitore tutto-in-uno | B: Server PostgreSQL esistente |
|---|---|---|
| API e UI di Hindsight | Contenitore Docker | Contenitore Docker |
| PostgreSQL | pg0 incorporato nel contenitore |
Macchina PostgreSQL esistente |
| LLM generativo | llama.cpp esterno | llama.cpp esterno |
| Embedding | Locale predefinito o esterno | Ollama o llama.cpp esterno |
| Reranking | Locale predefinito o esterno | Server di reranking esterno |
| Ideale per | Valutazione rapida | Installazione a lungo termine, isolata |
Qui, “tutto-in-uno” significa che l’API, la UI e il database di Hindsight sono in un unico contenitore; il LLM generativo per inferenza è ancora ospitato altrove. Questo è intenzionale: l’immagine ufficiale Docker di Hindsight non include un server llama.cpp generativo locale pronto all’uso.
Usa indirizzi raggiungibili in LAN, non localhost, per i servizi in esecuzione su un host diverso. Limita queste porte a client fidati; le chiavi dummy nell’esempio sono segnaposto di compatibilità, non autenticazione.
Opzione A: Contenitore Hindsight Tutto-in-Uni
Questo è il modo più semplice per valutare Hindsight senza riempire la VM di Hermes con Python, Torch e dipendenze di modelli locali. Il contenitore esegue Hindsight e PostgreSQL incorporato, mentre il tuo LLM llama.cpp principale gestisce l’estrazione e la riflessione della memoria.
Due tag di immagine sono importanti qui. ghcr.io/vectorize-io/hindsight:latest è l’immagine grande — circa 9 GB su AMD64 — perché include un embedder BGE, un reranker MiniLM e PostgreSQL incorporato. latest-slim è circa 500 MB e si aspetta che questi due modelli siano altrove, che è ciò che vuoi una volta che punti Hindsight alla configurazione di embedding e reranking in “Serve e Collega Modelli Locali”. Una volta superato il controllo di salute, fissa un tag specifico: un tag in movimento è una cattiva scelta per un database che intendi mantenere.
Crea una directory e un file Compose sull’host di Hindsight:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # API Memoria
      - "9999:9999"  # UI Control Plane
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Sostituisci WORKSTATION_IP con l’host che esegue llama.cpp. Su Linux, host.docker.internal si risolve solo se il contenitore dichiara il mapping host-gateway mostrato sopra; senza di esso, un URL base http://host.docker.internal:8080/v1 punta nel vuoto. La prenotazione di 1 GB di memoria condivisa è particolarmente utile per l’indicizzazione di PostgreSQL incorporato; il piccolo /dev/shm predefinito di Docker può causare fallimenti. Un volume denominato preserva il database quando il contenitore viene ricreato, e un’alternativa con bind mount deve essere di proprietà di uid 1000, l’utente all’interno dell’immagine.
HINDSIGHT_API_WORKER_ID dovrebbe restare stabile tra le ricreazioni — il predefinito di Docker è il nome host del contenitore, e un task che era in corso quando il contenitore è morto resta bloccato sotto il vecchio worker id.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Se la tua versione installata di Hindsight espone la salute su un percorso diverso, ispeziona http://localhost:8888/docs e i log del contenitore. Il piano di controllo è normalmente disponibile su http://HINDSIGHT_HOST:9999. Una volta che il deploy di base funziona, puoi anche puntare i suoi provider di embedding e reranking alla configurazione in “Serve e Collega Modelli Locali” anziché caricare i modelli predefiniti all’interno del contenitore.
Non esporre le porte 8888 o 9999 direttamente su Internet. Usa una rete privata o un reverse proxy autenticato. PostgreSQL incorporato è comodo per i test, ma un database gestito esternamente è più facile da backup e mantenere.
Opzione B: Hindsight Contro un Server PostgreSQL Esistente
Per un’installazione a lungo termine, preferisco mantenere API di Hindsight, database e endpoint di inferenza separati. La VM di Hindsight può restare piccola perché esegue servizi di orchestrazione e HTTP anziché modelli pesanti.
Prepara PostgreSQL e pgvector
Hindsight richiede PostgreSQL 14 o più recente e un’estensione vettoriale nel database hindsight. L’estensione è per database: installare il pacchetto sul server non fa nulla finché CREATE EXTENSION non viene eseguito lì. Su un server PostgreSQL Debian o Ubuntu, installa il pacchetto pgvector corrispondente alla versione maggiore effettiva di PostgreSQL; per esempio, su PostgreSQL 16:
sudo apt update
sudo apt install postgresql-16-pgvector
Il nome e la disponibilità del pacchetto dipendono dai tuoi repository apt configurati. Se non è disponibile, segui le istruzioni per l’installazione di pgvector, oppure installa un pacchetto compatibile dal repository PGDG di PostgreSQL. Non cambiare acriticamente la versione maggiore di PostgreSQL su un server condiviso.
Crea un ruolo e un database dedicati come amministratore PostgreSQL:
CREATE ROLE hindsight LOGIN PASSWORD 'SOSTITUISCI_CON_PASSEPAROLA_LUNGA';
CREATE DATABASE hindsight OWNER hindsight;
Connettiti al nuovo database e abilita l’estensione:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname = 'vector';"
L’estensione normalmente ha bisogno di privilegi elevati per essere installata; il ruolo dell’applicazione non deve essere un superuser. Hindsight usa pgvector per impostazione predefinita e desidera 0.8.0 o più recente per scansioni ANN iterative; i server più vecchi rifiutano quella configurazione. HINDSIGHT_API_VECTOR_EXTENSION può alternativamente selezionare pgvectorscale (un’opzione DiskANN documentata da Hindsight per banche molto grandi) o vchord, entrambi i quali richiedono packaging extra su questa esatta build di PostgreSQL. Cambiare algoritmi dopo che esistono memorie ferma l’avvio e chiede una migrazione, quindi scegli prima del primo retain. Per una banca personale di Hermes, pgvector è quello da installare e poi smettere.
Consenti solo l’host di Hindsight attraverso pg_hba.conf, per esempio:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Imposta listen_addresses di PostgreSQL in modo appropriato e usa TLS o una rete privata fidata per le connessioni tra host. Effettua il backup di questo database indipendentemente dal contenitore Docker di Hindsight. Se il server è condiviso con altre applicazioni, tieni Hindsight nel suo own database, oppure imposta HINDSIGHT_API_DATABASE_SCHEMA su uno schema che possiedi; lo schema predefinito è public.
Esegui Hindsight Contro PostgreSQL
Crea compose.yaml sulla VM di Hindsight. Questa versione non avvia deliberatamente PostgreSQL in locale:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Conserva l’URL del database esterno in un file chiamato .env:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:TUA_PASSEPAROLA@POSTGRES_IP:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Se la tua password contiene @, :, / o altri caratteri URL riservati, codificala in URL prima di metterla nella stringa di connessione. Testa che la VM di Hindsight possa raggiungere la porta 5432 di PostgreSQL e che pg_hba.conf consenta l’host di Hindsight — un server legato solo a 127.0.0.1 rifiuta la connessione anche quando l’URL sembra giusto. Consenti al primo avvio di eseguire le migrazioni del database; le migrazioni si avviano all’avvio a meno che tu non imposti HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Con API e database attivi, continua con Scegli Modelli per Hindsight e Serve e Collega Modelli Locali prima di collegare Hermes.
Scegli Modelli per Hindsight
Deploy mette l’API e il database sulla rete. La decisione successiva è quali modelli riempiono i tre ruoli di inferenza: embedding per i candidati di recall, un reranker per riordinarli e un LLM generativo per retain, reflect e consolidamento. Un predefinito pratico per un host Hindsight CPU la cui GPU è già occupata con la conversazione è Qwen/Qwen3-Embedding-0.6B in-processo, BAAI/bge-reranker-v2-m3 in-processo e un modello chat llama.cpp condiviso per il lavoro generativo.
Modelli di embedding
Hindsight legge la dimensione dell’embedding all’avvio e dimensiona la banca di conseguenza, quindi il modello che scegli al primo retain è il modello che la banca mantiene finché non la ricostruisci. La dimensionalità e il comportamento delle istruzioni contano più della posizione nella classifica: un embedder 8B più forte non vale una migrazione se la banca è già una a 384 o 1024 dimensioni. Le righe sottostanti sono ordinate da più leggero a più pesante; le figure di RAM sono approssimative per l’impronta caricata su CPU (FP16 / caricamento locale tipico), non la dimensione del file GGUF.
| Modello | Parametri | Dim | Contesto | Caricato | Esegue su | Note |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Predefinito Hindsight; incluso in hindsight:latest. Percorso locale più veloce. La distribuzione dei punteggi calibra ancora molti predefiniti recall_min_scores dopo averlo lasciato. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | BGE inglese di fascia media; blocca una banca a 768 dim. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | MiniLM multilingue documentato da Hindsight; 50+ lingue alla stessa larghezza di banca 384-dim di BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | Predefinito per il provider onnx; percorso CPU multilingue leggero quando hai un’export ONNX. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | Embedder Ollama comune; contesto più lungo del BGE classico, ancora incentrato sull’inglese. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 solo testo (disabilita torri vision/audio). 100+ lingue + codice; MRL tronca a 512/256/128; prefissi di istruzioni per ricerca vs documento. Il caricamento multimodale completo è 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPU o GPU | Forte dual-encoder multilingue; stessa larghezza di Qwen3-0.6B, quindi uno scambio di stessa dimensione richiede comunque un re-embed completo. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | Il predefinito di questa guida. Consapevole delle istruzioni (istruzione di ricerca sul lato query); comodo su CPU. Il provider locale applica automaticamente l’istruzione; i server OpenAI-compatibili hanno bisogno di HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB quant | GPU | Tier di qualità Qwen3; blocca una banca a 2560 dim. Non fattibile quando la GPU conversazionale è già satura. |
Come viene eseguito il modello è l’altra metà della scelta. I provider di embedding di Hindsight, dal più semplice al più complesso:
| Provider | Come viene eseguito | Migliore quando | Note |
|---|---|---|---|
local |
SentenceTransformers in-processo; nessun sidecar | Singolo host Hindsight, embedder CPU | Percorso predefinito. Imposta HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Nessun llama.cpp, Ollama o TEI. |
onnx |
ONNX Runtime in-processo | CPU più leggera di Torch; hai già un’export ONNX | Richiede hindsight-api-slim[local-onnx] e HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Endpoint esterno OpenAI-compatibile o HF TEI | Embedding fuori dal processo API; host GPU/CPU condiviso | Ciò che “Serve e Collega Modelli Locali” configura per Ollama / llama.cpp / TEI. Vale il sidecar solo se vuoi isolamento o una macchina diversa. |
Qwen3-Embedding-0.6B non ha bisogno di un servizio di embedding esterno. Su un host Hindsight CPU si carica nel processo API con il provider local — Hugging Face scarica i pesi al primo avvio e il provider applica l’istruzione di ricerca del modello stesso:
# Ambiente Compose (o chiavi .env equivalenti)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Usa un endpoint esterno OpenAI-compatibile solo se vuoi l’embedder su un’altra macchina o fuori dal processo API. Ollama è uno di questi host:
# Embedding: Qwen3-Embedding-0.6B su Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Sostituisci host, porta e tag con ciò che mostra ollama list sulla tua macchina di inferenza.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX dipende dal provider:
| Percorso | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Lascia non impostato / vuoto — il provider in-processo applica l’istruzione di ricerca di Qwen stesso | Lascia non impostato / vuoto |
| Ollama / llama.cpp / OpenAI-compatibile esterno | Istruzione di recupero ufficiale Qwen3 (carattere di nuova riga reale prima di Query:) |
Lascia vuoto — le memorie conservate restano testo grezzo |
| Server che avvolge già gli input nel template di Qwen | Lascia entrambi vuoti — altrimenti l’istruzione viene applicata due volte | Lascia vuoto |
Per il percorso esterno, imposta:
# Carattere di nuova riga reale prima di Query:. Bash $'...' è il modo affidabile per passarlo.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
Nel Compose YAML la stessa stringa ha bisogno di un \n esplicito (o un valore multilinea letterale). Imposta i prefissi prima del primo retain: cambiarli in seguito significa che i vecchi vettori e le nuove query non stanno più nello stesso spazio.
Due proprietà decidono più della posizione nella classifica. Sensibilità alle istruzioni: gli embedding Qwen3 applicano un’istruzione di ricerca sul lato query; senza il prefisso corrispondente su un server OpenAI-compatibile, il lato memorizzato e il lato query smettono di stare nello stesso spazio. Blocco dimensionale: perché la larghezza viene letta una volta all’avvio, il passaggio da 0.6B a 4B in seguito è una migrazione della banca, non un cambio di configurazione — e persino uno scambio di stessa dimensione (BGE-M3 ↔ Qwen3-0.6B, o EmbeddingGemma 2 ↔ nomic a 768) cambia lo spazio vettoriale, quindi i vettori della banca non vengono ricompilati automaticamente. Pianifica una banca nuova o un re-embed/reindex manuale; vedi Esporta, importa e migra la banca di memoria. Dopo aver lasciato BGE-small, prova recall_min_scores contro la nuova distribuzione dei punteggi — le soglie calibrate su BGE-small possono essere troppo strette per Qwen3-0.6B e affamare il reranker di candidati. Per benchmark e contesto GGUF/Ollama sulla famiglia Qwen3, vedi Modelli Qwen3 Embedding e Reranker su Ollama.
Modelli di reranking
Gli embedding recuperano un set di candidati; il reranker scores ogni coppia query/passage e la riordina prima che Hindsight la inietti. Con il provider local, Hindsight carica un cross-encoder SentenceTransformers (o un reranker generativo dove supportato). Con un endpoint esterno Cohere-compatibile, posta il corpo completo stile-Cohere su HINDSIGHT_API_RERANKER_COHERE_BASE_URL. Il reranker è opzionale, ma una volta fissato l’embedder è spesso la leva più grande per la qualità del recall — e, su CPU, spesso la maggior parte del tempo reale di recall. Le righe sono ordinate da più leggero a più pesante.
| Modello | Parametri | Tipo | Contesto | Esegue su | Note |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Cross-encoder | 128 | CPU | Predefinito Hindsight; incluso in hindsight:latest. Sotto-il- secondo per ~20 candidati. Mantieni come fallback nominato se un modello BGE più pesante è troppo lento. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Cross-encoder | 512 | CPU | Stessa famiglia, precisione più alta; ancora incentrato su MS MARCO inglese. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Cross-encoder | 512 | CPU | Reranker MiniLM multilingue documentato da Hindsight. |
BAAI/bge-reranker-base |
278M | Cross-encoder | 512 | CPU | Aggiornamento moderato rispetto a MiniLM; en/zh. Discusso spesso; saltato quando v2-m3 sta già nel budget di latenza. |
BAAI/bge-reranker-v2-m3 |
568M | Cross-encoder | 8k | CPU o GPU | Predefinito multilingue pratico su CPU. Su una banca di ~500 memorie, ~2,6–2,8 s per recall a un minimo di 20 candidati (~140 ms/candidato; ~93–99% del tempo di recall). Limiti candidati 20/40/80; abbassare il minimo da 20 → 10 dimezza circa il costo di rerank. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Generativo (token yes) | 32k | GPU preferito | Consapevole delle istruzioni, contesto lungo. Non è un cross-encoder drop-in: richiede supporto generative-reranker recente di SentenceTransformers e lo scoring llama.cpp /rerank ha bug di punteggi errati noti (hindsight-benchmarks#11). Convalida prima di adottare. |
BAAI/bge-reranker-v2-gemma |
2.5B | Cross-encoder | 8k | GPU preferito | Forti qualità multilingue; eccessivo per una banca personale di poche centinaia di memorie quando la GPU è già piena. |
Qwen/Qwen3-Reranker-4B |
4B | Generativo | 32k | GPU | Candidato Qwen di qualità superiore; non fattibile senza VRAM dedicata. |
Qwen/Qwen3-Reranker-8B |
8B | Generativo | 32k | GPU | Top tier della famiglia; stesse avvertenze di scoring generativo, ancora più grande. |
I reranker di API cloud (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe, e simili) funzionano in Hindsight ma inviano il testo di memoria fuori dalla scatola. Per un layout locale-only interdominante sono fuori portata.
Due vincoli operativi dominano la scelta. VRAM: se il modello conversazionale satura già la GPU (per esempio un Qwen3.8-27B Q5 su una scheda da 16 GB senza margine), ogni riga “GPU preferito” è fuori discussione e la scelta live si riduce a MiniLM o BGE-v2-m3 su CPU. Numero di candidati: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 nell’esempio di endpoint esterno qui sotto) limita quanti passaggi il modello ri-scorea; ogni candidato è un passaggio forward completo, quindi taglia il minimo prima di saltare un tier di modello. Per Qwen3 tramite llama.cpp, il GGUF deve mantenere la testa di ranking — un vecchio convert_hf_to_gguf.py che la rimuove scores ogni passaggio vicino allo zero — e persino una conversione corretta richiede un test di passaggio noto-buono/noto-cattivo finché il percorso di scoring generativo non è confermato.
Tier di LLM generativi
I modelli di embedding e reranking non sono sostituti per il LLM generativo usato per estrarre e ragionare sulle memorie. Hindsight supporta un LLM predefinito e sovrascritture specifiche per operazione, che possono puntare allo stesso server llama.cpp o a endpoint indipendenti.
| Operazione Hindsight | Scopo | Tier pratico di modello | Esempi Qwen |
|---|---|---|---|
| Retain | Estrae fatti, entità, decisioni e cronologia | 4B minimo per test; 9B preferito | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Recupero semantico, per parole chiave, grafo e temporale | Nessun LLM generativo richiesto | Qwen3-Embedding-0.6B + reranker |
| Reflect | Risponde a domande sintetizzando memorie recuperate | 9B a 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Consolidamento | Armonizza e comprime fatti correlati | 9B preferito | Qwen3.5-9B / Qwen3.8-27B |
| Aggiornamento modello mentale | Aggiorna comprensione sintetizzata a più lunga durata | 9B a 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Queste sono raccomandazioni operative, non conteggi minimi di parametri ufficiali di Hindsight. Un modello piccolo può estrarre correttamente un numero di porta ma perdere che una decisione architettonica precedente è stata sostituita. L’affidabilità dell’output strutturato e la gestione fedele della negazione contano più del solo conteggio nominale dei parametri. I predefiniti di temperatura di Hindsight stesso vale la pena lasciarli soli — 0.1 per retain, 0.0 per consolidamento, 0.9 per reflect — e per retain e consolidamento, l’alias non-thinking vale la pena di servirlo se la tua build llama.cpp ne ha uno, perché i checkpoint piccoli di Qwen3.5 sprecano molti token in modalità di thinking.
Per un deploy con un endpoint llama.cpp Qwen3.8-27B esistente, inizia condividerlo tra i task generativi di Hindsight con bassa concorrenza:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
In seguito, indirizza l’estrazione di routine a un modello 9B indipendente e riserva il 27B per la riflessione difficile:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://MEMORY_LLM_HOST:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
Il modello 4B più piccolo è economico ma ha bisogno di test; 9B è un compromesso qualità/prestazioni sensato. Se retain e consolidamento condividono un modello piccolo, abbassa HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE a 2 — il batch predefinito di 8 è un prompt lungo per una finestra di contesto piccola. Qwen3.6-35B-A3B è attraente per un server di inferenza separato ben dimensionato (è un modello mixture-of-experts con circa 3 miliardi di parametri attivi, quindi budgetalo come un modello attivo piccolo), mentre un modello denso da 27B è di solito non necessario per ogni evento di retain di routine. Limitare la concorrenza in background protegge il modello conversazionale di Hermes dalle burst di manutenzione della memoria.
Serve e Collega Modelli Locali
Se le impostazioni di embedding e reranker in-processo local in “Scegli Modelli” sono sufficienti, puoi saltare le sottosezioni esterne di Ollama e llama.cpp e saltare al collegamento — o lasciare Compose sui predefiniti local mostrati lì. Gli endpoint esterni contano quando l’embedder o il reranker dovrebbe vivere su un altro host.
Embedding esterni: Ollama o llama.cpp
Gli embedding esterni sono per quando vuoi Qwen3-Embedding-0.6B (o un altro modello) su un host separato. Due opzioni pratiche sono Ollama, che gestisce acquisizione e serving del modello con poca configurazione, e llama.cpp, che dà controllo preciso su quantizzazione GGUF, thread CPU, posizionamento device e batching. Il contesto e i benchmark per entrambi i modelli Qwen3 sono in Modelli Qwen3 Embedding e Reranker su Ollama.
Qwen3-Embedding-0.6B restituisce vettori a 1024 dimensioni e Hindsight legge quella larghezza all’avvio e dimensiona il database di conseguenza. Una banca creata con il modello BGE a 384 dimensioni incluso non può assumere questo modello — parti da un database o volume vuoto e decidi il modello di embedding prima del primo retain. Uno scambio di provider di embedding in seguito richiede il re-embedding dei record conservati anche se entrambi i modelli usano la stessa dimensionalità.
Opzione 1: Ollama per Qwen3-Embedding-0.6B
Installa Ollama sull’host di inferenza usando la sua documentazione ufficiale per l’installazione Linux, quindi avvia il modello di embedding:
ollama pull qwen3-embedding:0.6b
ollama serve
Per l’accesso remoto, configura OLLAMA_HOST=0.0.0.0:11434 nell’ambiente del servizio di Ollama, riavvia il servizio e firewallelo alla VM di Hindsight — la procedura è coperta in Accesso remoto a Ollama. Un daemon legato solo a 127.0.0.1 è invisibile al contenitore di Hindsight. Prima controlla il nome del modello con ollama list e testa l’endpoint standard di embedding:
curl http://EMBED_HOST:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
Il provider di embedding OpenAI di Hindsight invece chiama l’endpoint /v1/embeddings OpenAI-compatibile di Ollama. Verifica che quell’endpoint funzioni con la tua versione di Ollama prima di configurare Hindsight. Ollama è semplice per gli embedding; non dare per scontato che la sua API offra un endpoint di reranking compatibile. Per il reranking, preferisci il percorso local BGE in-processo qui sotto, oppure un endpoint llama.cpp / TEI separato dopo aver convalidato i punteggi.
Opzione 2: llama.cpp per Qwen3-Embedding-0.6B
Scarica una conversione Qwen3-Embedding-0.6B GGUF verificata. Usa il nome file GGUF che hai effettivamente scaricato:
#!/bin/sh
# start-embedding.sh - server di embedding solo CPU
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Gli embedding Qwen3 usano last-token pooling, a differenza del CLS pooling usato da alcuni modelli BGE. Una build llama.cpp solo CPU è preferibile se vuoi assolutamente nessuna inizializzazione CUDA su una workstation la cui GPU è occupata da un grande modello conversazionale. Non abilitare --reranking su questo server di embedding: quella combinazione è un modo noto per ottenere un vettore di zeri.
curl -s http://EMBED_HOST:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
Un output a dimensione completa di Qwen3-Embedding-0.6B dovrebbe contenere 1024 float. Verifica che la conversione GGUF e la tua gestione delle istruzioni query/documento di Hindsight siano compatibili; i modelli di embedding sensibili alle istruzioni possono perdere accuratezza se promptati scorrettamente.
Reranker: BGE locale o Qwen3 tramite llama.cpp
Il reranking è diverso dagli embedding: il modello scores ogni coppia query/documento e restituisce un punteggio di rilevanza. Su un host Hindsight solo CPU — o quando la GPU conversazionale non ha margine VRAM — il percorso pratico è il provider local di Hindsight con BAAI/bge-reranker-v2-m3 (o il predefinito MiniLM più leggero). Non è richiesto un sidecar:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B è uno scorer generativo di token-yes, non un cross-encoder classico. Può essere servito tramite llama.cpp con una conversione GGUF progettata per il ranking, ma considera quel percorso sperimentale finché non confermi i punteggi su una coppia nota-buona/nota-cattiva: un vecchio convert_hf_to_gguf.py che rimuove la testa di ranking scores ogni passaggio vicino allo zero, e il percorso /rerank nativo di llama.cpp ha rapporti noti di punteggi errati per questa famiglia.
#!/bin/sh
# start-reranker.sh - GPU o CPU come selezionato da --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Imposta --n-gpu-layers 0 per eseguirlo su CPU. La versione GPU ha bisogno di VRAM aggiuntiva per buffer di calcolo e contesto, non solo pesi del modello; evita di dare per scontato che la dimensione del file sia l’allocazione totale della GPU.
curl -s http://RERANK_HOST:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
Il documento PostgreSQL dovrebbe essere classificato sopra il documento non correlato; i punteggi di rilevanza tutti a zero significano che il GGUF è la conversione sbagliata, e il recall sembrerà casuale anche quando i fatti sono conservati. Controlla la forma esatta di results[].index e results[].relevance_score: Hindsight si aspetta una risposta di rerank Cohere-compatibile, e la compatibilità llama.cpp può variare tra le build.
Collega gli endpoint a Hindsight
Aggiungi le seguenti impostazioni di ambiente al servizio Compose di Hindsight, oppure conservali nel suo file .env. Scegli un percorso di embedding — local in-processo, Ollama o llama.cpp — mai due alla volta.
# Opzione A: Qwen3 in-processo sull'host di Hindsight (CPU; nessun sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Opzione B: servizio di embedding llama.cpp
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://EMBED_HOST:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opzione C: Ollama su un altro host
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Opzione: reranker BGE locale (nessun sidecar; preferito su CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Opzione: endpoint di rerank Cohere-compatibile llama.cpp (convalida prima i punteggi Qwen3)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://RERANK_HOST:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
I nomi delle variabili sono specifici del provider, e un errore quasi è silenzioso: HINDSIGHT_API_EMBEDDINGS_BASE_URL è la chiave sbagliata e Hindsight punta silenziosamente sull’endpoint di embedding di OpenAI stesso anziché sul tuo server locale. Usa HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. Con il percorso di reranker Cohere-compatibile, Hindsight posta il corpo completo stile-Cohere su HINDSIGHT_API_RERANKER_COHERE_BASE_URL; se il log del contenitore mostra un 404 per /v1/rerank/rerank, la tua build aggiunge /rerank da sola e il valore dovrebbe fermarsi a /v1.
Per le Opzioni B e C, usa il valore di HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX da Modelli di embedding (l’Opzione A lo lascia non impostato). Testa il recupero query-verso-passage sulle tue memorie reali dopo il primo retain.
Controlla Cosa Viene Ricordato
Con lo stack in esecuzione, la modalità di guasto successiva è di solito il percorso di scrittura: Hermes predefinito è auto_retain: true, quindi ogni turno di conversazione può essere estratto nella banca. Congetture errate, piani scartati e affermazioni esplorative diventano fatti ricercabili, e il recall successivo li tratta come prove — il ciclo descritto in cicli di memoria auto-rafforzanti. La politica di acquisizione per Hindsight tra gli altri provider è riassunta in provider di memoria per agenti confrontati.
Modalità di acquisizione che esistono oggi
| Modalità | Impostazioni Hermes / Hindsight | Cosa ottieni |
|---|---|---|
| Continua | auto_retain: true, retain_every_n_turns: 1 |
Ogni turno viene ritenuto ed estratto |
| Auto a batch | auto_retain: true, alza retain_every_n_turns |
Meno, carichi di retain più grandi — ancora automatico, non una coda di revisione |
| Solo esplicito | auto_retain: false + strumento hindsight_retain |
Conservazione solo quando l’agente chiama lo strumento (per esempio dopo che dici “ricorda questo”) |
| Sintesi di sessione | hindsight_retain di fine sessione di un riepilogo, o banca reflect / consolidamento |
Una scrittura curata se tu o l’agente disciplinate la chiamata — non un flush-per-approvazione integrato |
Impostare auto_retain su false disabilita la conservazione automatica. Non aggiunge un dialogo di approvazione umana prima di ogni scrittura. L’agente può ancora chiamare hindsight_retain quando i suoi strumenti lo consentono; considera il retain esplicito come acquisizione deliberata, non una coda pendente.
Il vuoto della coda di approvazione
Un desiderio comune è una coda pendente di memorie candidate che rividi e approvi prima che entrino nella banca. Hindsight sotto Hermes non fornisce quel contratto oggi. Mnemosyne per Hermes implementa scritture staged specifiche del provider in alcune versioni; quel percorso non è uno standard condiviso di Hermes e non si applica al plugin di Hindsight. Finché non esiste un flusso di approvazione upstream, il pattern fattibile è auto_retain: false, hindsight_retain deliberato e ispezione o cancellazione nell’UI del piano di controllo di Hindsight prima che la prossima sessione dipenda da un fatto sbagliato. Non esiste una chiave mancante write_approval per Hindsight da cercare in config.json.
Steering della banca (missioni, etichette, direttive, modelli mentali)
Le persone spesso chiamano il livello successivo “finetuning.” In Hindsight è per lo più configurazione della banca, non solo config.json di Hermes: missioni e impostazioni di estrazione indirizzano cosa retain mantiene; le etichette strutturano le entità; le direttive e i modelli mentali formano la successiva sintesi.
| Controllo | Dove vive | Come aiuta |
|---|---|---|
Missione retain (retain_mission / Hermes bank_retain_mission) |
Config della banca | “Presta attenzione a X, ignora Y” in linguaggio normale iniettato nell’estrazione |
Modalità di estrazione (concise, verbose, custom, …) |
Config della banca | concise (predefinito) mantiene fatti degni di lungo termine; custom sostituisce le regole integrate via retain_custom_instructions |
| Etichette entità | Config della banca | Lessico controllato chiave:valore al momento del retain → collegamenti a grafo e tag opzionali; migliora la struttura del recupero, non rifiuta di per sé affermazioni errate |
| Direttive (“regole dure”) | API direttive della banca | Istruzioni esplicite applicate durante reflect (scope di tag); vincolano la sintesi, non un gate di approvazione della scrittura |
| Modelli mentali | API modello mentale della banca | Risposte permanenti a domande ricorrenti, aggiornate via reflect da memorie corrispondenti; derivate, quindi fatti sorgente cattivi le avvelenano ancora |
| Missione reflect / osservazioni | Config della banca | Indirizza sintesi e consolidamento, non il flusso grezzo di retain |
Missioni, estrazione concisa ed etichette riducono il rumore e migliorano il recupero. Non sostituiscono l’attivazione di auto-retain quando l’accuratezza conta più della completezza. Preferisci una breve missione retain che nomina decisioni di progetto durevoli e ignora la logistica della chat; aggiungi etichette entità solo quando hai una tassonomia reale; aggiungi modelli mentali per due o tre domande ricorrenti dopo che la banca contiene già fatti puliti.
Profilo di igiene raccomandato
Un punto di partenza concreto per una banca personale di Hermes:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
Sulla banca, imposta una missione retain e lascia l’estrazione in modalità concise (tramite il piano di controllo o l’API delle Banche). Dopo un retain esplicito, apri la UI, conferma l’osservazione e cancella gli errori prima che si esegua il consolidamento o l’aggiornamento del modello mentale. Lascia recall_prefetch_method a recall — reflect spende una chiamata al modello di chat prima di ogni turno e inietta la sintesi anziché i fatti sottostanti.
Collega l’Agente Hermes a Hindsight
Sulla VM di Hermes, installa il plugin del catalogo, quindi esegui la procedura guidata di configurazione. Seleziona Hindsight e la modalità local_external; il plugin non ha bisogno di avviare PostgreSQL incorporato o eseguire lo stack di modelli di Hindsight in locale, e local_embedded avvia un secondo daemon di Hindsight accanto al contenitore che hai appena eseguito.
hermes plugins install hindsight
hermes memory setup hindsight
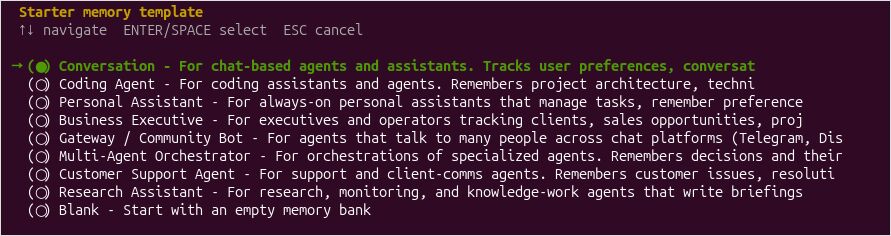
Ci sarà un interessante set di opzioni per il ruolo dell’agente usando hindsight
hermes memory status
La connessione esterna a Hindsight vive in ~/.hermes/hindsight/config.json. Una configurazione illustrativa che mantiene l’acquisizione continua (predefiniti di Hermes) è:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Per il retain solo esplicito e lo steering della banca, usa il profilo di igiene in Controlla Cosa Viene Ricordato anziché lasciare auto_retain attivo. recall_sync: false priorizza la reattività interattiva ma può iniettare il contesto richiamato nel turno successivo. Usa il recall sincrono quando la richiesta attuale deve incorporare le ultime memorie prima che il modello inizi a rispondere. retain_async: true evita di bloccare le risposte ordinarie mentre le memorie vengono elaborate.
Il predefinito di recall del plugin è solo osservazioni; i fatti grezzi di mondo ed esperienza restano nella banca e fuori dal prompt finché il consolidamento non ha scritto un’osservazione, o finché non allarghi recall_types a observation,world,experience. Allargarlo per la prima settimana e osservare il piano di controllo, poi restringere, è un ordine ragionevole.
La memoria integrata di Hermes resta attiva accanto al provider; mantenere MEMORY.md e USER.md attivi mentre impari cosa aggiunge Hindsight va bene, e l’articolo sul sistema di memoria è il luogo per decidere se i file piatti devono restare.
Riavvia il gateway se è già in esecuzione:
hermes gateway restart
hermes memory status
Lo stato dovrebbe identificare Hindsight come provider attivo. Per un riferimento comandi più ampio, incluso la TUI e i comandi plugin di Hermes, vedi la scheda rapida CLI dell’agente Hermes.
Convalida la Memoria, Non Solo l’Installazione
Chiedi a Hermes di ricordare un fatto monouso su un progetto di test, avvia un’altra sessione e chiedi di nuovo per quel fatto. La ritenzione è asincrona per impostazione predefinita e l’estrazione aspetta sul modello di chat, quindi dai al principale server llama.cpp un momento prima di giudicare. Quindi testa un caso più difficile:告诉a Hermes che una decisione precedente è cambiata e chiedi quale decisione è attuale e perché. Controlla la UI di Hindsight e le osservazioni conservate invece di dare per scontato che memory status provi che ingestione e recall sono corretti.
Se la risposta torna vuota, ispeziona il piano di controllo prima di cambiare modelli. Un retain può avere successo e comunque essere invisibile al recall mentre recall_types è solo osservazioni e il consolidamento non si è eseguito — allargare recall_types è il primo controllo. Una connessione rifiutata nel log del server di embedding significa che il contenitore non può raggiungere la porta di embedding, e i punteggi di reranker tutti a zero significano che il GGUF è la conversione sbagliata.
Le scelte del percorso di scrittura (auto_retain, missioni, vuoto di approvazione) sono coperte in Controlla Cosa Viene Ricordato.
Troubleshooting e Note Operative
| Sintomo | Causa probabile | Primo controllo |
|---|---|---|
| Hermes dice provider non disponibile | URL local_external errato o regola di rete |
curl http://HINDSIGHT_VM_IP:8888/health |
| Docker avvia, errori PostgreSQL | Estensione mancante, credenziali errate o memoria condivisa insufficiente | Log del contenitore e pg_extension |
| Embedding restituiscono 401 o 404 | URL OpenAI-compatibile errato, nome variabile ambiente errato o mismatch alias modello | Test diretto /v1/embeddings e nomi variabili |
| Reranking fallisce | Mismatch endpoint o formato di risposta, incluso percorso /rerank doppio |
Test diretto /v1/rerank e log del contenitore |
| Recall non restituisce nulla di utilizzabile | recall_types limitato alle osservazioni, o punteggi reranker zero |
Piano di controllo, poi recall_types, poi conversione reranker |
| Banca esistente riporta mismatch dimensionale | Modello di embedding cambiato | Ricostruisci vettori/reimporta con un modello coerente |
| Risposte Hermes rallentate | Recall sincrono o contesa LLM condiviso | Disattiva recall sync; limita concorrenza retain |
| Memorie non rilevanti si ripetono | Estrazione debole, recupero rumoroso o consolidamento insufficiente | Ispeziona osservazioni e punteggi di rilevanza |
Un piccolo deploy pratico è 2-4 vCPUs e 4-6 GB di RAM per la VM di Hindsight quando PostgreSQL e tutta l’inferenza sono esterni. L’allocazione su disco dipende ancora dall’immagine Docker scelta e dai layer immagine conservati; alloca circa 30-40 GB inizialmente con spazio per espandere. Dimensiona l’host PostgreSQL basato sul volume di memoria reale, le prestazioni di archiviazione e gli altri database che serve.
Esegui il backup e il ripristino della banca Hindsight
La banca di memoria è l’unica cosa che conta, e vive in PostgreSQL. Nell’Opzione B è un database che amministri; nell’Opzione A è il volume denominato pg0 incorporato nel contenitore. Effettua il backup indipendentemente dal contenitore di Hindsight — ricreare il contenitore senza prima catturare il volume o il database scarta la banca, e hermes backup non raggiunge una banca in esecuzione in un servizio separato.
Opzione B — PostgreSQL esterno. Scarica il database hindsight in formato custom, poi ripristinalo in un database scratch per verificare l’archivio prima di fidarti di esso:
pg_dump -h POSTGRES_IP -U hindsight -Fc hindsight > hindsight-bank.dump

# ripristina in un database scratch per provare che il dump sia utilizzabile
createdb -h POSTGRES_IP -U postgres hindsight-verify
pg_restore -h POSTGRES_IP -U postgres -d hindsight-verify hindsight-bank.dump
Conferma l’estensione pgvector e un sample di recall esistano nella copia ripristinata prima di cancellare il bersaglio del dump originale. Mantieni il dump su un host diverso dalla VM di Hindsight, ed eseguilo come amministratore PostgreSQL (un ruolo che può creare database) anziché il ruolo dell’applicazione.
Opzione A — contenitore tutto-in-uno. Il database incorporato è un volume denominato, quindi ferma il contenitore e tarcheggia il volume attraverso un’immagine usa-e-getta:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
Il punto di montaggio all’interno del contenitore tar (/data) è arbitrario; semplicemente alias il volume denominato in modo che tar possa leggerlo. Per ripristinare, ferma il contenitore, svuota il volume e scatta l’archivio di nuovo in esso, oppure punta il contenitore al ripristino da PostgreSQL esterno dall’Opzione B.
Fai uno snapshot in tre momenti anziché su una pianificazione calendario: prima di cambiare il modello di embedding, prima di un upgrade maggiore di Hindsight o PostgreSQL, e prima di un passaggio reflect o consolidamento che riscrive la banca. Un backup che hai ripristinato in una banca scratch vale più di uno che hai solo scritto.
Esporta, importa e migra la banca di memoria
Backup e ripristino proteggono la banca sul posto. Export/import la sposta tra istanze di Hindsight, ed è ciò che un cambio di modello ti forza effettivamente a fare.
Cambiare il modello di embedding non è un’edit di configurazione. I vettori nella banca sono stati calcolati con il vecchio modello, e un modello diverso — per esempio l’embedder BGE incluso a 384 dimensioni rispetto a Qwen3-Embedding-0.6B a 1024 dimensioni — scrive in uno spazio diverso e di solito una larghezza diversa. Non puoi ridirigere l’istanza esistente al nuovo embedder e mantenere i vecchi vettori; le dimensioni devono essere ricalcolate ri-embeddando ogni memoria con il nuovo modello di embedding.
Perché l’embedder e la sua configurazione sono impostati per istanza di Hindsight, il percorso pulito è stabilire una nuova istanza con la nuova configurazione di embedding e migrare la banca in essa, anziché ricostruire i vettori all’interno di quella che sta già servendo il recall. L’API di Hindsight può anche spostare la banca, ma per un cambio one-off l’export/import è il percorso più semplice e ispezionabile:
# esporta la banca dall'istanza vecchia
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# importa la banca nella nuova istanza
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t verifica l’archivio prima di spedirlo alla nuova istanza. Dopo l’import, ridirigi Hermes all’api_url della nuova istanza in ~/.hermes/hindsight/config.json, riavvia il gateway ed esegui la convalida della memoria di prima: un fatto ritenuto dovrebbe richiamare attraverso il nuovo embedder. Lascia la vecchia banca e i suoi vettori nell’istanza vecchia finché la nuova non si comporta, in modo che tu abbia ancora un fallback funzionante.
Monitora, pota e mantieni la banca stabile
Con la banca in esecuzione, il lavoro quotidiano è guardare cosa il modello di estrazione ha deciso di conservare e mantenere lo stato derivato sotto controllo. Usa l’UI del piano di controllo (hindsight-embed -p hermes ui start) per ispezionare osservazioni, punteggi di rilevanza e output di consolidamento invece di dare per scontato che memory status provi che ingestione e recall sono corretti. Memorie duplicate o obsolete sono di solito un’estrazione debole o un consolidamento poco eseguito, quindi correggi il tier di estrazione o la cadenza di consolidamento prima di allargare il recupero.
Due trappole di manutenzione vale la pena testare prima di fidarti della banca. Primo, cancellare un’osservazione non garantisce che ogni rappresentazione derivata scompaia con essa — un fatto reflect o un bordo di grafo costruito da essa può sopravvivere alla cancellazione, quindi verifica la cancellazione da capo a fine, la stessa preoccupazione di provenienza coperta in cicli di memoria auto-rafforzanti. Secondo, mantieni HINDSIGHT_API_WORKER_ID stabile tra le ricreazioni e fissa un tag di immagine specifico: un task che era in corso quando il contenitore è morto resta bloccato sotto il vecchio worker id, e un tag in movimento è una cattiva scelta per un database che intendi mantenere.
