
Open WebUI: Interfaccia per LLM self-hosted
Alternativa auto-gestita a ChatGPT per LLM locali
Open WebUI è un’interfaccia web self-hosted potente, estensibile e ricca di funzionalità per l’interazione con i grandi modelli linguistici.
Alternativa auto-gestita a ChatGPT per LLM locali
Open WebUI è un’interfaccia web self-hosted potente, estensibile e ricca di funzionalità per l’interazione con i grandi modelli linguistici.
Installa, distribuisci e ottimizza vLLM nel 2026
vLLM è un motore di inferenza e serving ad alto throughput ed efficiente in termini di memoria per i Large Language Models (LLM), sviluppato dal Sky Computing Lab dell’UC Berkeley.
Riflessioni sui modelli LLM per Cognee autoospitati
Scegliere il miglior LLM per Cognee richiede di bilanciare la qualità della costruzione del grafo, i tassi di allucinazione e i vincoli hardware. Cognee eccelle con modelli più grandi a bassa allucinazione (32B+) tramite Ollama ma le opzioni di dimensioni medio-piccole funzionano per le configurazioni più leggere.
Confronta i migliori strumenti locali per l'hosting di LLM nel 2026. Maturità delle API, supporto hardware, tool calling e casi d'uso nel mondo reale.
Eseguire LLM in locale è ora pratico per sviluppatori, startup e persino per team aziendali. Ma la scelta dello strumento giusto — Ollama, vLLM, LM Studio, LocalAI o altri — dipende dai tuoi obiettivi:
Configurare le dimensioni del contesto in Docker Model Runner con soluzioni alternative
Configurazione delle dimensioni del contesto in Docker Model Runner è più complessa di quanto dovrebbe essere.
Abilita l'accelerazione GPU per Docker Model Runner con supporto NVIDIA CUDA
Docker Model Runner è lo strumento ufficiale di Docker per eseguire modelli AI in locale, ma abilitare l’accelerazione GPU di NVidia in Docker Model Runner richiede una configurazione specifica.
Riferimento rapido per i comandi di Docker Model Runner
Docker Model Runner (DMR) è la soluzione ufficiale di Docker per eseguire modelli AI localmente, introdotta nel aprile 2025. Questo foglio di riferimento fornisce un rapido riferimento per tutti i comandi essenziali, le configurazioni e le best practice.
Confronta Docker Model Runner e Ollama per LLM locali
Running large language models (LLMs) locally ha guadagnato popolarità per la privacy, il controllo dei costi e le capacità offline. Il panorama si è notevolmente modificato nel aprile 2025 quando Docker ha introdotto Docker Model Runner (DMR), la sua soluzione ufficiale per il deployment di modelli AI.
Integrazione di Ollama con Go: guida SDK, esempi e migliori pratiche per la produzione.
Questa guida fornisce una panoramica completa delle Go SDK per Ollama disponibili e ne confronta le funzionalità.
+ Esempi Specifici Utilizzando LLM Pensanti
In questo post, esploreremo due modi per connettere la tua applicazione Python a Ollama: 1. Attraverso l’HTTP REST API; 2. Attraverso la libreria ufficiale Python di Ollama.
La mia opinione sullo stato attuale dello sviluppo di Ollama
Ollama è rapidamente diventato uno dei strumenti più popolari per eseguire LLM in locale. La sua semplice CLI e la gestione snella dei modelli lo hanno reso l’opzione preferita dagli sviluppatori che desiderano lavorare con i modelli AI al di fuori del cloud.
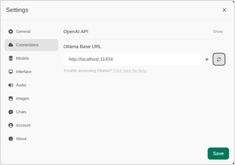
Panoramica rapida delle interfacce utente più prominenti per Ollama nel 2025
Locally hosted Ollama consente di eseguire modelli linguistici di grandi dimensioni sul proprio computer, ma l’utilizzo tramite riga di comando non è particolarmente utente-friendly. Ecco diversi progetti open-source che forniscono interfacce simili a ChatGPT che si connettono a un Ollama locale.
qwen3 8b, 14b e 30b, devstral 24b, mistral small 24b
In questo test sto confrontando come diversi LLM ospitati su Ollama traducono una pagina Hugo dall’inglese al tedesco.
Breve lista di fornitori di LLM
L’uso degli LLM non è molto costoso, potrebbe non esserci bisogno di acquistare un nuovo GPU fantastico. Ecco un elenco se LLM provider in the cloud con gli LLM che ospitano.
Confronto tra due modelli deepseek-r1 e due modelli base
DeepSeek’s prima generazione di modelli di ragionamento con prestazioni paragonabili a quelle di OpenAI-o1, inclusi sei modelli densi distillati da DeepSeek-R1 basati su Llama e Qwen.
Aggiornata l'elenco dei comandi di Ollama: ls, ps, run, serve, ecc.
Questa scheda rapida CLI di Ollama si concentra sui comandi che utilizzi ogni giorno (ollama ls, ollama serve, ollama run, ollama ps, gestione dei modelli e workflow comuni), con esempi che puoi copiare/incollare.