
Open WebUI: Interfaccia per LLM self-hosted
Alternativa auto-gestita a ChatGPT per LLM locali
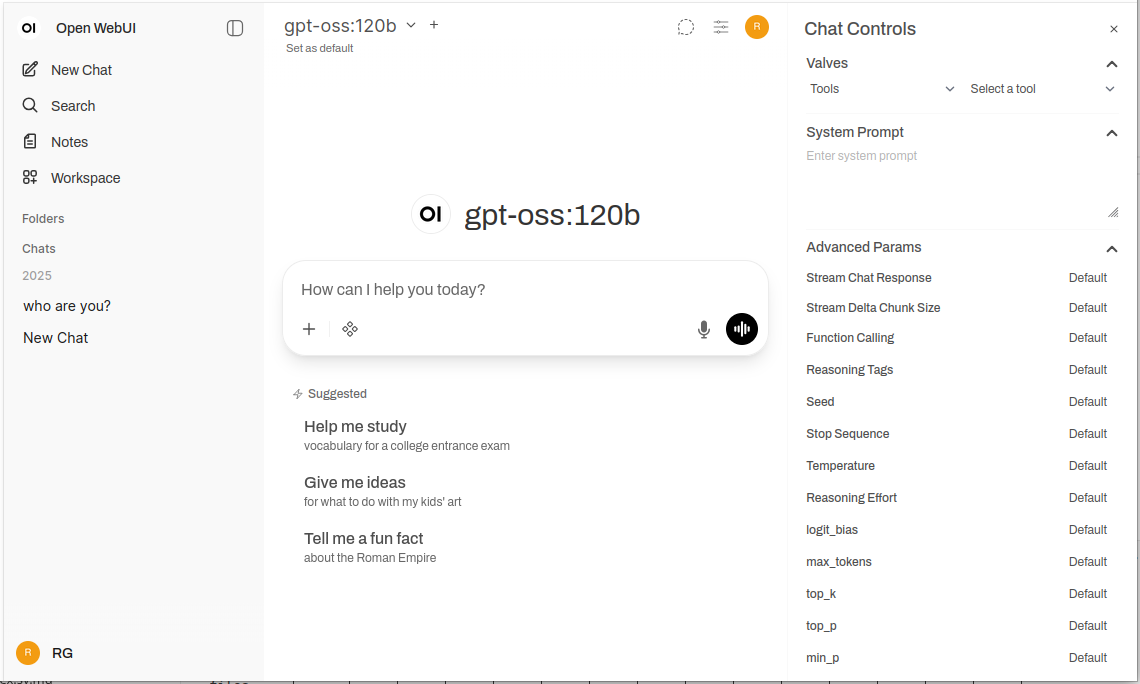
Open WebUI è un’interfaccia web self-hosted potente, estensibile e ricca di funzionalità per l’interazione con i grandi modelli linguistici.
Supporta Ollama e qualsiasi API compatibile con OpenAI, portando l’esperienza familiare di ChatGPT nella tua infrastruttura con privacy completa, capacità offline e funzionalità di livello enterprise. Per un confronto più ampio dei backend LLM locali e cloud—Ollama, vLLM, Docker Model Runner, LocalAI e provider cloud—consulta LLM Hosting: Infrastruttura Locale, Self-Hosted e Cloud Confrontata
Cos’è Open WebUI?
Open WebUI è un’applicazione web self-hosted open source che fornisce un’interfaccia di chat moderna per l’interazione con i grandi modelli linguistici. A differenza dei servizi di IA basati su cloud, Open WebUI funziona interamente sulla tua infrastruttura, offrendoti il controllo completo sui tuoi dati, sulle conversazioni e sulla selezione dei modelli.
Sebbene Open WebUI venga comunemente utilizzato con Ollama (e a volte sia informalmente chiamato “Ollama WebUI”), in realtà è una piattaforma indipendente dal backend. Può connettersi all’API di Ollama per l’esecuzione di modelli locali, ma supporta anche qualsiasi endpoint compatibile con OpenAI—inclusi vLLM, LocalAI, LM Studio, Text Generation WebUI e persino provider cloud. Questa flessibilità rende Open WebUI una soluzione completa che supporta più backend, RAG (Generazione Aumentata dal Recupero) per la chat sui documenti, autenticazione multi-utente, capacità vocali e ampie opzioni di personalizzazione. Che tu stia eseguendo modelli su un portatile, un server domestico o un cluster Kubernetes, Open WebUI si adatta alle tue esigenze.
Perché scegliere Open WebUI?
Privacy First: Tutti i dati restano sulla tua infrastruttura—nessuna conversazione, documento o prompt lascia la tua rete a meno che tu non configuri esplicitamente API esterne.
Capacità Offline: Perfetto per ambienti air-gapped, reti restrittive o situazioni in cui l’accesso a internet è inaffidabile o vietato. In abbinata a modelli eseguiti localmente tramite Ollama o vLLM, si ottiene una completa indipendenza dai servizi cloud.
Ricca di Funzionalità: Nonostante sia self-hosted, Open WebUI compete con le offerte commerciali grazie al caricamento di documenti e RAG, cronologia delle conversazioni con ricerca semantica, template di prompt e condivisione, gestione dei modelli, input/output vocale, design mobile-responsive e temi scuri/chiari.
Supporto Multi-Utente: Sistema di autenticazione integrato con controllo degli accessi basato su ruoli (admin, user, pending), dashboard di gestione utenti, isolamento delle conversazioni e prompt e modelli condivisi tra i team.
Guida Rapida all’Installazione
Il modo più rapido per iniziare con Open WebUI è utilizzare Docker. Questa sezione copre gli scenari di deployment più comuni.
Installazione di Base (Connessione a Ollama Esistente)
Se hai già Ollama in esecuzione sul tuo sistema, usa questo comando:
docker run -d \
  -p 3000:8080 \
  -v open-webui:/app/backend/data \
  --name open-webui \
  --restart always \
  ghcr.io/open-webui/open-webui:main
Questo esegue Open WebUI sulla porta 3000, persistendo i dati in un volume Docker. Accedilo all’indirizzo http://localhost:3000.
Installazione Integrata (Open WebUI + Ollama)
Per una configurazione all-in-one completa con Ollama incluso:
docker run -d \
  -p 3000:8080 \
  --gpus all \
  -v ollama:/root/.ollama \
  -v open-webui:/app/backend/data \
  --name open-webui \
  --restart always \
  ghcr.io/open-webui/open-webui:ollama
Il flag --gpus all abilita l’accesso alla GPU per un’inferenza più rapida. Omettilo se stai eseguendo solo CPU.
Configurazione con Docker Compose
Per i deployment di produzione, Docker Compose offre una migliore manutenibilità:
version: '3.8'

services:
  ollama:
    image: ollama/ollama:latest
    ports:
      - "11434:11434"
    volumes:
      - ollama:/root/.ollama
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    ports:
      - "3000:8080"
    environment:
      - OLLAMA_BASE_URL=http://ollama:11434
    volumes:
      - open-webui:/app/backend/data
    depends_on:
      - ollama
    restart: always

volumes:
  ollama:
  open-webui:
Fai il deploy con docker-compose up -d.
Deployment Kubernetes
Per i deployment enterprise, Open WebUI fornisce chart Helm:
helm repo add open-webui https://helm.openwebui.com/
helm repo update
helm install open-webui open-webui/open-webui \
  --set ollama.enabled=true \
  --set ingress.enabled=true \
  --set ingress.host=chat.yourdomain.com
Questo crea un deployment pronto per la produzione con archiviazione persistente, health check e configurazione ingress opzionale.
Approfondimento delle Funzionalità Principali
RAG e Chat sui Documenti
L’implementazione RAG di Open WebUI ti consente di caricare documenti e farli consultare dal modello nelle conversazioni. Il sistema divide automaticamente i documenti in frammenti (chunk), genera embedding, li archivia in un database vettoriale e recupera il contesto pertinente quando poni domande.
Formati supportati: PDF, DOCX, TXT, Markdown, CSV e altri tramite parser integrati.
Uso: Fai clic sul pulsante ‘+’ in una chat, seleziona ‘Carica File’, scegli i tuoi documenti e inizia a fare domande. Il modello citerà i passaggi rilevanti e i numeri di pagina nelle sue risposte.
Configurazione: Puoi regolare dimensione dei chunk, sovrapposizione, modello di embedding e parametri di recupero nelle impostazioni di amministrazione per le prestazioni ottimali con i tuoi tipi di documenti.
Autenticazione e Gestione Multi-Utente
Open WebUI include un completo sistema di autenticazione adatto per l’uso da parte di team e organizzazioni:
- Autenticazione locale: Nome utente/password con hashing sicuro delle password
- Integrazione OAuth/OIDC: Connettiti a provider di identità esistenti (Google, GitHub, Keycloak, ecc.)
- LDAP/Active Directory: Integrazione directory enterprise
- Accesso basato su ruoli: Admin (controllo completo), User (accesso standard), Pending (richiede approvazione)
Gli amministratori possono gestire gli utenti, monitorare l’utilizzo, configurare l’accesso ai modelli per utente/gruppo e impostare le politiche di ritenzione delle conversazioni.
Input e Output Vocale
Il supporto integrato per l’interazione vocale rende Open WebUI accessibile e comodo:
- Trascrizione da voce a testo: Utilizza Web Speech API o servizi STT esterni configurati
- Sintesi vocale da testo a voce: Supportati più motori TTS (basati su browser, Coqui TTS, ElevenLabs, ecc.)
- Supporto lingue: Funziona con più lingue a seconda della tua configurazione TTS/STT
Strumenti di Prompt Engineering
Open WebUI fornisce strumenti robusti per la gestione dei prompt:
- Libreria di prompt: Salva i prompt frequentemente utilizzati come template
- Variabili e segnaposto: Crea prompt riutilizzabili con contenuti dinamici
- Condivisione dei prompt: Condividi i prompt efficaci con il tuo team
- Versioning dei prompt: Traccia le modifiche e i miglioramenti nel tempo
Gestione dei Modelli
Facile commutazione e gestione dei modelli tramite l’interfaccia:
- Catalogo dei modelli: Sfoglia e scarica i modelli direttamente dalla libreria di Ollama
- Modelli personalizzati: Carica e configura modelli GGUF personalizzati
- Parametri del modello: Regola temperatura, top-p, lunghezza del contesto e altri parametri di campionamento per conversazione
- Metadati del modello: Visualizza dettagli del modello, dimensione, quantizzazione e capacità
Configurazione e Personalizzazione
Variabili di Ambiente
Opzioni di configurazione chiave tramite variabili di ambiente:
# URL Backend (Ollama o altra API compatibile con OpenAI)
OLLAMA_BASE_URL=http://localhost:11434

# Abilita autenticazione
WEBUI_AUTH=true

# Ruolo utente predefinito (user, admin, pending)
DEFAULT_USER_ROLE=pending

# Abilita registrazione utenti
ENABLE_SIGNUP=true

# Email admin (crea automaticamente account admin)
WEBUI_ADMIN_EMAIL=admin@example.com

# Database (default SQLite, o PostgreSQL per la produzione)
DATABASE_URL=postgresql://user:pass@host:5432/openwebui

# Abilita RAG
ENABLE_RAG=true

# Modello di embedding per RAG
RAG_EMBEDDING_MODEL=sentence-transformers/all-MiniLM-L6-v2
Connessione a Backend Alternativi
Open WebUI funziona con qualsiasi API compatibile con OpenAI. Configura l’URL base in Impostazioni → Connessioni:
- vLLM:
http://localhost:8000/v1 - LocalAI:
http://localhost:8080 - LM Studio:
http://localhost:1234/v1 - Text Generation WebUI:
http://localhost:5000/v1 - OpenAI:
https://api.openai.com/v1(richiede chiave API) - Azure OpenAI: URL endpoint personalizzato
Configurazione del Reverse Proxy
Per i deployment di produzione, esegui Open WebUI dietro un reverse proxy:
Esempio Nginx:
server {
    listen 443 ssl http2;
    server_name chat.yourdomain.com;

    ssl_certificate /path/to/cert.pem;
    ssl_certificate_key /path/to/key.pem;

    location / {
        proxy_pass http://localhost:3000;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        # Supporto WebSocket
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
    }
}
Esempio Traefik (etichette Docker):
labels:
  - "traefik.enable=true"
  - "traefik.http.routers.openwebui.rule=Host(`chat.yourdomain.com`)"
  - "traefik.http.routers.openwebui.entrypoints=websecure"
  - "traefik.http.routers.openwebui.tls.certresolver=letsencrypt"
  - "traefik.http.services.openwebui.loadbalancer.server.port=8080"
Ottimizzazione delle Prestazioni
Tuning del Database
Per i deployment multi-utente, passa da SQLite a PostgreSQL:
# Installa le dipendenze
pip install psycopg2-binary

# Configura l'URL del database
DATABASE_URL=postgresql://openwebui:password@postgres:5432/openwebui
PostgreSQL gestisce meglio gli utenti concorrenti e offre prestazioni di query migliorate per la ricerca nelle conversazioni e le operazioni RAG.
Selezione del Modello di Embedding
Le prestazioni del RAG dipendono fortemente dalla scelta del modello di embedding:
- Veloce/Risorse limitate:
all-MiniLM-L6-v2(384 dimensioni, ~80MB) - Equilibrato:
all-mpnet-base-v2(768 dimensioni, ~420MB) - Migliore qualità:
bge-large-en-v1.5(1024 dimensioni, ~1.3GB)
Configura in Impostazioni → RAG → Modello di Embedding.
Strategie di Caching
Abilita la cache delle conversazioni per ridurre le chiamate API ripetute:
- Cache dei modelli: Ollama memorizza automaticamente in cache i modelli caricati nella memoria
- Cache delle risposte: Open WebUI può memorizzare in cache i prompt identici (configurabile)
- Cache degli embedding: Riutilizza gli embedding per documenti precedentemente elaborati
Best Practices di Sicurezza
Quando si distribuisce Open WebUI in produzione, segui queste linee guida di sicurezza:
- Abilita l’autenticazione: Non eseguire mai Open WebUI senza autenticazione su reti pubbliche
- Usa HTTPS: Distribuisci sempre dietro un reverse proxy con TLS/SSL
- Aggiornamenti regolari: Mantieni Open WebUI e Ollama aggiornati per le patch di sicurezza
- Restringi l’accesso: Usa regole firewall per limitare l’accesso alle reti di fiducia
- Chiavi API sicure: Se ti connetti ad API esterne, usa variabili di ambiente, non hardcodare mai le chiavi
- Log di audit: Abilita e monitora i log di accesso per attività sospette
- Backup dei dati: Effettua regolarmente backup del volume
/app/backend/data - Cifratura del database: Abilita la cifratura a riposo per PostgreSQL in produzione
- Rate limiting: Configura i limiti di frequenza per prevenire l’abuso
- Filtraggio dei contenuti: Implementa politiche di contenuto appropriate per la tua organizzazione
Casi d’Uso e Applicazioni nel Mondo Reale
Assistente di Conoscenza Personale
Combina Open WebUI con modelli locali e RAG per creare una base di conoscenza privata. Carica i tuoi appunti, articoli di ricerca, documentazione di progetto e documenti personali. Interrogali conversazionalmente senza inviare dati ai servizi cloud—perfetto per ricercatori, studenti e lavoratori della conoscenza che valorizzano la privacy.
Collaborazione dei Team di Sviluppo
Distribuisci Open WebUI per il tuo team di sviluppo con accesso condiviso a documentazione tecnica, specifiche API e conoscenza della codebase. La funzionalità RAG consente agli sviluppatori di trovare rapidamente informazioni pertinenti tra migliaia di pagine di documenti, mentre la cronologia delle conversazioni aiuta a tracciare le decisioni architetturali e le discussioni tecniche.
Chatbot Interno per Enterprise
Le organizzazioni possono distribuire Open WebUI dietro il loro firewall con integrazione SSO, fornendo ai dipendenti un assistente di IA che ha accesso a wiki interni, politiche e procedure. L’accesso basato su ruoli garantisce che le informazioni sensibili restino adeguatamente segmentate, mentre i controlli di amministrazione mantengono governance e conformità.
Istruzione e Formazione
Le istituzioni educative utilizzano Open WebUI per fornire assistenza AI a studenti e facoltà senza preoccupazioni di privacy. Carica materiale didattico, libri di testo e appunti delle lezioni per domande e risposte contestualizzate. Il sistema multi-utente consente il monitoraggio dell’utilizzo mantenendo i dati degli studenti privati.
Applicazioni Sanitarie e Legali
Nei settori regolamentati in cui la privacy dei dati è cruciale, Open WebUI abilita flussi di lavoro assistiti da IA mantenendo la conformità HIPAA o GDPR. I professionisti medici possono interrogare database di farmaci e protocolli di trattamento, mentre i team legali possono cercare precedenti giudiziari e contratti—tutto senza che i dati lascino l’infrastruttura controllata.
Ambienti Air-Gapped e Offline
Gli enti governativi, le strutture di ricerca e i centri operativi sicuri utilizzano Open WebUI in reti air-gapped. La completa capacità offline garantisce che l’assistenza AI rimanga disponibile anche senza connettività a internet, cruciale per ambienti classificati o località remote.
Risoluzione dei Problemi Comuni
Problemi di Connessione
Problema: Open WebUI non riesce a connettersi a Ollama
Soluzione: Verifica che Ollama sia in esecuzione (curl http://localhost:11434), controlla la variabile di ambiente OLLAMA_BASE_URL e assicurati che le regole firewall consentano la connessione. Per i deployment Docker, usa i nomi dei servizi (http://ollama:11434) invece di localhost.
Problema: I modelli non appaiono nell’interfaccia
Soluzione: Conferma che i modelli sono installati (ollama list), aggiorna l’elenco dei modelli nelle impostazioni di Open WebUI e controlla la console del browser per errori API.
Problemi di Caricamento Documenti e RAG
Problema: Il caricamento dei documenti fallisce
Soluzione: Controlla i limiti di dimensione del file nelle impostazioni, verifica il formato di file supportato, assicurati che ci sia spazio su disco adeguato nel volume dati e rivedi i log dei container per errori di parsing.
Problema: Le risposte RAG non fanno riferimento ai documenti caricati
Soluzione: Verifica che il modello di embedding sia scaricato e in esecuzione, controlla le impostazioni della dimensione dei chunk (prova chunk più piccoli per una migliore granularità), aumenta il numero di chunk recuperati nelle impostazioni RAG e assicurati che la query sia pertinente al contenuto dei documenti.
Problemi di Prestazione
Problema: Tempi di risposta lenti
Soluzione: Abilita l’accelerazione GPU se disponibile, riduci la dimensione del modello o usa versioni quantizzate, aumenta OLLAMA_NUM_PARALLEL per le richieste concorrenti e alloca più RAM ai container Docker.
Problema: Errori di memoria esaurita
Soluzione: Usa modelli più piccoli (7B invece di 13B parametri), riduci la lunghezza del contesto nei parametri del modello, limita gli utenti concorrenti o aggiungi più RAM/spazio swap al tuo sistema.
Autenticazione e Accesso
Problema: Non riesci ad accedere o creare l’account admin
Soluzione: Imposta WEBUI_AUTH=true, configura WEBUI_ADMIN_EMAIL per la creazione automatica dell’admin, cancella cookie e cache del browser e controlla i log dei container per errori del database.
Problema: Gli utenti non riescono a registrarsi
Soluzione: Verifica ENABLE_SIGNUP=true, controlla l’impostazione DEFAULT_USER_ROLE (usa user per l’approvazione automatica o pending per l’approvazione manuale) e assicurati che il database sia scrivibile.
Alternative a Open WebUI
Sebbene Open WebUI eccella nel fornire un’interfaccia self-hosted con un’integrazione forte di Ollama, diverse alternative offrono approcci diversi alla stessa area problematica. La tua scelta dipende da se hai bisogno di flessibilità multi-provider, gestione di documenti specializzati, estrema semplicità o funzionalità enterprise.
LibreChat spicca come la soluzione più indipendente dal provider, offrendo supporto nativo per OpenAI, Anthropic, Azure OpenAI, Google Vertex AI, AWS Bedrock e Ollama in un’unica interfaccia. La sua architettura a plugin e le funzionalità enterprise come multi-tenancy, controlli di accesso dettagliati e quote di utilizzo lo rendono ideale per le organizzazioni che devono supportare più provider di IA o richiedono registri di audit sofisticati. Il compromesso è la complessità—LibreChat richiede più sforzi di configurazione e risorse più pesanti rispetto a Open WebUI, e il suo supporto Ollama sembra secondario rispetto ai provider cloud. Se il tuo team usa Claude per la scrittura, GPT-4 per il coding e modelli locali per lavori sensibili alla privacy, l’interfaccia unificata di LibreChat brilla.
Per i flussi di lavoro intensivi su documenti, AnythingLLM adotta un approccio knowledge-base-first che va oltre il RAG di base. Il suo modello di workspace organizza documenti e conversazioni in ambienti isolati, mentre le funzionalità di avanzate di recupero includono ricerca ibrida, reranking e tracciamento delle citazioni. I connettori di dati prelevano contenuti da GitHub, Confluence e Google Drive, e le capacità agent abilitano il ragionamento multi-step e l’automazione dei flussi di lavoro. Questo rende AnythingLLM eccellente per gli studi di consulenza che gestiscono basi di conoscenza per più clienti o per i team di supporto che lavorano con documentazione estesa. L’interfaccia di chat è meno rifinita rispetto a Open WebUI, ma se interrogare grandi collezioni di documenti è la tua necessità primaria, le capacità di recupero sofisticate giustificano la curva di apprendimento più ripida.
LobeChat dà priorità all’esperienza utente rispetto alla profondità delle funzionalità, offrendo un’interfaccia elegante, mobile-friendly con capacità di app web progressiva. Il suo design moderno, le animazioni fluide e il forte supporto vocale/multimodale lo rendono popolare tra i designer e gli utenti non tecnici che vogliono un assistente IA che funzioni perfettamente su più dispositivi. L’implementazione PWA fornisce un’esperienza mobile simile a un’app che Open WebUI non eguaglia. Tuttavia, le funzionalità enterprise sono limitate, l’ecosistema di plugin è più piccolo e le capacità RAG sono in ritardo sia rispetto a Open WebUI che a AnythingLLM.
Per gli utenti che preferiscono le applicazioni desktop, Jan.ai fornisce installer cross-platform (Windows, macOS, Linux) con gestione dei modelli locali senza configurazione. Non c’è bisogno di installare Ollama separatamente o gestire Docker—Jan incorpora tutto in un’app nativa con supporto system tray e download di modelli con un clic. Questa filosofia “funziona subito” rende Jan ideale per fornire LLM locali a familiari o colleghi che non sono a proprio agio con gli strumenti da riga di comando. I compromessi sono la mancanza di supporto multi-utente, meno funzionalità avanzate e nessuna capacità di accesso remoto.
Chatbox occupa la nicchia leggera—a un client cross-platform minimale che supporta OpenAI, Claude, Gemini e API locali con un sovraccarico di risorse molto basso. È perfetto per gli sviluppatori che hanno bisogno di testare rapidamente diversi provider di API o per gli utenti con hardware a risorse limitate. L’attrito di configurazione è minimo, ma alcune funzionalità sono riservate agli abbonati, non è completamente open source e il supporto RAG è limitato.
Esistono diversi UI minimali specifici per Ollama per gli utenti che vogliono “abbastanza” interfaccia: Hollama gestisce più server Ollama su macchine diverse, Ollama UI fornisce chat di base e caricamento PDF con un deployment estremamente facile, e Oterm offre un’interfaccia basata su terminal sorprendentemente capace per sessioni SSH e flussi di lavoro tmux. Questi sacrificano funzionalità per semplicità e velocità.
Per le organizzazioni che richiedono supporto del vendor, le opzioni commerciali come TypingMind Team, BionicGPT e Dust.tt offrono self-hosting con supporto professionale, certificazioni di conformità e SLA. Sostituiscono la libertà open source per uptime garantito, audit di sicurezza e responsabilità—appropriato quando la tua organizzazione ha bisogno di contratti di supporto di livello enterprise.
Scegliere con saggezza: Open WebUI colpisce il punto di equilibrio per la maggior parte dei deployment self-hosted di Ollama, bilanciando funzionalità complete con una complessità gestibile. Scegli LibreChat quando la flessibilità dei provider è primaria, AnythingLLM per flussi di lavoro documentali sofisticati, LobeChat per utenti mobile-first o attenti al design, Jan per utenti desktop non tecnici, o opzioni commerciali quando hai bisogno di supporto vendor. Per la maggior parte degli utenti tecnici che eseguono modelli locali, lo sviluppo attivo, la forte community e l’eccellente implementazione RAG di Open WebUI lo rendono il punto di partenza consigliato.
Sviluppi Futuri e Roadmap
Open WebUI continua un rapido sviluppo con diverse entusiasmanti funzionalità sulla roadmap:
Supporto multimodale migliorato: Gestione migliore di immagini, modelli vision e conversazioni multi-modal con modelli come LLaVA e Bakllava.
Capacità agent migliorate: Function calling, uso di tool e flussi di lavoro di ragionamento multi-step simili ai pattern AutoGPT.
Migliori app mobili: Applicazioni native iOS e Android oltre all’attuale implementazione PWA per un’esperienza mobile migliorata.
Funzionalità RAG avanzate: RAG basato su grafo, chunking semantico, recupero multi-query e recupero di documenti padre per un contesto migliore.
Funzionalità collaborative: Conversazioni condivise, workspace di team e collaborazione in tempo reale su prompt e documenti.
Integrazioni enterprise: Supporto SSO più profondo, provisioning SCIM, log di audit avanzati e report di conformità per settori regolamentati.
Il progetto mantiene la compatibilità retroattiva e la versione semantica, rendendo gli upgrade straightforward. Il repository GitHub attivo vede commit giornalieri e una gestione responsive delle issue.
Conclusione
Open WebUI si è evoluto da un semplice frontend di Ollama in una piattaforma completa per interazioni IA self-hosted. La sua combinazione di privacy, funzionalità e facilità di deployment lo rende un’ottima scelta per individui, team e organizzazioni che vogliono sfruttare i LLM locali senza sacrificare capacità.
Che tu sia uno sviluppatore che testa modelli, un’organizzazione che costruisce strumenti IA interni o un individuo che dà priorità alla privacy, Open WebUI fornisce le basi per flussi di lavoro IA self-hosted potenti. La community attiva, gli aggiornamenti regolari e l’architettura estensibile assicurano che rimarrà un’opzione leader nello spazio IA self-hosted.
Inizia con l’installazione Docker di base, sperimenta con il RAG caricando alcuni documenti, prova modelli diversi dalla libreria di Ollama ed esplora gradualmente le funzionalità avanzate man mano che le tue esigenze crescono. La curva di apprendimento è dolce, ma il soffitto è alto—Open WebUI scala da un portatile personale a un cluster Kubernetes enterprise.
Per chi confronta alternative, il design Ollama-first, il set di funzionalità equilibrato e lo sviluppo attivo di Open WebUI lo rendono il punto di partenza consigliato per la maggior parte dei deployment LLM self-hosted. Puoi sempre migrare a soluzioni più specializzate se emergono esigenze specifiche, ma molti utenti trovano le capacità di Open WebUI sufficienti per il loro intero viaggio dalla sperimentazione alla produzione. Per vedere come i backend tipici di Open WebUI (Ollama, vLLM, ecc.) si adattano a Docker Model Runner, LocalAI e provider cloud, consulta la nostra guida LLM Hosting: Infrastruttura Locale, Self-Hosted e Cloud Confrontata
Link Utili
Quando si configura il tuo ambiente Open WebUI, trarrai vantaggio dalla comprensione dell’ecosistema più ampio di hosting e opzioni di deployment dei LLM locali. La guida completa Local LLM Hosting: Guida Completa 2025 - Ollama, vLLM, LocalAI, Jan, LM Studio & Altro confronta 12+ strumenti LLM locali inclusi Ollama, vLLM, LocalAI e altri, aiutandoti a scegliere il backend ottimale per il tuo deployment Open WebUI in base alla maturità dell’API, alle capacità di tool calling e ai benchmark di prestazione.
Per i deployment di produzione ad alte prestazioni in cui throughput e latenza sono cruciali, esplora la guida vLLM Quickstart: Serving LLM ad Alte Prestazioni, che copre la configurazione di vLLM con Docker, la compatibilità API OpenAI e l’ottimizzazione PagedAttention. Questo è particolarmente prezioso se Open WebUI serve più utenti concorrenti e le prestazioni di Ollama diventano un collo di bottiglia.
Se preferisci un backend multimodale che gestisce chat, embedding, generazione di immagini e audio tramite un’unica server compatibile con OpenAI, la LocalAI QuickStart copre l’installazione Docker, la configurazione della galleria modelli e la configurazione API — tutto collegabile a Open WebUI tramite l’URL base http://localhost:8080.
Comprendere come il tuo backend gestisce le richieste concorrenti è cruciale per la pianificazione della capacità. L’articolo Come Ollama Gestisce le Richieste Parallele spiega l’attesa delle richieste di Ollama, la gestione della memoria GPU e il modello di esecuzione concorrente, aiutandoti a configurare limiti e aspettative appropriati per gli scenari multi-utente del tuo deployment Open WebUI.
Se stai valutando se il loop di ricerca agentica di Open WebUI è “abbastanza profondo” per il tuo carico di lavoro di ricerca, Self-Hosted Deep Research Systems: 12 Strumenti Confrontati colloca l’approccio basato su modello di Open WebUI accanto a motori di ricerca dedicati come GPT Researcher, Onyx e DeerFlow.
Risorse Esterne
Per la documentazione ufficiale e il supporto della community, fai riferimento a queste risorse esterne:
