Selfhosting

Клонирование виртуальной машины в Virt-Manager с помощью virt-clone и virt-sysprep

Клонирование виртуальной машины в Virt-Manager с помощью virt-clone и virt-sysprep

Клонирование ВМ копирует байты, а не идентичность.

Virt-Manager (графический интерфейс для libvirt) копирует диск KVM и присваивает клону новый UUID и MAC-адрес. Гость сохраняет свой machine-id и ключи SSH-хоста, пока virt-sysprep не очистит их.
Альтернативы S3 для self-hosted в 2026 году (RustFS, Garage, SeaweedFS, Ceph)

Альтернативы S3 для self-hosted в 2026 году (RustFS, Garage, SeaweedFS, Ceph)

Выбор самохостеджного S3 после MinIO

Amazon S3 стала де-факто стандартом API для объектного хранилища. После того, как репозиторий открытого исходного кода MinIO был архивирован в апреле 2026 года, осталось семь заслуживающих доверия самодостаточных альтернатив.

Сравнение SEO-плагинов для WordPress: от Yoast до Local AI

Сравнение SEO-плагинов для WordPress: от Yoast до Local AI

Плагины SEO для WordPress: от Yoast к локальному ИИ

Плагины SEO для WordPress добавляют метаданные, карты сайта, схему и AI-слой поверх ядра WordPress, и в 2026 году этот слой включает плагины, выполняющие инференс на вашем собственном оборудовании.

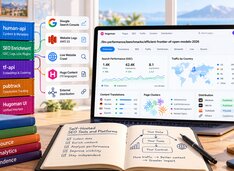
Самостоятельно хостируемые SEO-инструменты и платформы: руководство по open source

Самостоятельно хостируемые SEO-инструменты и платформы: руководство по open source

Открытый код для SEO за пределами плагинов WordPress

Самообслуживаемый SEO теперь охватывает пауки, дашборды Search Console, трекеры позиций, MCP-серверы и локальный ИИ. В этом руководстве сравниваются основные платформы с открытым исходным кодом и то, какие функции работают без платных SEO API.

Самохостинговые системы глубокого исследования: сравнение 12 инструментов

Самохостинговые системы глубокого исследования: сравнение 12 инструментов

Самостоятельно размещаемые агенты, способные к исследованиям за пределами поиска

Deep Research стал самостоятельной категорией программного обеспечения, а не просто моделью, связанной с поисковой строкой. Эта статья сравнивает двенадцать систем для самостоятельного развёртывания (self-hosted) и архитектуры исследований, лежащих в их основе.

Mnemosyne для агента Hermes: быстрое начало работы с локальной памятью

Mnemosyne для агента Hermes: быстрое начало работы с локальной памятью

Локальная память Hermes с контролируемой записью.

Mnemosyne — это локальный провайдер памяти для Hermes Agent, который хранит рабочую память, структурированные факты, временные данные и эпизодическую историю в локальной базе SQLite — без хостинг-сервисов, без обязательных сетевых вызовов и с исключительно детальным контролем записи.

Самоусиливающиеся петли памяти в ИИ-агентах: причины и способы исправления

Самоусиливающиеся петли памяти в ИИ-агентах: причины и способы исправления

«Когда осмысленные выводы превращаются в новые доказательства.»

Персистентная память превращает агента из инструмента, которому каждый раз приходится объяснять контекст, в систему, способную передавать этот контекст дальше. Однако это открывает сценарий сбоя, которого нет в stateless-чат-режиме: интерпретация может стать частью памяти, извлекаться как факт и обосновывать более сильную версию самой себя.

Как безопасно выполнить миграцию с OpenClaw на Hermes Agent

Как безопасно выполнить миграцию с OpenClaw на Hermes Agent

Безопасный перевод, выходящий за рамки однострочного импорта

Миграция ИИ-ассистента — это не то же самое, что копирование конфигурации приложения. Сложная часть заключается в сохранении идентичности, памяти, поведения инструментов, запланированных задач и доступа к сообщениям без возникновения ситуации, когда два шлюза (gateway) работают как один и тот же бот.

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

«Когда llama-server превосходит Ollama»

Ollama и llama.cpp часто сравнивают, будто бы это конкурирующие движки вывода. Настоящий выбор — между управляемым сервисом моделей и набором инструментов, которым вы управляете напрямую.

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

Выберите правильный AMD-бэкенд для каждого движка

ROCm и Vulkan обе ускоряют работу GPU AMD для локального размещения LLM, но они не взаимозаменяемы. Правильный выбор зависит от движка, графического процессора и характера нагрузки.

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

Почему контекст 128K не работает на 16 ГБ

Модель может заявлять о поддержке контекстного окна в 128K, но проваливаться уже на 40K токенах на видеокарте с 16 ГБ. Архитектурный потолок никогда не обещал, что веса, KV-кэш, вычислительные буферы и системный композитор смогут одновременно уместиться на вашем устройстве.

Гравитация данных: реальная стоимость API-first ИИ

Гравитация данных: реальная стоимость API-first ИИ

«Почему ваш AI-стек становится всё более «липким» каждый месяц»

Каждый вызов API кажется простой транзакцией - пока их накопится достаточно много, и ваши данные для дообучения, системы оценки и схемы инструментов не начнут формироваться вокруг одного вендора, после чего смена провайдера перестанет быть простой сменой маршрутизации.

Обслуживание LLM Wiki: дрейф, противоречия и рецензирование

Обслуживание LLM Wiki: дрейф, противоречия и рецензирование

Обеспечьте достоверность скомпилированных знаний

Неудача в использовании LLM Wiki наступает тогда, когда старые факты остаются правдоподобными, противоречия становятся гладкими, а сгенерированные резюме отдаляются от своих источников.

Syncthing для синхронизации файлов в системах самостоятельного хостинга знаний

Syncthing для синхронизации файлов в системах самостоятельного хостинга знаний

Частная синхронизация для локальных знаний.

Syncthing синхронизирует файлы между устройствами, которыми вы управляете, что делает его одним из самых практичных инструментов для создания собственной инфраструктуры знаний, позволяющей избежать привязки к облачным сервисам.

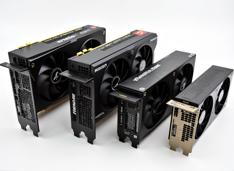
GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

Сравнение AI-GPU от трёх производителей

Ландшафт аппаратных решений для ИИ значительно изменился в 2026 году: NVIDIA, AMD и Intel соревнуются за разработчиков, которым требуются GPU, способные запускать локальные большие языковые модели (LLM) и выполнять задачи инференса.

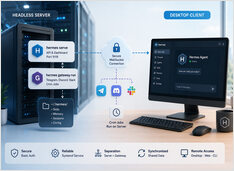
Агент Hermes: настройка безголового сервера и удалённого рабочего стола

Агент Hermes: настройка безголового сервера и удалённого рабочего стола

Сервер Headless Hermes с доступом по удаленному рабочему столу

Запуск агента Hermes на сервере без графического интерфейса (headless) при подключении с настольного клиента на другом компьютере требует наличия двух процессов на сервере и одного клиентского соединения.