
Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ
MTP и стандартная декодировка на RTX 4080 — реальные результаты тестов
Я протестировал производительность спекулятивного декодирования (Multi-Token Prediction, MTP) для моделей Qwen 3.6 27B и 35B на видеокарте RTX 4080 с 16 ГБ видеопамяти (VRAM).
Для более широкого обзора скоростей генерации токенов и компромиссов между видеопамятью для других моделей на том же оборудовании, см. Бенчмарки LLM на 16 ГБ VRAM с llama.cpp.
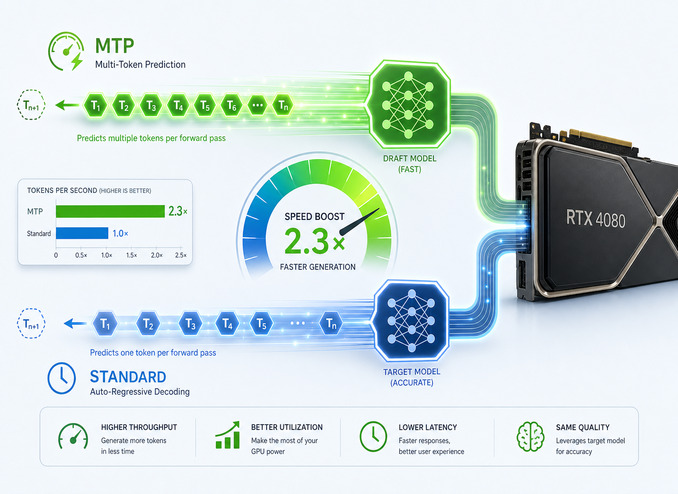
Что такое MTP (Multi-Token Prediction)
Multi-Token Prediction — это форма спекулятивного декодирования, встроенная непосредственно в контрольные точки (checkpoints) определенных моделей. Вместо предсказания одного токена за прямой проход, модель содержит дополнительные «MTP-головы», которые предлагают несколько будущих токенов за один шаг, а затем проверяют их параллельно. Если догадки принимаются, эффективная производительность повышается без изменения качества вывода.
Семейство Qwen 3.6 поставляется с файлами GGUF как в стандартном виде, так и в вариантах с поддержкой MTP. В llama.cpp функция MTP активируется с помощью:
--spec-type draft-mtp --spec-draft-n-max 3
--spec-draft-n-max — это ключевой параметр настройки. Он задает, сколько спекулятивных токенов предлагает MTP-голова на каждом шаге. Более высокие значения потенциально ускоряют работу, но требуют дополнительной видеопамяти для буферов черновиков — что является реальным ограничением для видеокарт с 16 ГБ.
Что и как я тестировал
Я протестировал, как две модели Qwen 3.6 ведут себя при включенном MTP и при стандартном декодировании на GPU с 16 ГБ VRAM (RTX 4080).
Чтобы веса модели и KV-кэш поместились в видеопамять, я использовал сильно квантованные варианты:
Qwen3.6-27B-UD-IQ3_XXSиQwen3.6-27B-UD-IQ3_XXS-MTPQwen3.6-35B-A3B-UD-IQ3_SиQwen3.6-35B-A3B-UD-IQ3_S-MTP
Для каждого запуска отслеживаются два бюджета контекста:
- Средний контекст (Avg Ctx) — размер контекста, при котором llama.cpp занимает около 14,8 ГБ VRAM, оставляя другим приложениям (Xorg, GNOME Shell, Cursor) комфортный запас в ~500 МБ.
- Максимальный контекст (Max Ctx) — максимальный размер контекста, который llama.cpp мог выделить, учитывая, что те же приложения рабочего стола уже занимают ~500 МБ VRAM.
Ключевая причина держать средний контекст на практическом целевом уровне состоит в том, что Hermes Agent — который я использую в качестве основного ИИ-ассистента, подключающегося к llama.cpp на этой машине — по умолчанию требует как минимум 64 К контекста и отклоняет модели с меньшим окном при запуске. Модели ниже этого порога не могут поддерживать достаточно рабочей памяти для многошаговых рабочих процессов с вызовом инструментов. Для llama.cpp это означает передачу параметра --ctx-size 65536 или больше. Таким образом, любая конфигурация MTP, которая значительно сжимает доступный средний контекст ниже 64 К, не подходит для повседневных задач Hermes, поэтому цифры Avg Ctx в таблицах ниже являются наиболее важными для принятия решений.
Были протестированы оба уровня квантования KV-кэша: q8 (более высокое качество, больше VRAM) и q5 (меньше VRAM, больший контекст). Обратите внимание, что переход от q8 к q5 KV-кэшу может вызвать заметное снижение качества — в моих тестах деградация была значительной, чтобы сделать q5 непригодным для моих задач. Цифры скорости и контекста для q5 включены ради полноты картины, но вы должны протестировать качество ответов на своих задачах, прежде чем окончательно перейти на него.
Qwen 3.6 27B MTP vs Стандартное декодирование
KV-кэш q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Стандартное (IQ3_XXS) | |
|---|---|---|---|---|---|
| Скорость промпта | 148 т/с | 151 т/с | 148 т/с | 147 т/с | 200 т/с |
| Скорость генерации | 65 т/с | 75 т/с | 73 т/с | 75 т/с | 45 т/с |
| Средний контекст | 40 K | 40 K | 40 K | 30 K | 80 K |
| Максимальный контекст | 60 K | 60 K | 60 K | 50 K | 100 K |
С q8 KV-кэшем, MTP с --spec-draft-n-max 2 обеспечивает ускорение генерации примерно на 67 % (75 против 45 т/с) ценой сокращения среднего окна контекста вдвое с 80 К до 40 К. Скорость обработки промпта падает с 200 до ~150 т/с, потому что MTP требует передач с устройства на хост во время фазы prefill.
KV-кэш q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Стандартное (IQ3_XXS) | |
|---|---|---|---|---|---|
| Скорость промпта | 145 т/с | 144 т/с | 141 т/с | 139 т/с | 191 т/с |
| Скорость генерации | 57 т/с | 62 т/с | 67 т/с | 66 т/с | 41 т/с |
| Средний контекст | 70 K | 60 K | 60 K | 50 K | 130 K |
| Максимальный контекст | 100 K | 100 K | 90 K | 80 K | 160 K |
Переключение на q5 KV-кэш восстанавливает значимый объем контекста: --spec-draft-n-max 1 дает средний контекст 70 К при 57 т/с — это ускорение генерации на 39 % по сравнению со стандартным декодированием, при этом окно контекста остается полезным. При --spec-draft-n-max 3 контекст падает до 60 К, но генерация достигает 67 т/с (+63 %).
Выводы по Qwen 3.6 27B
MTP действительно полезен для плотной модели 27B. Идеальная точка для 16 ГБ VRAM:
- q8 KV +
--spec-draft-n-max 2— лучшая сырая скорость (75 т/с), контекст падает до 40–60 К - q5 KV +
--spec-draft-n-max 1— лучший баланс скорости и контекста (57 т/с, средний контекст 70 К)
Qwen 3.6 35B MTP vs Стандартное декодирование
Модель 35B использует архитектуру Mixture-of-Experts (MoE) (35B-A3B означает 35B общих параметров, ~3B активных на токен). MoE-модели обычно получают больше пользы от MTP, поскольку разреженное маршрутирование делает MTP-голову вычислительно дешевой по сравнению с полным прямым проходом.
KV-кэш q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Стандартное (IQ3_S) | |
|---|---|---|---|---|---|
| Скорость промпта | 277 т/с | 277 т/с | 265 т/с | 275 т/с | 368 т/с |
| Скорость генерации | 186 т/с | 189 т/с | 180 т/с | 171 т/с | 146 т/с |
| Средний контекст | 15 K | 10 K | — | — | 80 K |
| Максимальный контекст | 80 K | 70 K | 60 K | 50 K | 150 K |
Архитектура MoE обеспечивает впечатляющую сырую скорость генерации с MTP (+27 % при max 1, +29 % при max 2 против стандартных 146 т/с). Но практическая проблема — это средний контекст. С q8 KV-кэшем даже --spec-draft-n-max 1 дает лишь 15 К среднего контекста — едва достаточно для скромных задач. Более глубокие уровни черновиков вообще не имеют жизнеспособного среднего контекста на карте с 16 ГБ.
Это центральный вопрос стоимости VRAM для MTP на потребительском оборудовании: дополнительные буферы черновиков напрямую съедают остаточный бюджет VRAM, а модель 35B-A3B с q8 KV-кэшем оставляет очень мало запаса.
KV-кэш q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Стандартное (IQ3_S) | |
|---|---|---|---|---|---|
| Скорость промпта | 264 т/с | 266 т/с | 270 т/с | 264 т/с | 343 т/с |
| Скорость генерации | 151 т/с | 147 т/с | 137 т/с | 131 т/с | 122 т/с |
| Средний контекст | 10 K | — | — | — | 120 K |
| Максимальный контекст | 120 K | 110 K | 110 K | 80 K | 200 K |
q5 KV-кэш лишь незначительно улучшает ситуацию со средним контекстом. --spec-draft-n-max 1 дает 10 К среднего контекста при 151 т/с. Стандартное декодирование на q5 дает 122 т/с при 120 К среднего контекста.
Выводы по Qwen 3.6 35B
На GPU с 16 ГБ MoE-модель 35B с MTP сталкивается с жестким ограничением: полезный средний контекст сжимается до 10–15 К токенов, что делает ее непрактичной для реальных рабочих нагрузок. Стандартное декодирование со скоростью 122–146 т/с и контекстом 80–120 К значительно более полезно.
Если у вас 24 ГБ+ VRAM, комбинация 35B + MTP становится гораздо привлекательнее — проблема окна контекста исчезает, и вы сохраняете преимущество в скорости.
Как выбрать правильное значение --spec-draft-n-max
Вопрос о том, сколько спекулятивных токенов предлагать на каждом шаге (--spec-draft-n-max), не имеет единственно правильного ответа — это зависит от архитектуры модели и доступной VRAM:
- Для 27B dense на 16 ГБ:
--spec-draft-n-max 2с q8 KV — самый быстрый вариант,--spec-draft-n-max 1с q5 KV — самый щадящий для контекста. - Для 35B MoE на 16 ГБ:
--spec-draft-n-max 1— единственный вариант, сохраняющий хоть какой-то полезный контекст, и то лишь незначительный. - Более высокие значения (
3,4) увеличивают давление на VRAM без пропорционального прироста скорости — при max 4 вы тратите примерно столько же дополнительной VRAM, сколько и при max 2, но скорость генерации не успевает.
Как включить MTP в llama.cpp
Убедитесь, что вы используете GGUF с поддержкой MTP (имя файла содержит MTP). Если вы новичок в флагах llama.cpp, статья Быстрый старт с llama.cpp с CLI и Server охватывает все основы. Затем запустите llama-server или llama-cli с параметрами:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 40000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Для q5 KV-кэша замените q8_0 на q5_1 или q5_0 и увеличьте --ctx-size:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 80000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 1
MTP активируется автоматически, как только llama.cpp обнаруживает MTP-головы в файле GGUF и установлен флаг --spec-type draft-mtp.
Поэтому стандартный Qwen3.6-27B-UD-IQ3_XXS.gguf не будет работать в режиме MTP, вам понадобится Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf.
Но Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf может работать как в режиме спекулятивного декодирования, так и в авторегрессионном.
Заключение
На GPU с 16 ГБ (RTX 4080), при использовании этих квантов, MTP в llama.cpp является явной выгодой для Qwen 3.6 27B и чистым минусом для Qwen 3.6 35B в практическом использовании:
Qwen 3.6 27B (IQ3_XXS) — MTP стоит того:
- q8 KV + MTP max 2 → генерация примерно на 67 % быстрее, контекст 40–60 К (против 80–100 К без MTP)
- q5 KV + MTP max 1 → генерация примерно на 39 % быстрее, контекст 70–100 К (против 130–160 К без MTP)
- Хороший баланс скорости и эффективности использования VRAM при
--spec-draft-n-max 2
Qwen 3.6 35B (IQ3_S) — MTP непрактичен на 16 ГБ:
- Скорость генерации выше на 27–29 %, но средний контекст сжимается до 10–15 К на q8 и 10 К на q5
- Стандартное декодирование со скоростью 122–146 т/с и контекстом 80–120 К более полезно для реальных задач
- Ситуация существенно улучшается при VRAM 24 ГБ+
На бумаге q5 KV-кэш — очевидный ответ для максимизации окна контекста при сохранении прироста скорости от MTP, — но на практике снижение качества при переходе от q8 к q5 может быть значительным. Протестируйте q5 на своих задачах, прежде чем принимать его; для моих рабочих нагрузок деградация была неприемлемой, и q8 с более жестким бюджетом контекста остается лучшим компромиссом.
Для более широкой картины вариантов раздачи LLM и инфраструктурных компромиссов, см. статью Размещение LLM в 2026 и Производительность LLM в 2026. Где находится класс 27B на спектре размеров и затрат 2026 года, и почему текущая сборка Qwen3.8-27B Q4 требует карты на 24 ГБ, в то время как измерения выше остаются на 16 ГБ, описано в статье Эффективная граница открытых моделей в 2026. Если вы настраиваете параметры сэмплера Qwen 3.6 в дополнение к MTP, полезным дополнением будет Справочник по параметрам агентного LLM-вывода для Qwen 3.6 и Gemma 4.
