NVIDIA

Эффективный фронтенд открытых моделей: поиск оптимального баланса в 2026 году

Эффективный фронтенд открытых моделей: поиск оптимального баланса в 2026 году

«Оптимальный размер открытых LLM в 2026 году: около 30 млрд параметров».

В сентябре 2026 года эффективная граница открытых моделей находится в диапазоне от 25 до 34 миллиардов параметров: агентская работа уровня, близкого к передовому, на одном GPU с 24 ГБ памяти, за малую долю стоимости оборудования класса 70B.
KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

Почему контекст 128K не работает на 16 ГБ

Модель может заявлять о поддержке контекстного окна в 128K, но проваливаться уже на 40K токенах на видеокарте с 16 ГБ. Архитектурный потолок никогда не обещал, что веса, KV-кэш, вычислительные буферы и системный композитор смогут одновременно уместиться на вашем устройстве.

GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

GPU для ИИ в 2026 году: сравнение NVIDIA, AMD и Intel

Сравнение AI-GPU от трёх производителей

Ландшафт аппаратных решений для ИИ значительно изменился в 2026 году: NVIDIA, AMD и Intel соревнуются за разработчиков, которым требуются GPU, способные запускать локальные большие языковые модели (LLM) и выполнять задачи инференса.

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

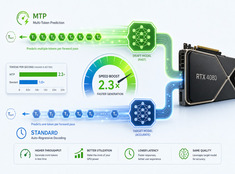
MTP и стандартная декодировка на RTX 4080 — реальные результаты тестов

Я протестировал производительность спекулятивного декодирования (Multi-Token Prediction, MTP) для моделей Qwen 3.6 27B и 35B на видеокарте RTX 4080 с 16 ГБ видеопамяти (VRAM).

Ollama в Docker Compose с использованием GPU и постоянным хранилищем моделей

Ollama в Docker Compose с использованием GPU и постоянным хранилищем моделей

Ollama-сервер с приоритетом композинга, поддержкой GPU и сохранением состояния.

Ollama отлично работает на «голом» железе. Но становится еще интереснее, если рассматривать его как сервис: стабильный конечный пункт, зафиксированные версии, постоянное хранилище данных и GPU, который либо доступен, либо нет.

Сравнение производительности LLM в Ollama на GPU с 16 ГБ VRAM

Сравнение производительности LLM в Ollama на GPU с 16 ГБ VRAM

Тест скорости LLM на RTX 4080 с 16 ГБ видеопамяти

Локальный запуск больших языковых моделей обеспечивает конфиденциальность, работу в автономном режиме и отсутствие затрат на API. Данный бенчмарк точно показывает, чего можно ожидать от 14 популярных LLM на Ollama на видеокарте RTX 4080.

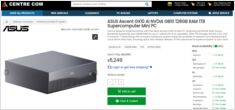
Ценообразование на DGX Spark AU: от 6249 до 7999 долларов в крупных розничных магазинах

Ценообразование на DGX Spark AU: от 6249 до 7999 долларов в крупных розничных магазинах

Актуальные цены в австралийских долларах от местных розничных продавцов уже доступны.

Компьютер NVIDIA DGX Spark (GB10 Grace Blackwell) поступил в продажу в Австралии у крупных розничных продавцов компьютеров с наличием на местных складах. Если вы следите за мировым ценообразованием и доступностью DGX Spark, то вам будет интересно узнать, что в Австралии цены варьируются от 6 249 до 7 999 австралийских долларов в зависимости от конфигурации накопителей и конкретного продавца.

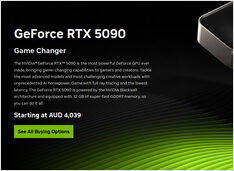
Цены на видеокарты NVidia RTX 5080 и RTX 5090 в Австралии — ноябрь 2025 года

Цены на видеокарты NVidia RTX 5080 и RTX 5090 в Австралии — ноябрь 2025 года

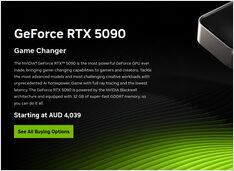
Цены на потребительские GPU, подходящие для ИИ: RTX 5080 и RTX 5090

Давайте сравним цены на топовые потребительские видеокарты, которые особенно подходят для LLM и искусственного интеллекта в целом. В частности, я изучаю цены на RTX-5080 и RTX-5090.

Кросс-модальные вложения: объединение модулей ИИ

Кросс-модальные вложения: объединение модулей ИИ

Объедините текст, изображения и аудио в общих пространствах встраивания

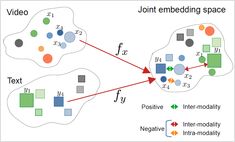
Кросc-модальные вложения представляют собой прорыв в искусственном интеллекте, позволяя понимать и анализировать различные типы данных в едином пространстве представления.

Инфраструктура искусственного интеллекта на потребительском оборудовании

Инфраструктура искусственного интеллекта на потребительском оборудовании

Развертывание корпоративного ИИ на бюджетном оборудовании с использованием открытых моделей.

Демократизация искусственного интеллекта уже здесь. С появлением открытых LLM, таких как Llama, Mistral и Qwen, которые теперь не уступают проприетарным моделям, команды могут создавать мощную инфраструктуру ИИ на потребительском оборудовании — значительно сокращая расходы при сохранении полного контроля над конфиденциальностью данных и развертыванием.

FLUX.1-Kontext-dev: ИИ для преобразования изображений

FLUX.1-Kontext-dev: ИИ для преобразования изображений

Модель ИИ для дополнения изображений текстовыми инструкциями

Black Forest Labs выпустила FLUX.1-Kontext-dev, продвинутую модель искусственного интеллекта для преобразования изображений, которая дополняет существующие изображения с помощью текстовых инструкций.