LLM Performance

Эффективный фронтенд открытых моделей: поиск оптимального баланса в 2026 году

Эффективный фронтенд открытых моделей: поиск оптимального баланса в 2026 году

«Оптимальный размер открытых LLM в 2026 году: около 30 млрд параметров».

В сентябре 2026 года эффективная граница открытых моделей находится в диапазоне от 25 до 34 миллиардов параметров: агентская работа уровня, близкого к передовому, на одном GPU с 24 ГБ памяти, за малую долю стоимости оборудования класса 70B.
KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

KV Cache на GPU с 16 ГБ: Как действительно уместить длинный контекст

Почему контекст 128K не работает на 16 ГБ

Модель может заявлять о поддержке контекстного окна в 128K, но проваливаться уже на 40K токенах на видеокарте с 16 ГБ. Архитектурный потолок никогда не обещал, что веса, KV-кэш, вычислительные буферы и системный композитор смогут одновременно уместиться на вашем устройстве.

Спекулятивное декодирование: ускорение инференса LLM на 20–50%

Спекулятивное декодирование: ускорение инференса LLM на 20–50%

Более быстрый инференс LLM без потери качества — практическое руководство

Модель 70B генерирует один токен за один прямой проход (forward pass), и каждый проход перезагружает веса из видеопамяти (VRAM), вычисляет внимание (attention) для всего контекста и синхронизирует память. Между токенами GPU простаивает, ожидая разрешения последовательных зависимостей.

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

Qwen 3.6 27B и 35B MTP против Standard на GPU 16 ГБ

MTP и стандартная декодировка на RTX 4080 — реальные результаты тестов

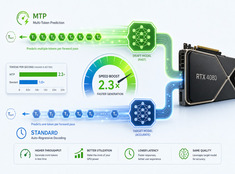
Я протестировал производительность спекулятивного декодирования (Multi-Token Prediction, MTP) для моделей Qwen 3.6 27B и 35B на видеокарте RTX 4080 с 16 ГБ видеопамяти (VRAM).

Валидация структурированного вывода LLM на Python, которая работает надёжно

Валидация структурированного вывода LLM на Python, которая работает надёжно

Перестаньте полагаться на интуицию. Валидируйте контракты.

Большинство руководств по «структурированному выводу» (structured output) для больших языковых моделей (LLM) не обладают должной серьезностью. Они учат вас вежливо просить модель выдавать JSON и затем надеяться, что она поступит правильно. Это не валидация. Это оптимизм, обернутый в фигурные скобки.

Справочник по параметрам агентного вывода LLM для Qwen и Gemma

Справочник по параметрам агентного вывода LLM для Qwen и Gemma

Справочное руководство по настройке агентов LLM

Эта страница представляет собой практическое руководство по настройке агентов на базе LLM (температура, top_p, top_k, штрафы и их взаимодействие в многоступенчатых рабочих процессах с интенсивным использованием инструментов).

Сравнение производительности LLM в Ollama на GPU с 16 ГБ VRAM

Сравнение производительности LLM в Ollama на GPU с 16 ГБ VRAM

Тест скорости LLM на RTX 4080 с 16 ГБ видеопамяти

Локальный запуск больших языковых моделей обеспечивает конфиденциальность, работу в автономном режиме и отсутствие затрат на API. Данный бенчмарк точно показывает, чего можно ожидать от 14 популярных LLM на Ollama на видеокарте RTX 4080.

BAML против Instructor: структурированные выходные данные LLM

BAML против Instructor: структурированные выходные данные LLM

Type-safe LLM outputs with BAML and Instructor

При работе с большими языковыми моделями (LLM) в производственной среде получение структурированных и типобезопасных выходных данных имеет критическое значение. Два популярных фреймворка — BAML и Instructor — предлагают разные подходы к решению этой задачи.

Сравнение производительности Ollama: NVIDIA DGX Spark против Mac Studio против RTX-4080

Сравнение производительности Ollama: NVIDIA DGX Spark против Mac Studio против RTX-4080

Бенчмарки GPT-OSS 120b на трёх платформах ИИ

Я выкопал некоторые интересные тесты производительности GPT-OSS 120b, работающего на Ollama на трех разных платформах: NVIDIA DGX Spark, Mac Studio и RTX 4080. Модель GPT-OSS 120b из библиотеки Ollama весит 65ГБ, что означает, что она не помещается в 16ГБ видеопамяти RTX 4080 (или более новой RTX 5080).

Специализированные АСИКи для LLM и чипы для инференса (почему они важны)

Специализированные АСИКи для LLM и чипы для инференса (почему они важны)

Специализированные интегральные схемы (ASIC) и кастомные чипы повышают скорость и эффективность работы LLM при инференсе.

Будущее ИИ заключается не только в более умных моделях. Оно также связано с кремнием, который соответствует тому, как эти модели фактически обслуживаются. Специализированное оборудование для инференса LLM движется по пути, напоминающему эволюцию майнинга биткоинов от GPU к цельным ASIC-устройствам, хотя ограничения здесь жёстче, поскольку модели и схемы точности продолжают развиваться.

Сравнение: Qwen3:30b vs GPT-OSS:20b

Сравнение: Qwen3:30b vs GPT-OSS:20b

Сравнение скорости, параметров и производительности этих двух моделей

Вот сравнение Qwen3:30b и GPT-OSS:20b с акцентом на следовании инструкциям и параметрах производительности, спецификациях и скорости.

Проблемы структурированного вывода в Ollama GPT-OSS

Проблемы структурированного вывода в Ollama GPT-OSS

Не очень приятно.

Модели GPT-OSS от Ollama (https://www.glukhov.org/ru/llm-performance/ollama/ollama-gpt-oss-structured-output-issues/ “Ollama GPT-OSS”) постоянно сталкиваются с проблемами при работе со структурированным выводом, особенно при использовании с фреймворками вроде LangChain, OpenAI SDK, vllm и другими.

Сравнение структурированного вывода популярных провайдеров LLM — OpenAI, Gemini, Anthropic, Mistral и AWS Bedrock

Сравнение структурированного вывода популярных провайдеров LLM — OpenAI, Gemini, Anthropic, Mistral и AWS Bedrock

Незначительно отличающиеся API требуют особого подхода.

Вот сравнение поддержки структурированного вывода (получение надежного JSON) от популярных провайдеров LLM вместе с минимальными примерами на Python