LLM Hosting

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

llama.cpp против Ollama в 2026 году: какой рантайм выбрать?

«Когда llama-server превосходит Ollama»

Ollama и llama.cpp часто сравнивают, будто бы это конкурирующие движки вывода. Настоящий выбор — между управляемым сервисом моделей и набором инструментов, которым вы управляете напрямую.
ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

ROCm и Vulkan для локального запуска LLM на GPU AMD: руководство на 2026 год

Выберите правильный AMD-бэкенд для каждого движка

ROCm и Vulkan обе ускоряют работу GPU AMD для локального размещения LLM, но они не взаимозаменяемы. Правильный выбор зависит от движка, графического процессора и характера нагрузки.

Гравитация данных: реальная стоимость API-first ИИ

Гравитация данных: реальная стоимость API-first ИИ

«Почему ваш AI-стек становится всё более «липким» каждый месяц»

Каждый вызов API кажется простой транзакцией - пока их накопится достаточно много, и ваши данные для дообучения, системы оценки и схемы инструментов не начнут формироваться вокруг одного вендора, после чего смена провайдера перестанет быть простой сменой маршрутизации.

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Ollama и vLLM: когда стоит мигрировать локальный LLM-сервер

Когда переходить с Ollama на vLLM

Ollama — один из самых простых способов запуска локальной языковой модели, но удобство может скрывать момент, когда локальный эксперимент превращается в общий сервис инференса, требующий лучшего планирования и наблюдаемости.

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Выгрузка всех моделей маршрутизатора llama.cpp без перезапуска

Свободная VRAM без остановки llama-server

Режим маршрутизации llama.cpp — одно из самых полезных изменений в llama-server за последние годы. Наконец-то локальным операторам LLM предоставляется опыт управления моделями, близкий к тому, к которому пользователи привыкли в Ollama, при этом сохраняются высокая производительность и низкоуровневый контроль, которые делают llama.cpp стоящими того, чтобы использовать их в первую очередь.

Быстрый старт с Vane (Perplexica 2.0) с использованием Ollama и llama.cpp

Быстрый старт с Vane (Perplexica 2.0) с использованием Ollama и llama.cpp

Самохостинговый ИИ-поиск с локальными LLM

Vane — один из наиболее прагматичных проектов в сегменте «AI-поиск со ссылками на источники»: самохостингуемый движок ответов, который сочетает живой веб-поиск с локальными или облачными LLM, сохраняя при этом полный контроль над всем стеком за вами.

TGI — Text Generation Inference: установка, настройка и устранение неполадок

TGI — Text Generation Inference: установка, настройка и устранение неполадок

Установите TGI, развертывайте быстро, отлаживайте ещё быстрее.

Text Generation Inference (TGI) обладает очень специфической энергетикой. Это не самый новый проект на улице инференса, но это тот, который уже научился, как происходит работа в продакшене, —

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Удалённый доступ к Ollama через Tailscale или WireGuard без открытия публичных портов.

Доступ к Ollama удаленно без открытых публичных портов

Ollama чувствует себя наиболее комфортно, когда с ним обращаются как с локальным демоном: CLI и ваши приложения взаимодействуют с локальным HTTP-интерфейсом (loopback), а остальная сеть даже не знает о его существовании.

Ollama в Docker Compose с поддержкой GPU и постоянным хранением моделей

Ollama в Docker Compose с поддержкой GPU и постоянным хранением моделей

Сервер Ollama с приоритетом композиции, поддержкой GPU и сохранением данных.

Ollama отлично работает на «голом железе». Всё становится ещё интереснее, когда вы начинаете относиться к нему как к сервису: стабильный эндпоинт, закреплённые версии, постоянное хранилище данных и GPU, который либо доступен, либо нет.

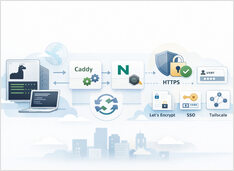
Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

Ollama за обратным прокси-сервером Caddy или Nginx для потоковой передачи через HTTPS

HTTPS для Ollama без нарушения потоковой передачи ответов.

Запуск Ollama через обратный прокси — самый простой способ обеспечить поддержку HTTPS, опциональный контроль доступа и предсказуемое поведение потоковой передачи данных.

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Запускайте открытые модели быстро с помощью SGLang.

SGLang — это высокопроизводительный фреймворк для развертывания больших языковых и мультимодальных моделей, созданный для обеспечения низколатентного и высокопроизводительного вывода на устройствах от одной GPU до распределенных кластеров.

Быстрый старт с обменом моделей llama для локальных LLM, совместимых с OpenAI

Быстрый старт с обменом моделей llama для локальных LLM, совместимых с OpenAI

Горячая замена локальных LLM без изменения клиентов.

Вскоре вы уже управляете несколькими инструментами: vLLM, llama.cpp и другими — каждый стек работает на своём собственном порту. При этом все последующие звенья цепочки по-прежнему ожидают один базовый URL /v1; иначе вам придётся постоянно перенастраивать порты, профили и разовые скрипты. llama-swap — это прокси для /v1, который размещается перед этими стеками.

Быстрый старт с LocalAI: запуск локальных LLM, совместимых с OpenAI

Быстрый старт с LocalAI: запуск локальных LLM, совместимых с OpenAI

Запустите собственные API, совместимые с OpenAI, с помощью LocalAI за несколько минут.

LocalAI — это самодостаточный сервер вывода с приоритетом на локальное использование, разработанный для работы как прямая замена OpenAI API для запуска ИИ-нагрузок на вашем собственном оборудовании (ноутбук, рабочая станция или сервер в центре обработки данных).

Быстрый старт с llama.cpp: CLI и сервер

Быстрый старт с llama.cpp: CLI и сервер

Запуск моделей GGUF в CLI и сервере

llama.cpp — это движок инференса на C/C++ для моделей в формате GGUF: llama-cli для интерактивного чата, llama-completion для скриптованных промптов и llama-server для HTTP API, совместимого с OpenAI.

Самостоятельное размещение LLM и суверенитет ИИ

Самостоятельное размещение LLM и суверенитет ИИ

Управляйте данными и моделями с помощью развернутых локально LLM

Хостинг больших языковых моделей (LLM) на собственных серверах обеспечивает контроль над данными, моделями и процессом инференса — это практический путь к суверенному искусственному интеллекту для команд, предприятий и целых стран.